
模型与 AI 网关总览
Agentbase v2.10.0 为企业级 AI 应用提供双层模型接入与治理体系:模型(LLM Gateway) 与 AI 网关(AI Gateway)。两套体系在项目内并存、职责边界清晰且互不接管——模型(LLM Gateway) 聚焦项目级模型供应商连接注册、预置模型目录同步、模型健康探测与平台内部 AI 引擎(知识库向量化、重排、记忆抽取、智能体工作台、可观测性评估)的底层算力供给;AI 网关(AI Gateway) 则面向多团队、多智能体生产环境提供带网关实例隔离的统一数据面入口,支持逻辑模型(Logical Model)动态路由、主备容灾切换、语义缓存(Semantic Cache)、安全护栏(Guardrail & OPA 策略)、多协议代理(OpenAI / Anthropic / MCP / A2A / HTTP Agent)以及细粒度 Token/QPS 预算治理。
功能概述
在企业级 AI 中台落地过程中,研发与架构团队通常面临两类截然不同的模型管理诉求:
项目底座算力连接(由「模型 / LLM Gateway」承载):
项目内的 知识库(Knowledge Base) 需要稳定的 Embedding 模型(如
text-embedding-v3)进行分块向量化、需要 Rerank 模型(如qwen3.7-text-rerank)执行多路召回精排、需要多模态视觉模型(如qwen-vl-max)完成扫描件与架构图解读,并需要大语言模型(如qwen-plus)驱动 GraphRAG 图谱抽取、RAPTOR 递归聚类、Wiki 编译及合成问答。记忆中心(Memory) 需要 Chat 与 Embedding 模型完成长期事实提取、画像归纳、上下文梦境重整(Dreaming)与技能蒸馏(Skill Distillation)。
智能体工作台(Agent Runtime) 与 可观测性评估(Observability Evaluations) 同样直接读取项目在「模型」页注册的 Provider 与模型目录。
同时,业务服务可通过签发项目级受限密钥(
abk_...)调用/v1/ai/chat/completions、/v1/ai/embeddings、/v1/ai/rerank、/v1/ai/messages等标准接口。
多网关实例生产流量治理(由「AI 网关 / AI Gateway」承载):
当企业将大模型与智能体能力暴露给外部业务线、合作伙伴或多租户终端时,需要在物理模型之上构建一层逻辑抽象(例如将主模型
qwen-plus与备选模型qwen-turbo封装为统一的逻辑模型lm-enterprise-chat)。需要对入站 Prompt 与出站生成结果执行统一的内容安全护栏(Guardrail Profile,如 PII 个人隐私脱敏、Prompt 注入防御、敏感词阻断)及 OPA 策略预检。
需要开启基于向量相似度的语义缓存(Semantic Cache),对高频重复咨询直接命中缓存返回,大幅降低首包延迟(TTFT)与 Token 成本。
需要按网关实例(如
/ai-gateway/g/gw_7194685489feb1e169548619/v1/...)统一纳管 MCP 工具审批、A2A 智能体调用、主体凭证(Principals & Credentials)及多周期硬性预算(Budgets)。
核心概念与架构
双层模型接入与治理架构图
以下架构图展示了 模型(LLM Gateway) 与 AI 网关(AI Gateway) 在 Agentbase 平台内部及外部业务调用链路中的协作关系:
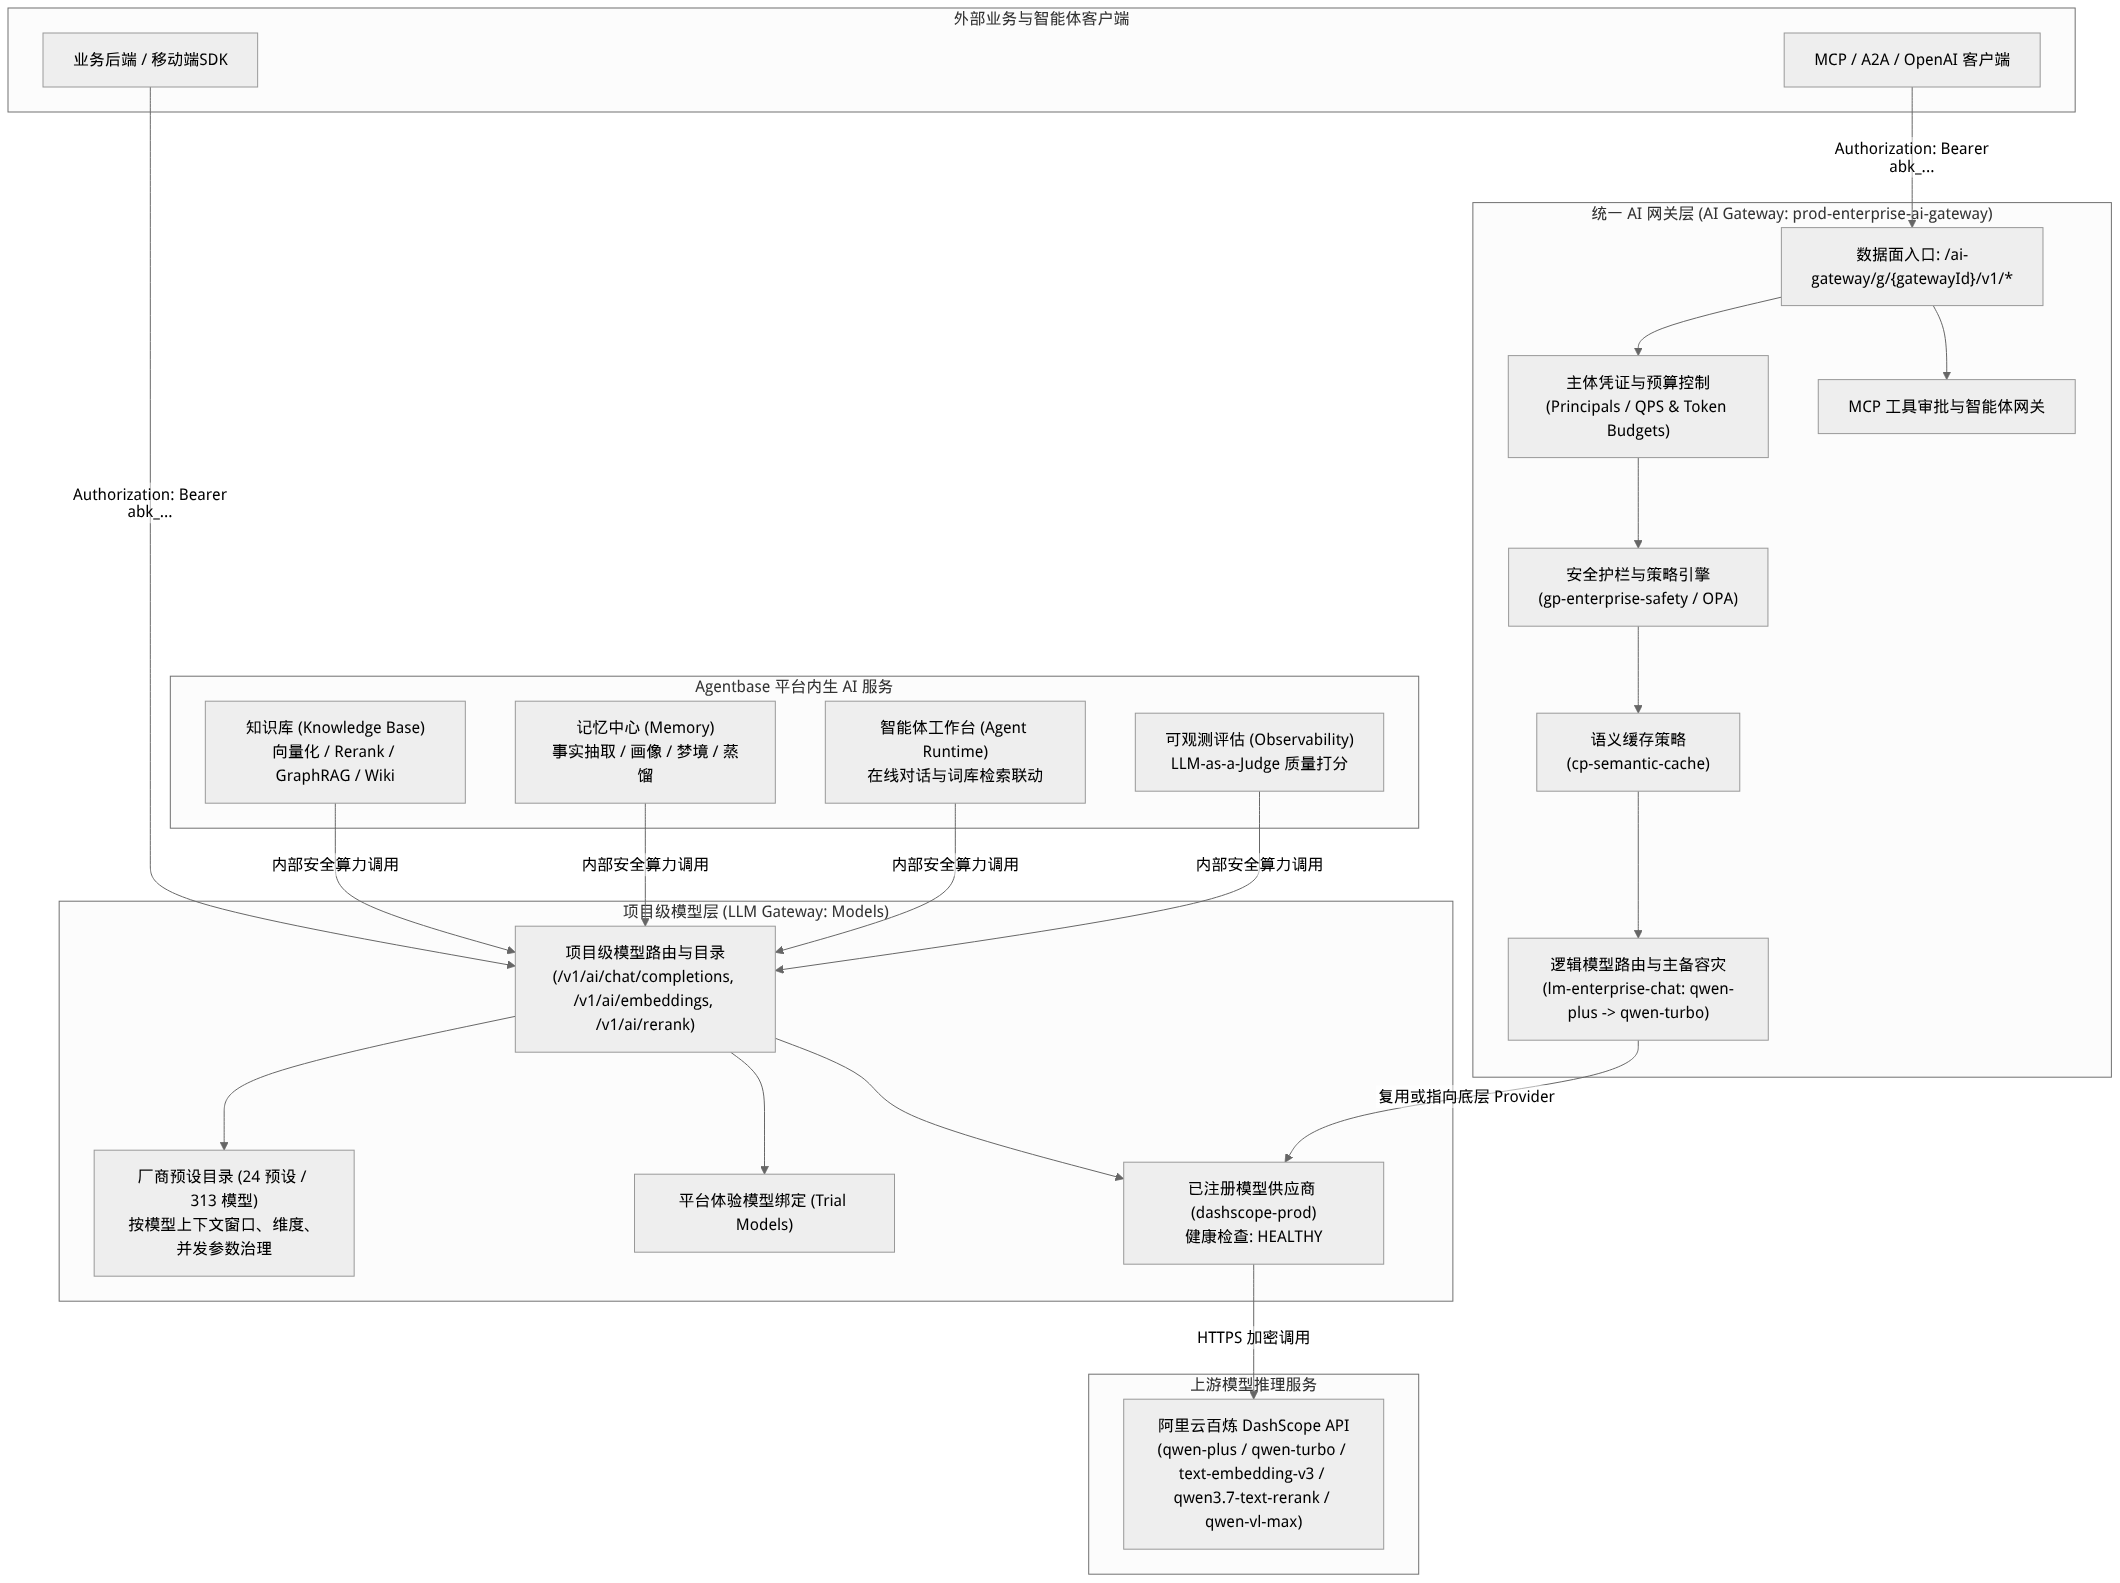
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
核心概念与能力对比表
| 维度 | 模型(LLM Gateway) | 统一 AI 网关(AI Gateway) |
|---|---|---|
| 控制台导航入口 | 项目左侧导航栏 模型(Models) | 项目左侧导航栏 AI 网关(AI Gateway) |
| 核心定位 | 项目级基础模型供应商连接池、模型目录与平台内部 AI 算力底座 | 多网关实例隔离的企业级 AI 流量网关、逻辑路由、护栏、缓存与工具治理面 |
| 默认启用状态 | 项目创建后默认启用(受项目设置中 AI Gateway 服务开关控制客户端访问) | 默认按需开启网关实例;与 LLM Gateway 并存且互不覆盖、互不接管 |
| 数据面请求路径 | /v1/ai/chat/completions、/v1/ai/embeddings、/v1/ai/rerank、/v1/ai/messages、/v1/ai/models | 强制携带网关实例 ID:/ai-gateway/g/{gatewayId}/v1/chat/completions、/responses、/embeddings、/rerank、/messages 及 /mcp、/a2a |
| 模型寻址方式 | 直接使用物理模型标识(如 qwen-plus、text-embedding-v3)或连接 ID + 模型名 | 支持逻辑模型(Logical Model)(如 lm-enterprise-chat),底层按权重与优先级路由至多个物理部署目标(Deployments) |
| 平台内生服务依赖 | 直接依赖:知识库、记忆、智能体工作台、可观测评估均从此处读取 Provider 配置 | 无耦合:启用或修改 AI Gateway 实例不会改变知识库或记忆模块的既有模型调用行为 |
| 安全与缓存策略 | 基础网关密钥(abk_...)白名单、月度 Token 上限与每分钟请求速率限制(RPM) | 完整的 安全护栏(Guardrail Profile)、语义缓存(Semantic Cache)、OPA 策略预演、工具审批状态机与多粒度预算控制 |
| 典型标杆配置 | 连接 dashscope-prod(接入 qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank、qwen-vl-max),网关密钥 gw-key-support-bot | 网关实例 prod-enterprise-ai-gateway(gw_7194685489feb1e169548619)、逻辑模型 lm-enterprise-chat、护栏 gp-enterprise-safety、缓存 cp-semantic-cache |
角色、入口与关联关系
角色与权限矩阵
在组织(如 Agentbase 企业智能中台,ID:69c6d1aa00062e6bb60)与项目(如 企业智能客服与知识中台,ID:enterprise-ai-hub-210)中,不同角色对两套系统的操作权限如下:
| 角色名称 | 模型(LLM Gateway)权限 | AI 网关(AI Gateway)权限 |
|---|---|---|
| Owner / Admin(组织所有者 / 管理员) | 完整权限:创建/编辑/删除 Provider、执行健康探测、签发与吊销 Gateway Key、查看全量 Token 账单 | 完整权限:创建网关实例、配置逻辑模型与部署目标、发布安全护栏与缓存策略、审批高危 MCP 工具、封存运行时快照 |
| Developer(研发人员) | 可查看已注册 Provider 与模型参数、执行健康探测、在知识库/记忆/智能体工作台中绑定模型、查看调用统计 | 可查看网关实例、调试逻辑模型路由、执行策略 Dry-Run 预演、查看流量与质量指标 |
网关密钥调用方(abk_... 客户端) | 仅允许调用被授权白名单内的模型执行端点(Chat / Embedding / Rerank),严禁访问管理面 API | 仅允许调用所绑定 gatewayId 下的数据面推理与工具端点,受主体预算与护栏策略实时约束 |
控制台入口与上下游关联
控制台入口路径:
模型(LLM Gateway):登录控制台 -> 选择项目
企业智能客服与知识中台 (enterprise-ai-hub-210)-> 左侧导航栏点击 模型(路由:/console/project-default-enterprise-ai-hub-210/llm-gateway)。AI 网关(AI Gateway):同一项目左侧导航栏点击 AI 网关(路由:
/console/project-default-enterprise-ai-hub-210/ai-gateway)。
与上下游模块的关联关系:
知识库(Knowledge Base):创建知识库
kb_enterprise_support时,必须从「模型」页已启用embedding能力的 Provider 中选择向量模型(如text-embedding-v3,1024 维);开启多模态图片理解时需选择具备vlm能力的模型(如qwen-vl-max);在混合检索(searchMode=hybrid)中开启重排时需选择具备rerank能力的模型(如qwen3.7-text-rerank)。记忆(Memory):记忆提取、画像生成、梦境整合与经验技能蒸馏(Distillation)依赖「模型」页配置的默认 Chat 与 Embedding 模型。
智能体工作台(Agent Runtime):在工作台中配置主对话模型(如
qwen-plus)并关联知识库kb_enterprise_support与词库(lex_enterprise_synonyms、lex_support_stopwords),实现开箱即用的企业级知识问答。限额与可观测(Limits & Observability):无论通过 LLM Gateway 还是 AI Gateway 发起模型调用,产生的 Prompt Tokens、Completion Tokens、延迟与错误率均自动汇聚至项目的 可观测(Observability) 与 用量限额(Limits) 看板。
功能详解与操作指南
场景一:选型决策——何时使用「模型(LLM Gateway)」与「AI 网关(AI Gateway)」
在实际工程交付中,建议遵循以下「底座先行、网关按需演进」的标准路径:
| 业务阶段与场景 | 推荐使用的模块 | 核心配置动作 |
|---|---|---|
| 阶段 1:为项目接入大模型算力底座(支撑知识库摄取、混合检索重排、记忆抽取、智能体工作台问答) | 模型(LLM Gateway) | 在 模型 -> 模型提供商 中通过「阿里云百炼(DashScope)」预设注册 dashscope-prod,一键导入 qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank、qwen-vl-max 并完成健康探测。 |
| 阶段 2:单业务应用直接调用统一兼容接口(后端微服务需以 OpenAI SDK 标准格式调用千问模型) | 模型(LLM Gateway) | 在 模型 -> 网关密钥 中签发 gw-key-support-bot(限定模型白名单与月度 Token 预算),业务端将 base_url 指向 https://appbuild.oceanbase.com/v1/ai。 |
| 阶段 3:企业多智能体/多渠道生产级流量治理(需要主备模型无缝容灾、敏感信息拦截、语义缓存降本、MCP 工具鉴权审批) | AI 网关(AI Gateway) | 在 AI 网关 -> 网关 中创建实例 prod-enterprise-ai-gateway,配置逻辑模型 lm-enterprise-chat(主路由 qwen-plus,备选故障转移 qwen-turbo),挂载护栏 gp-enterprise-safety 与语义缓存 cp-semantic-cache。 |
场景二:端到端打通「模型底座 -> AI 网关实例 -> 业务调用」
步骤 1:在「模型(LLM Gateway)」完成供应商注册与健康探测
进入项目
enterprise-ai-hub-210的 模型(Models) 页面,在 模型提供商(Providers) 页签点击 添加提供商。选择内置厂商预设 通义千问(DashScope),连接名称填写
dashscope-prod,Base URL 自动填充为https://dashscope.aliyuncs.com/compatible-mode/v1,填入<DASHSCOPE_API_KEY>。勾选开启
chat、embedding、rerank、vlm四项能力,导入并保留以下 5 个核心模型:对话模型(Chat):
qwen-plus(默认主模型)、qwen-turbo(高并发轻量模型)向量模型(Embedding):
text-embedding-v3(默认维度1024,最大输入 Token8192)重排模型(Rerank):
qwen3.7-text-rerank(最大并发与文档片段精排)视觉模型(VLM):
qwen-vl-max(用于知识库多模态图表与扫描件理解)
保存后点击连接行的 健康检查(Health Check),确认状态徽标更新为绿色
HEALTHY。
步骤 2:在「AI 网关(AI Gateway)」构建高可用逻辑模型与安全策略
切换至左侧导航栏 AI 网关(AI Gateway) 页面,在 网关(Gateways) 页签创建网关实例:
网关名称:
prod-enterprise-ai-gateway网关实例 ID:
gw_7194685489feb1e169548619
进入 模型路由(Model routing) 页签,创建逻辑模型
lm-enterprise-chat:将主部署目标(Primary Target)指向
dashscope-prod下的qwen-plus(权重100,优先级1)。将备用故障转移目标(Fallback Target)指向
dashscope-prod下的qwen-turbo(优先级2,当主模型超时或返回 5xx/429 时自动接管)。
进入 策略与凭证(Policies & Credentials) 页签:
创建并绑定安全护栏配置
gp-enterprise-safety(开启入站 Prompt 注入检测与出站手机号/身份证号/密钥脱敏)。创建并绑定语义缓存策略
cp-semantic-cache(余弦相似度阈值0.95,TTL3600秒)。为客服机器人主体签发绑定至该网关实例的专属密钥,设置硬性配额(如 QPS 上限
20、月度预算50,000,000Tokens)。
步骤 3:验证两套数据面端点的独立调用
通过 curl 分别验证项目级 LLM Gateway 与实例级 AI Gateway 的推理端点,确认两者并存且按各自策略生效:
# 1. 调用项目级 LLM Gateway 标准端点(直接指定物理模型 qwen-plus)
curl -X POST "https://appbuild.oceanbase.com/v1/ai/chat/completions" \
  -H "Authorization: Bearer <APPBASE_GATEWAY_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-plus",
    "messages": [
      {"role": "system", "content": "你是企业智能客服助手。"},
      {"role": "user", "content": "请简述 OceanBase 分布式事务的两阶段提交机制。"}
    ],
    "temperature": 0.2
  }'

# 2. 调用统一 AI Gateway 实例端点(指定逻辑模型 lm-enterprise-chat,自动经过护栏与语义缓存)
curl -X POST "https://appbuild.oceanbase.com/ai-gateway/g/gw_7194685489feb1e169548619/v1/chat/completions" \
  -H "Authorization: Bearer <APPBASE_AI_GATEWAY_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "lm-enterprise-chat",
    "messages": [
      {"role": "system", "content": "你是企业智能客服助手。"},
      {"role": "user", "content": "请简述 OceanBase 分布式事务的两阶段提交机制。"}
    ],
    "temperature": 0.2
}'验证结果:
第一条请求直接由 LLM Gateway 路由至
dashscope-prod的qwen-plus,用量记录在 模型 -> 用量(Usage) 页签。第二条请求经由网关实例
gw_7194685489feb1e169548619完成gp-enterprise-safety护栏扫描与cp-semantic-cache语义缓存登记后路由至lm-enterprise-chat,二次相同提问将在毫秒级直接命中语义缓存返回,详细轨迹与命中率记录在 AI 网关 -> 流量与质量(Traffic & Quality) 页签。
常见问题与排障
Q1:启用了「AI 网关(AI Gateway)」并配置了逻辑模型后,会影响知识库或记忆模块的模型调用吗?
不会。 Agentbase 的「模型(LLM Gateway)」与「AI 网关(AI Gateway)」采用完全解耦的并存设计。知识库(向量化、重排、图谱抽取、Wiki 编译)、记忆中心与智能体工作台始终通过项目级「模型(LLM Gateway)」读取已注册的 Provider 与物理模型参数;AI 网关仅处理显式发往 /ai-gateway/g/{gatewayId}/... 的数据面流量,绝不劫持或篡改 LLM Gateway 的既有路由。
Q2:使用 abk_ 开头的网关密钥调用 /ai-gateway/g/{gatewayId}/v1/chat/completions 返回 401 Unauthorized 或 403 Forbidden 怎么办?
请按以下顺序排查:
检查密钥归属面:在「模型(LLM Gateway)」页签创建的普通项目级密钥仅能访问
/v1/ai/*端点;访问/ai-gateway/g/{gatewayId}/v1/*必须使用在该gatewayId实例下签发并绑定的网关凭证。检查模型白名单与逻辑模型映射:确认请求体中的
model字段填写的是该网关实例下已发布的逻辑模型名称(如lm-enterprise-chat)或已导入的标准模型,且当前凭证的角色策略允许访问该模型。检查预算熔断状态:前往 AI 网关 -> 策略与凭证,检查该凭证关联的 Token 或 QPS 硬性配额(Budget)是否已达周期上限。
Q3:为什么在创建知识库或开启混合检索 Rerank 时,下拉框中看不到刚才在 DashScope Provider 中填写的模型?
这是因为在「模型(LLM Gateway)」中添加或编辑 Provider 时,不仅需要在模型列表中填入模型名称(如 text-embedding-v3 或 qwen3.7-text-rerank),还必须勾选对应能力的启用开关(embedding / rerank / vlm),并将模型准确填入对应能力的专属模型列表(例如将 text-embedding-v3 填入 Embedding 模型列表,将 qwen3.7-text-rerank 填入 Rerank 模型列表)。建议优先使用 厂商预设(Preset Catalog) 导入模型,系统会自动完成能力分类与上下文窗口、向量维度等参数绑定。
Q4:项目设置(Settings -> Services)中的 AI Gateway 开关关闭后会产生什么影响?
当项目设置中的服务开关关闭时,仅阻断外部客户端通过 Client API / 网关密钥发起的模型推理请求;平台内部系统任务(如已排队的知识库摄取、后台记忆整理、服务端 Server API Key 管理调用)仍按各自权限安全运行,且不会丢失任何已保存的 Provider 或网关策略配置。