
记忆端到端调用链路追踪(Memory Traces)
功能概述与核心场景
记忆端到端调用链路追踪(Memory Traces) 是 Agentbase Memory(v2.10.0)与智能体运维可观测中心(AgentOps / Observability)深度打通的全链路性能剖析与故障诊断能力。在企业级智能体生产环境——例如 Agentbase 企业智能中台(组织 ID:69c6d1aa00062e6bb60)下的标杆项目 企业智能客服与知识中台(项目 ID:enterprise-ai-hub-210,基于 OceanBase Shared V2 存储模式)中,一次看似简单的记忆读写背后往往跨越多个异构计算阶段:
同步在线检索与召回(
search/recall):涉及可选的用户画像查询改写(qwen-plus)、1024 维稠密向量编码(text-embedding-v3)、DashScope 稀疏词项权重编码、OceanBase 多路索引并发查询(Dense + Sparse + Keyword + Graph)、RRF 融合排序、语义重排(qwen3.7-text-rerank)以及渐进式分层裁剪(L3 -> L2 -> L1 -> L0,受450msdeadlineMs保护);异步智能写入与高阶演进(
infer=true写入 / 多模态解析 / 画像提取 / Dreaming 聚合 / 经验与技能蒸馏):涉及 API 网关受理(HTTP202)、后台队列排队(queueDurationMs)、多模态视觉解析(qwen-vl-max)、事实与知识抽取 Generation、相似候选向量召回、冲突判定(ADD/UPDATE/DELETE/NONE)以及多维投影落库。
当研发或 SRE 运维人员需要定位以下核心生产问题时:
检索延迟拆解:“为什么某次
hybrid混合检索总耗时 420ms?时间究竟花在 OceanBase 向量索引扫描,还是上游dashscope-prod的qwen3.7-text-rerank重排网络往返?”异步抽取与去重归因:“为什么 VIP 架构师
user_zhangwei_001的多轮会话提交infer=true后未新增记忆?是模型判定NONE(重复跳过),还是触发了LLM_RATE_LIMITED正在后台重试?”Token 成本核算与慢调用治理:“后台知识蒸馏(
distillations)与 Dreaming 聚合分别消耗了多少 Prompt / Completion Tokens?哪些慢请求超过了slowThresholdMs?”
只需在控制台 记忆(Memory) 顶部导航栏单击 Trace 页签,系统即可携带固定能力标签 capability:memory(APPBASE_TRACE_TAGS.capabilityMemory)一键跳转至项目可观测性链路追踪视图,实现从业务 X-AppBase-Trace-Id、jobId、userId 到毫秒级 Span 瀑布图(Waterfall)与大模型 Generation 载荷的端到端穿透定位。
核心概念与架构
Memory 调用链路追踪通过统一的分布式追踪上下文(W3C traceparent / X-Trace-ID -> X-AppBase-Trace-Id),将 同步 API 接入平面、异步队列与 Pipeline Worker 平面、OceanBase 存储检索平面 以及 Models / LLM Gateway 模型调用平面 串联为完整的 OpenTelemetry / Langfuse Trace Tree:
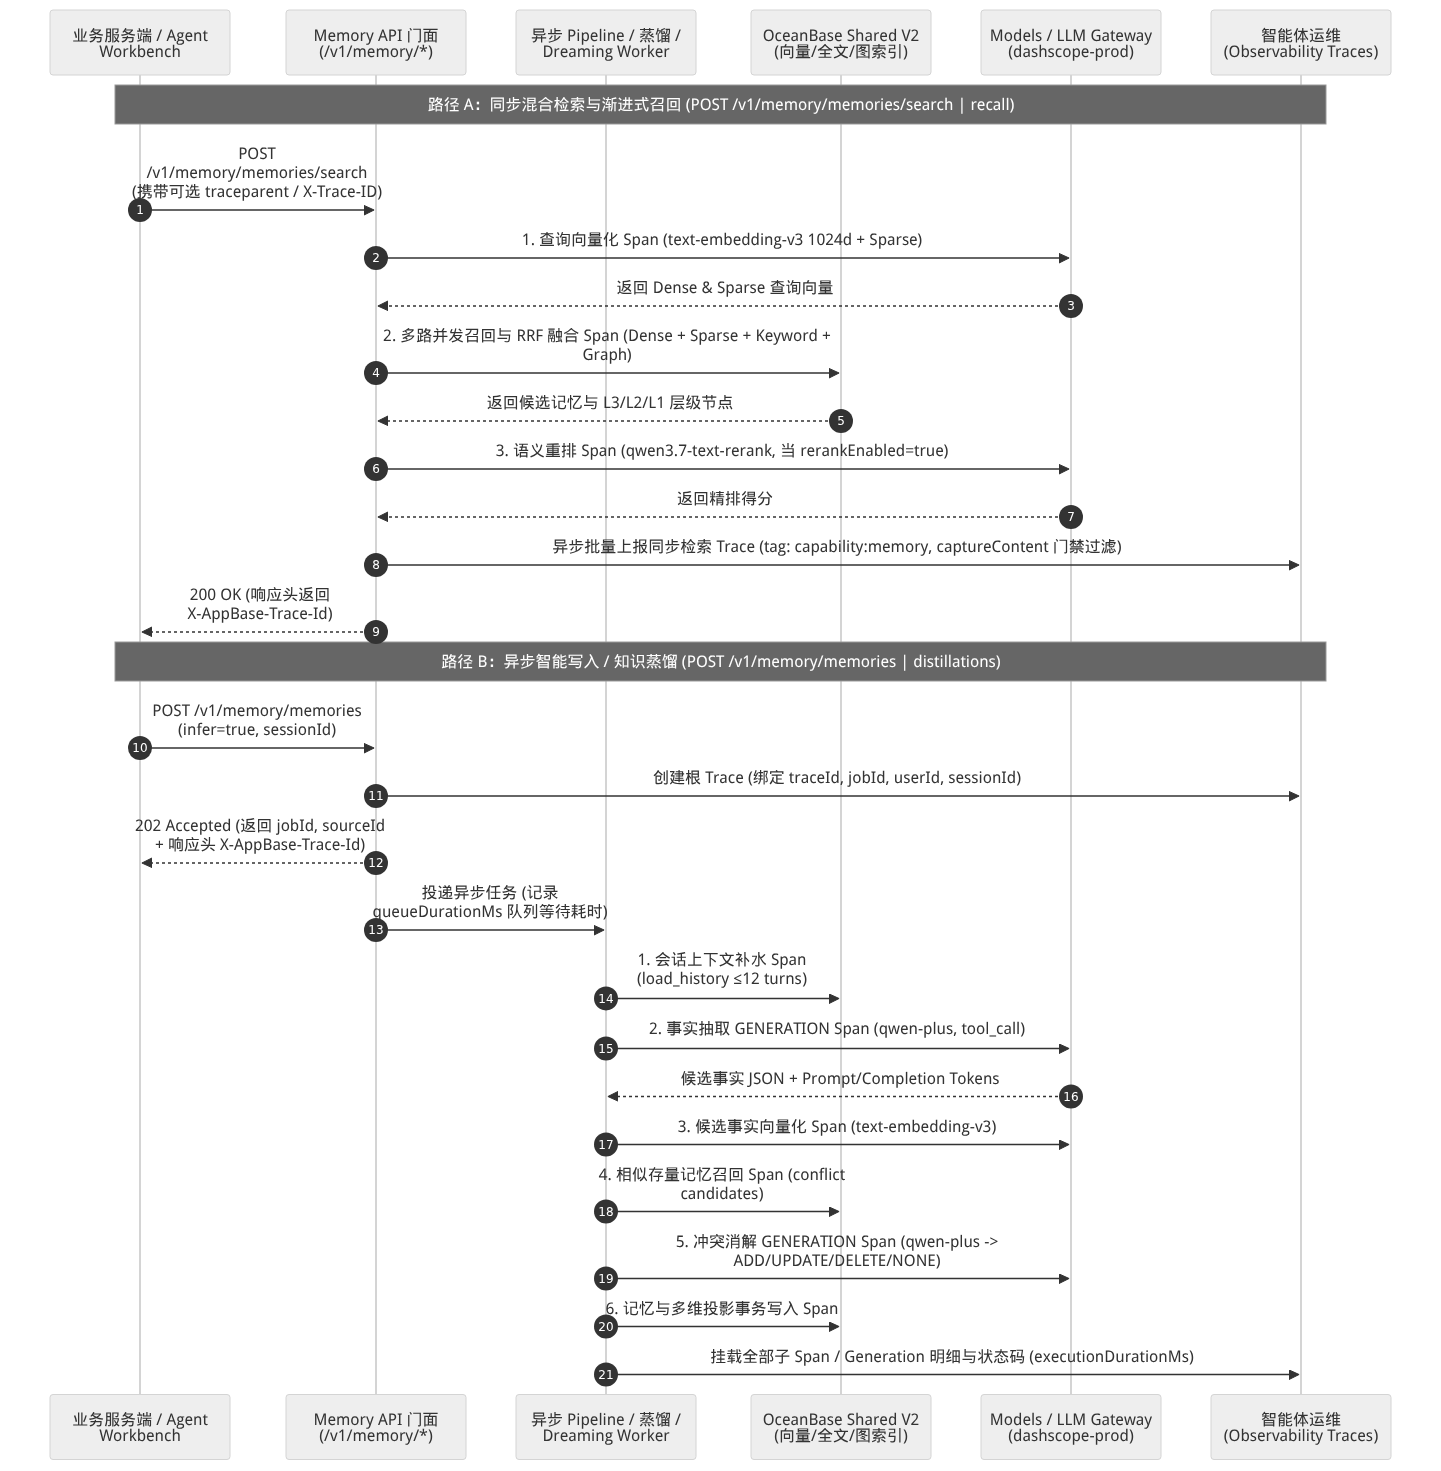
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
1. 端到端 Trace ID 传播与关联协议
Agentbase Memory 在所有 /v1/memory/* 接口上遵循确定性的 Trace ID 继承与回传规则:
| 传播环节 | Header / 字段名称 | 格式规范与优先级规则 | 生产排障用途 |
|---|---|---|---|
| 入站请求头(优先级 1) | traceparent | 标准 W3C Trace Context 格式(00-<32hex trace-id>-<16hex parent-id>-<2hex flags>) | 当上游微服务或智能体编排层已开启 OpenTelemetry 时,Memory 自动提取其中的 32 位十六进制 trace-id 作为本次记忆操作的关联 Trace ID,实现全栈单链合一。 |
| 入站请求头(优先级 2) | X-Trace-ID | 32 位非全零小写十六进制字符串(^[0-9a-f]{32}$) | 当未传 traceparent 时,优先采纳调用方显式传入的合法 X-Trace-ID。 |
| 出站响应头(权威回执) | X-AppBase-Trace-Id | 32 位非全零小写十六进制字符串(如 7a8c9d0e1f2a3b4c5d6e7f8a9b0c1d2e) | 若调用方未传上述请求头,平台自动生成全新 Trace ID,并在所有成功响应头中统一通过 X-AppBase-Trace-Id 返回;在异步重试(attempt 1..N)期间,同一个 jobId 始终沿用同一个根 Trace ID。 |
| 能力过滤标签 | capability:memory | 前端常量 APPBASE_TRACE_TAGS.capabilityMemory | 自动打标在所有托管 Memory 产生的根 Trace 上,支撑控制台一键过滤与 Metrics memoryOnly 独立成本核算。 |
2. 同步检索 vs 异步写入/蒸馏的 Span 树结构拆解
在 Trace 详情抽屉的瀑布图(Waterfall)中,不同业务路径会呈现标准化的层级 Span 树结构:
| 业务链路类型 | 核心阶段 Span / Generation 节点名称 | 观测类型 (type) | 关联模型 / 存储组件 | 关键观测属性与诊断指标 |
|---|---|---|---|---|
| 同步混合检索与召回 ( search / recall) | memory.query_rewrite(开启画像改写时) | GENERATION | dashscope-prod / qwen-plus | 记录原始 query、结合 user_zhangwei_001 画像改写后的查询词及 Token 消耗。 |
memory.embedding.query | SPAN | dashscope-prod / text-embedding-v3 | 记录 1024 维稠密向量与 Sparse 稀疏向量编码耗时(支持命中 queryEmbeddingCache 缓存)。 | |
memory.storage.hybrid_query | SPAN | OceanBase Shared V2 | 记录项目独占表组 _<projectSequence> 上的向量 HNSW 扫描、全文检索、2 跳图遍历(graph)及 RRF 融合耗时。 | |
memory.rerank(当 policy.rerankEnabled=true) | SPAN | dashscope-prod / qwen3.7-text-rerank | 记录候选集重排耗时与得分分布;若重排超时降级,记录 degraded.rerank=true。 | |
| 异步写入 / 蒸馏 / Dreaming ( infer=true / distillations / contexts/runs) | memory.job.queue_wait | SPAN(或元数据) | 异步任务队列 | 记录 queueDurationMs(从 HTTP 202 入队到 Worker 实际开始执行的排队等待毫秒数)。 |
memory.media.parse(多模态写入时) | GENERATION | dashscope-prod / qwen-vl-max | 记录解析 agent_multimedia_bucket 中 PNG/JPEG/WebP/PDF 文件的耗时与提取字节数。 | |
memory.pipeline.fact_extractionmemory.pipeline.skill_extractionmemory.pipeline.experience_extraction | GENERATION | dashscope-prod / qwen-plus (tool_call) | 记录抽取阶段调用大模型的完整 Prompt/Completion(受 captureContent 双门禁控制)、首字延迟與 Token 明细。 | |
memory.pipeline.conflict_detectionmemory.pipeline.skill_merge | GENERATION | dashscope-prod / qwen-plus | 记录与存量相似记忆/技能比对后输出的 ADD / UPDATE / DELETE / NONE / MERGE 决策动作。 | |
memory.ingest.stage_failed(异常诊断节点) | EVENT / SPAN | 故障阶段定位器 | 当任一阶段报错时记录 errorClass、errorCode(如 LLM_RATE_LIMITED、LLM_TIMEOUT、LLM_INVALID_JSON)、retryable 与 gatewayStatus。 |
功能入口与权限矩阵
控制台入口位于:项目 enterprise-ai-hub-210 → 记忆(Memory) → Trace 页签,点击后直接路由至 /console/project-{region}-enterprise-ai-hub-210/observability/traces?tag=capability%3Amemory。
| 功能动作 | 控制台 UI 入口与路由 | REST API 端点 | Server SDK / 头部契约 | 所需 RBAC / API Key Scope | 跨模块关联依赖 |
|---|---|---|---|---|---|
| 从记忆工作台一键跳转链路页 | 记忆 → Trace 页签(跳转至 /observability/traces?tag=capability%3Amemory) | GET /v1/observability/traces?tag=capability:memory | Console 路由导航 | 控制台成员 + observability.traces.read | 联动 智能体运维 → 链路追踪 |
| 查看单条 Trace 的 Span 瀑布图 | 链路列表点击目标 Trace 行展开详情抽屉 | GET /v1/observability/traces/{traceId} | HTTP GET | observability.traces.read | 展示 memory.model.call 与 OceanBase 检索子 Span |
| 配置 Memory 可观测采样与慢阈值 | 记忆 → 配置 → 基础配置 (policy) | GET/PUT /v1/projects/{projectId}/memory/config/policy | 控制面 HTTP API | Console 管理员或 projects.write | 管理 observability.enabled、successSampleRate、slowThresholdMs、captureContent |
| 在指标大盘仅统计 Memory 成本与延迟 | 智能体运维 → 指标 → 仅看 Memory (memoryOnly) | GET /v1/observability/metrics?memoryOnly=true | HTTP GET | observability.metrics.read | 联动 指标监控与分析报表 |
| 交叉核对业务请求回执与任务终态 | 记忆 → 审计 页签(?tab=audit) | GET /v1/memory/audits、GET /v1/memory/jobs/{jobId} | memory.listAudits / memory.getJob | memories.read | 与 记忆审计日志 互为排障闭环 |
功能详解与操作指南
步骤一:从 Memory 控制台一键跳转并按 capability:memory 筛选轨迹
登录 Agentbase 控制台,进入组织
Agentbase 企业智能中台(69c6d1aa00062e6bb60)下的标杆项目企业智能客服与知识中台(enterprise-ai-hub-210),在左侧导航栏单击 记忆(Memory)。在记忆工作台顶部水平页签栏(
记忆|画像|经验与技能|模型|上下文|配置|审计|Trace)中,单击最右侧的 Trace 页签。浏览器自动跳转至
/console/project-{region}-enterprise-ai-hub-210/observability/traces?tag=capability%3Amemory,页面顶部过滤栏已自动挂载tag = capability:memory筛选条件,仅展示当前项目由 Memory 服务产生的同步检索与异步流水线轨迹。在列表顶部筛选区可进一步叠加精细化定位条件:
Trace ID 搜索:粘贴业务响应头返回的
X-AppBase-Trace-Id(如7a8c9d0e1f2a3b4c5d6e7f8a9b0c1d2e);User ID 过滤:输入
user_zhangwei_001或user_lina_002,仅查看特定客户的记忆写入、画像更新与召回链路;Session ID 过滤:输入业务会话标识(如
sess_ticket_TK_20261022_001),串联查看同一工单会话内历次记忆推断与上下文召回的完整轨迹序列。
步骤二:下钻剖析 Span 瀑布图(排查延迟瓶颈与 skipReason)
单击列表中的任意一条 Memory Trace 记录,右侧详情面板将展示完整的 Span 树与阶段耗时瀑布图。在实际运维中,可按以下四步法则快速定位问题:
区分
queueDurationMs与executionDurationMs:若异步写入或蒸馏任务端到端耗时较长,先观察根 Trace 创建时刻到第一个 Worker 执行 Span 之间的空白等待段(
queueDurationMs)。若queueDurationMs显著偏高而executionDurationMs正常,说明项目正在进行大批量导入(batch/imports)触发了后台队列削峰排队,而非模型或数据库变慢。
定位在线混合检索(
search/recall)的耗时大头:对比
memory.embedding.query(调用dashscope-prod的text-embedding-v3)、memory.storage.hybrid_query(OceanBase 向量 + 全文 + 图检索)与memory.rerank(调用qwen3.7-text-rerank)三个子 Span 的耗时占比;若
memory.rerank耗时接近或超过预算,可检查是否将候选召回上限设置过大,或结合渐进式检索的deadlineMs: 450实现硬超时保护。
理解何时不会出现 LLM
GENERATION节点(skipReason):当查看一次
infer=false直接写入、一条设置了handlingPolicy="no_model"的合规记录,或一次未开启画像改写(profileRewriteEnabled=false)的在线检索时,Span 树中没有GENERATION大模型生成节点属于完全符合预期的正常行为,Span 元数据会明确记录跳过原因(如skipReason: "request_infer_false"或"policy_no_model")。
定位异步任务失败与重试(
memory.ingest.stage_failed):当某次
infer=true写入或知识蒸馏因上游模型限流(HTTP 429)触发重试时,同一个jobId的多次尝试(attempt=1, 2...)会聚合在同一条根 Trace 下;展开带警告/错误标记的memory.model.call或memory.ingest.stage_failed节点,可直接读取errorCode(如LLM_RATE_LIMITED、LLM_INVALID_JSON)、retryable: true/false及gatewayStatus。
步骤三:配置隐私内容捕获双门禁(captureContent)与智能采样策略
在企业生产环境中,并非所有项目都希望将客户原始对话和记忆正文写入可观测链路日志;同时,超高并发项目也无需对 100% 的常规快速成功请求全量采集 Trace。Agentbase Memory 在 policy.observability(位于 /v1/projects/{projectId}/memory/config/policy)中提供了精细的采样与隐私控制开关:
| 配置字段路径 | 类型 | 默认值 / 范围 | 治理语义与生效机制 |
|---|---|---|---|
policy.observability.enabled | boolean | true | 项目级 Memory Trace 导出开关(需平台全局 agentops.enabled=true 同时开启)。 |
policy.observability.successSampleRate | number | 0.0 ~ 1.0(默认 1.0) | 普通成功请求的采样率。例如设为 0.2 表示对耗时正常的成功请求按 20% 概率采样。注意:失败请求(Error)与超过慢阈值的慢请求(Slow)不受采样率丢弃,始终优先采集。 |
policy.observability.slowThresholdMs | integer | 正整数(如 800 ms) | 慢请求强制追踪阈值。即使 successSampleRate 设得很低,只要某次 Memory 操作耗时超过 slowThresholdMs,系统会自动升级采样以确保慢查询必有 Trace 可查。 |
policy.observability.captureContent | boolean | false / true | 内容捕获双重门禁(Dual Gate)项目级开关:只有当平台级环境变量开关(observability.captureContent / agentops.memoryCaptureContentEnabled)与项目级开关 policy.observability.captureContent 同时为 true 时,Span 与 Generation 节点中才会记录记忆正文与 Prompt 输入输出;只要任一门禁为 false,所有业务文本载荷均在落盘前自动替换为 [REDACTED],仅保留耗时、Token 计数与状态码。 |
步骤四:通过请求头注入自定义 Trace ID 并使用 API 查询验证
下面演示如何在业务服务端调用 Memory 搜索接口时主动传入 W3C traceparent(或读取返回的 X-AppBase-Trace-Id),随后通过可观测性 REST API 查询生成的完整链路详情:
export APPBASE_ENDPOINT="https://appbuild.oceanbase.com/v1"
export APPBASE_PROJECT_ID="enterprise-ai-hub-210"
export APPBASE_API_KEY="<APPBASE_API_KEY>"

# 1. 调用混合检索接口,传入自定义 W3C traceparent 并捕获响应头中的 X-AppBase-Trace-Id
curl -fsS -D /tmp/memory_trace_headers.txt \
  -X POST "${APPBASE_ENDPOINT}/memory/memories/search" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: ${APPBASE_API_KEY}" \
  -H "traceparent: 00-7a8c9d0e1f2a3b4c5d6e7f8a9b0c1d2e-1a2b3c4d5e6f7a8b-01" \
  -H "Content-Type: application/json" \
  --data '{
    "userId": "user_zhangwei_001",
    "scope": "user",
    "query": "OceanBase Shared V2 向量索引 HNSW 参数与排障偏好",
    "searchMode": "hybrid",
    "limit": 5
  }' | jq .

# 提取响应头中的权威 X-AppBase-Trace-Id
TRACE_ID="$(grep -i '^x-appbase-trace-id:' /tmp/memory_trace_headers.txt | awk '{print $2}' | tr -d '\r')"
echo "Captured X-AppBase-Trace-Id: ${TRACE_ID}"

# 2. 按 capability:memory 标签与 userId 查询项目的 Memory 轨迹列表
curl -fsS --get "${APPBASE_ENDPOINT}/observability/traces" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: ${APPBASE_API_KEY}" \
  --data-urlencode "tag=capability:memory" \
  --data-urlencode "userId=user_zhangwei_001" \
  --data-urlencode "limit=10" | jq .

# 3. 根据捕获的 TRACE_ID 查询单条 Trace 的完整 Span 瀑布树与 Generation Token 明细
curl -fsS "${APPBASE_ENDPOINT}/observability/traces/${TRACE_ID}" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: ${APPBASE_API_KEY}" | jq .
常见问题与排障(FAQ)
1. 为什么在“记忆 → 审计”中看到了成功的请求记录,但点击“Trace”后在链路列表中搜不到对应的 X-AppBase-Trace-Id?
原因分析:排查以下三点:① Trace 采用异步非阻塞管道批量上报,高负载下存在 1~5 秒的入库可见性延迟;② 检查 记忆 → 配置 → 基础配置 (
policy) 中的policy.observability.enabled是否开启,以及successSampleRate是否小于1.0(当采样率小于 100% 且该次请求耗时低于slowThresholdMs时,请求可能按采样规则未导出 Trace);③ 页面顶部的 Time Range 时间窗口或userId过滤条件过于狭窄。解决措施:切勿凭某条 Trace 未命中采样就断言记忆请求未执行——判断业务请求是否执行及最终状态,应始终以 记忆审计日志(
GET /v1/memory/audits)和异步任务查询(GET /v1/memory/jobs/{jobId})为准。若需在调试期捕获每一条请求,可将policy.observability.successSampleRate设为1.0。
2. 打开某条 Memory Trace 的 Generation 节点时,为什么 Prompt 输入和模型输出显示为 [REDACTED]?
原因分析:为了保护企业客户的隐私对话与高敏感记忆内容,Memory Trace 实施了严格的双重
captureContent门禁(平台级observability.captureContent/agentops.memoryCaptureContentEnabled与项目级policy.observability.captureContent)。只要其中任何一个开关为false,系统在构造观测 Span 时就会自动抹除正文载荷并替换为[REDACTED],同时对于标记为高敏感或合规受限的字段执行递归脱敏。解决措施:若在预发调试或经合规授权的项目中需要查看完整 Prompt 与抽取 JSON,请由项目管理员前往 记忆 → 配置 → 基础配置 (
policy),将observability.captureContent设为true并保存。
3. 为什么在“智能体运维 → 指标(Metrics)”中看到的模型调用次数与 Token 消耗高于业务代码直接调用 Chat 接口的统计值?
原因分析:当项目开启了
infer=true记忆智能提取、自动用户画像(autoProfileExtractionEnabled)、Dreaming 上下文聚合(dreaming.enabled)或经验技能蒸馏(autoDistillEnabled)时,Memory 后台 Worker 会调用dashscope-prod下的qwen-plus、text-embedding-v3、qwen3.7-text-rerank与qwen-vl-max。这些带capability:memory标签的调用同样通过项目模型网关计入项目总 Token 与调用量。解决措施:进入 智能体运维 → 指标(Metrics) 页面,开启 仅看 Memory(
memoryOnly) 切换开关,即可将 Memory 产生的模型调用、Token 消耗与延迟分位数独立分离出来进行专项成本核算。