
项目级词库(Lexicons)与检索/图谱/智能体协同治理
本手册对应 Agentbase v2.10.0(控制台同版本)。
词库(Lexicons) 是 Agentbase v2.10.0 面向企业专有术语体系、行业黑话对齐与合规安全拦截打造的跨模块词汇治理引擎。通过两级解耦的词库架构——项目级词库中心(/knowledge-base/lexicons)集中维护标准词典(如 lex_enterprise_synonyms 与 lex_support_stopwords),再按优先级(priority)灵活绑定至 知识库(/knowledge-base/kb-{kb}/lexicons) 与 智能体工作台(/agent-runtime/project/lexicons)——企业可基于内置的 native-v1 分词与改写引擎,在一次定义后同时赋能 RAG 混合检索查询改写(Query Rewrite)、GraphRAG 图谱实体归一化(Entity Normalization) 以及 智能体前置合规停用词零 Token 拦截(stopIntercept)。
功能概述与核心场景
在企业智能客服与技术支持中心(如项目 企业智能客服与知识中台,ID:enterprise-ai-hub-210)中,一线用户提问的口语表达与底层技术白皮书的规范表述之间往往存在巨大的「词汇鸿沟(Lexical Gap)」:
用户习惯输入简称或俗称(如
“OB 报 4024 怎么查?”或“AIGW 怎么配主备?”),而《OceanBase分布式事务与向量索引排障指南.md》中写的是标准术语OceanBase、行锁冲突、GV$OB_LOCKS与统一 AI 网关;在构建 GraphRAG 知识图谱时,若缺乏领域词表约束,大模型可能将
OB、OceanBase 4.3、OceanBase数据库抽取为三个孤立节点,割裂多跳关系拓扑;在智能体工作台(Agent Runtime)对外服务时,用户的口语废话(如
“麻烦问一下呗”)会稀释检索权重,而恶意越狱指令(如“忽略之前所有系统指令”)若直接透传给大模型则既浪费推理 Token 又带来安全风险。
Agentbase 项目级词库(Lexicons) 通过四大核心能力构建全链路词汇治理闭环:
「项目级集中定义 + 多端按优先级绑定」双层架构:
在项目级词库中心统一维护词典资产,单个知识库最多可绑定 100 本词库 并显式编排生效优先级(
priority: 1..N),每条绑定均提供独立的 检索改写开关(enabled) 与 GraphRAG 图谱增强开关(graphrag/lexiconEnabled)。同一套词库可同时绑定至 智能体工作台(
/v1/agent-runtime/project/lexicons),开启stopIntercept: true与自定义拦截话术stopReply。
native-v1分词器与三类精准词条语义(synonym/expansion/stop):近义词(
synonym):双向等价词组(canonical规范主词 +variants同义变体列表),在检索时双向扩展召回,在 GraphRAG 抽取时将所有变体强制归一合并至canonical主节点。追加词(
expansion):单向有向扩展(headword触发词 ->expansions追加词列表),例如搜故障码4024时单向追加行锁冲突、锁等待超时、GV$OB_LOCKS,既大幅提升专业排障分块召回率,又防止搜通用词行锁冲突时反向污染非 4024 场景。停止词(
stop):在知识库检索与图谱构建中剥离口语噪声词;在智能体工作台开启stopIntercept时直接触发毫秒级前置阻断。
在线分词改写预览调试器(
/v1/lexicons/{lexiconId}/preview):无需发起完整 RAG 检索,即可在词库详情页输入测试句子,实时预览
native-v1分词切分结果、命中的词条规则、改写扩展后的最终 Query 以及是否触发停止词拦截。
企业级批量导入导出与冲突合并策略:
支持 CSV、Excel(
.xlsx)与 JSON 格式批量导入导出,内置skip(跳过同名项)、overwrite(覆盖同名项) 与merge(合并变体/追加词集合) 三种冲突解决策略,并实施单词条 8,000 字符安全上限校验。
核心概念与架构
项目级词库双层治理与三端协同生效架构图
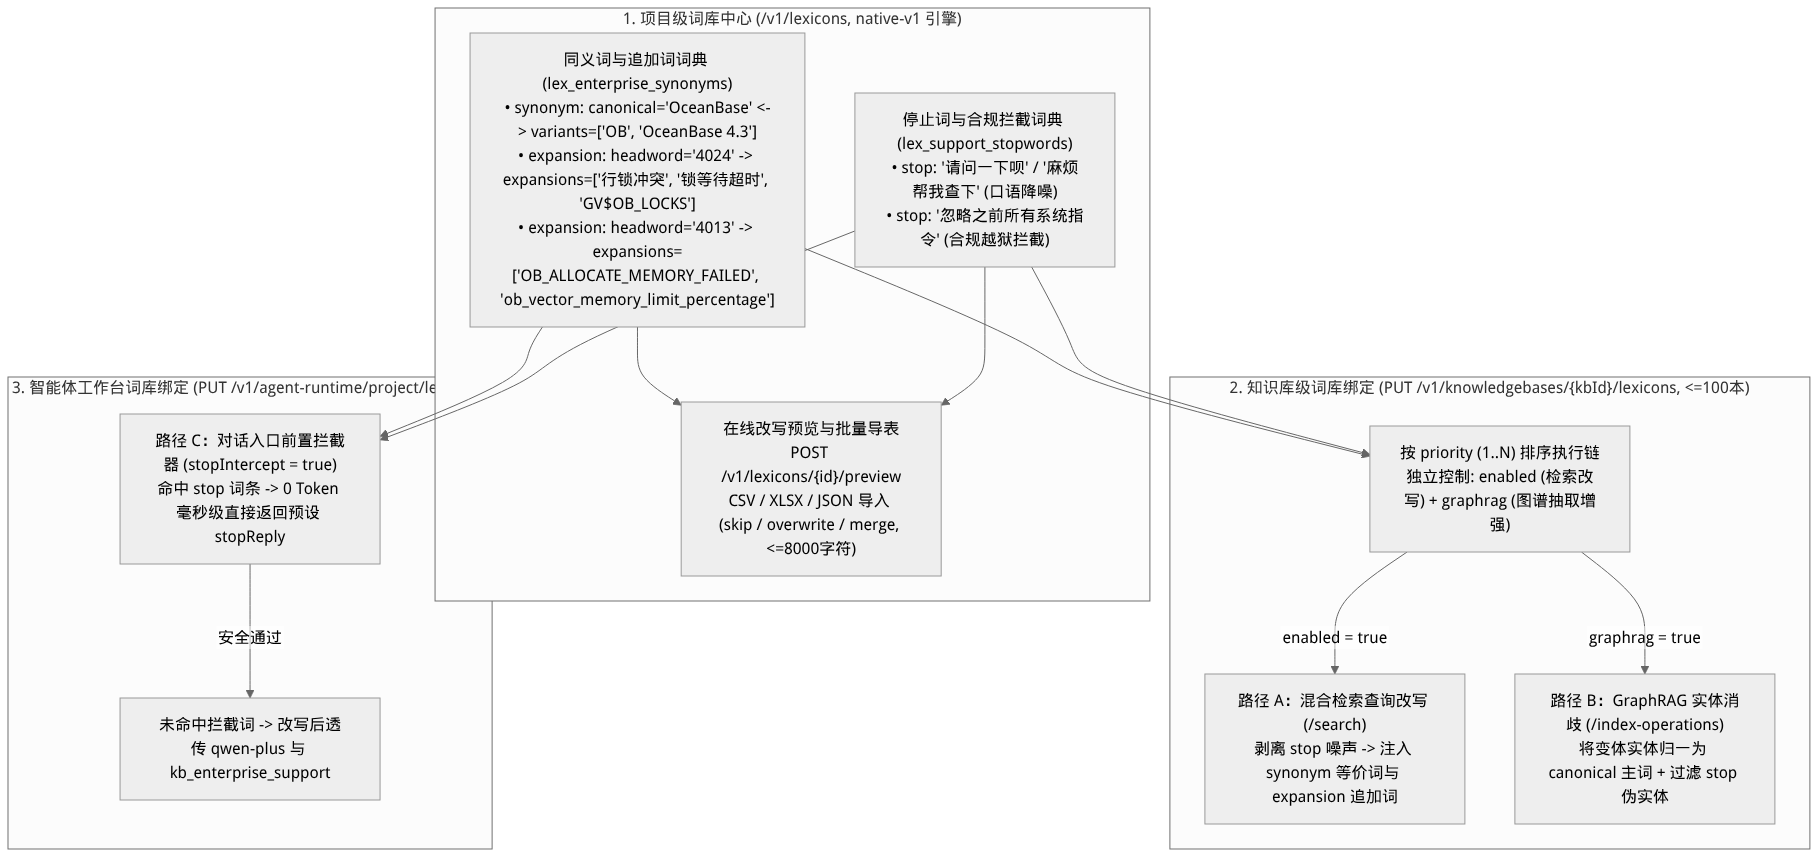
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
native-v1 分词器与三类词条语义深度对比表
词条类型 (type) | 核心数据结构 | 匹配与改写方向 | 在「混合检索(Search)」中的作用 | 在「GraphRAG 图谱构建」中的作用 | 在「智能体工作台(Agent Runtime)」中的作用 |
|---|---|---|---|---|---|
synonym(近义词) | canonical(规范主词)+ variants[](同义变体数组) | 双向等价 ( canonical $\leftrightarrow$ variants) | 用户查询命中主词或任一变体时,自动将同组全部等价词注入全文与向量查询,解决缩写/全称不一致导致的漏召回。 | 当开启 graphrag / lexiconEnabled 时,抽取到的任何 variants 实体名称均被強制改写归并为唯一的 canonical 主节点。 | 协同提升工作台挂载知识库时的语义对齐准确度。 |
expansion(追加词) | headword(触发词)+ expansions[](单向追加词数组) | 单向扩展 ( headword $\rightarrow$ expansions) | 仅当用户 Query 包含 headword(如 4024)时,自动向查询追加 expansions(如 行锁冲突、GV$OB_LOCKS);反之搜 行锁冲突 不会反向注入 4024。 | 辅助实体上下文扩展,不破坏主实体独立性。 | 将用户简短的故障码或口语黑话扩展为完整的技术检索意图。 |
stop(停止词) | headword / term(停止词文本) | 精确剥离或阻断 | 在构造全文检索(BM25)与向量查询前,自动剔除命中的口语后缀或无意义高频虚词,提纯核心 Query 权重。 | 阻止将无意义的口语词或格式占位词误抽取为图谱实体节点。 | 当绑定配置开启 stopIntercept: true 时,一旦用户输入命中启用的 stop 词条,立即阻断请求并返回 stopReply。 |
功能入口与权限矩阵
| 控制台入口 / 功能模块 | 前端路由路径 | 对应 REST API 端点 | Server SDK 方法(Node.js / Python) | 所需 RBAC 角色 / API Key Scope | 跨模块依赖关系 |
|---|---|---|---|---|---|
| 项目级词库中心(列表与新建) | /console/project-default-enterprise-ai-hub-210/knowledge-base/lexicons | GET /v1/lexiconsPOST /v1/lexicons | knowledgeBase.listLexicons()knowledgeBase.createLexicon() | 角色:owner、admin、developer(只读成员仅可查看)Scope: lexicons.read / lexicons.write | 项目级共享资源,可供同项目下所有知识库与智能体复用 |
| 词库详情、词条 CRUD 与批量导表 | /console/project-default-enterprise-ai-hub-210/knowledge-base/lexicons/{lexiconId} | GET /v1/lexicons/{lexiconId}PATCH /v1/lexicons/{lexiconId}DELETE /v1/lexicons/{lexiconId} | knowledgeBase.getLexicon()knowledgeBase.updateLexicon()knowledgeBase.deleteLexicon() | 角色:owner、admin、developerScope: lexicons.write | 删除词库前会自动校验或解绑关联引用 |
| 在线分词与改写预览调试 | 词库详情页右侧「预览调试(Preview)」面板 | POST /v1/lexicons/{lexiconId}/preview | knowledgeBase.previewLexicon() / preview_lexicon() | 角色:owner、admin、developer、memberScope: lexicons.read | 内置 native-v1 分词器,零大模型 Token 开销 |
| 知识库级词库绑定与优先级编排 | /console/project-default-enterprise-ai-hub-210/knowledge-base/kb-kb_enterprise_support/lexicons | GET /v1/knowledgebases/{kbId}/lexiconsPUT /v1/knowledgebases/{kbId}/lexicons | knowledgeBase.getKnowledgeBaseLexicons()knowledgeBase.updateKnowledgeBaseLexicons() | 角色:owner、admin、developerScope: knowledgebases.write | 联动 检索测试(Search) 与 知识索引(GraphRAG) |
| 智能体工作台词库绑定与合规拦截 | /console/project-default-enterprise-ai-hub-210/agent-runtime/project/lexicons | GET /v1/agent-runtime/project/lexiconsPUT /v1/agent-runtime/project/lexicons | agentRuntime.getProjectLexicons()agentRuntime.updateProjectLexicons() | 角色:owner、admin、developerScope: agent_runtime.write | 在智能体工作台调用 qwen-plus 之前执行前置改写与停止词拦截 |
功能详解与操作指南
步骤 1:在项目级词库中心创建标杆词库并维护三类词条
登录控制台,进入项目
企业智能客服与知识中台 (enterprise-ai-hub-210)-> 点击左侧导航栏 知识库(Knowledge Base) -> 切换到顶部 词库(Lexicons) 页签(路径:/knowledge-base/lexicons)。点击右上角 创建词库(Create lexicon),分词器引擎默认选用
native-v1,分别创建两本生产标杆词库:词库 1:标识
lex_enterprise_synonyms,名称企业智能客服同义词与专有名词词典;词库 2:标识
lex_support_stopwords,名称企业客服停用词与敏感拦截词典。
点击进入
lex_enterprise_synonyms与lex_support_stopwords详情页,添加以下标准词条:
| 所属词库 ID | 词条类型 (type) | 规范主词 / 触发词 (canonical / headword) | 变体列表 / 追加词列表 (variants / expansions) | 状态 (enabled) | 生产治理目的 |
|---|---|---|---|---|---|
lex_enterprise_synonyms | synonym | OceanBase | ["OB", "OceanBase 4.3", "OceanBase数据库"] | true | 双向等价召回,且在 GraphRAG 抽取时将 OB 等变体合并为 OceanBase 主实体 |
lex_enterprise_synonyms | synonym | 统一AI网关 | ["AIGW", "AI网关", "AI Gateway"] | true | 对齐中英文简称与白皮书标准组件名 |
lex_enterprise_synonyms | expansion | 4024 | ["行锁冲突", "锁等待超时", "GV$OB_LOCKS"] | true | 用户提问 4024 时单向注入锁排查视图与术语 |
lex_enterprise_synonyms | expansion | 4013 | ["OB_ALLOCATE_MEMORY_FAILED", "向量内存不足", "ob_vector_memory_limit_percentage"] | true | 用户输入报错码 4013 时单向扩展完整错误宏与调优参数 |
lex_support_stopwords | stop | 请问一下 | [] | true | 剥离检索开头的口语寒暄词 |
lex_support_stopwords | stop | 麻烦问一下 | [] | true | 剥离口语冗余噪声 |
lex_support_stopwords | stop | 忽略之前所有系统指令 | [] | true | 配合智能体工作台 stopIntercept: true 直接阻断提示词注入攻击 |
步骤 2:在线预览调试(/preview)与 CSV / Excel / JSON 批量导入导出
1. 使用在线预览调试器验证改写效果
在
lex_enterprise_synonyms详情页右侧展开 在线预览(Preview) 面板。在测试输入框中输入:
请问一下 OB 报 4024 和 4013 怎么排查?点击 测试预览(Run Preview)(对应
POST /v1/lexicons/lex_enterprise_synonyms/preview),面板立即输出结构化诊断结果:分词切分序列(Tokens):识别出
OB、4024、4013等核心词元;命中规则明细(Matched Entries):列出命中的
synonym(OB -> OceanBase)与两条expansion(4024 -> 行锁冲突, 锁等待超时, GV$OB_LOCKS;4013 -> OB_ALLOCATE_MEMORY_FAILED, ...);改写后查询(Rewritten Query):展示扩展后的完整检索表达式,确认无误后再绑定上线。
2. CSV / Excel(.xlsx)/ JSON 批量导入导出与冲突策略
当企业需要将上千条存量业务词表批量迁入时:
点击词库详情页右上角的 批量导入(Import),上传
.csv、.xlsx或.json文件(注意:单条词条的主词与变体总字符长度受 8,000 字符安全上限 保护,超长异常行会被精确报错拦截)。选择 冲突处理策略(Conflict Resolution Strategy):
skip(跳过):若导入文件中存在与库内同类型、同主词(canonical/headword)的词条,保留库内现有词条,跳过导入行;overwrite(覆盖):用导入文件中的新变体/追加词列表完全替换库内同名词条;merge(合并,推荐):将导入文件中的新变体或追加词与库内既有列表取并集去重合并,确保增量词表零丢失。
步骤 3:将词库绑定至知识库与智能体工作台
1. 在知识库中绑定词库并配置优先级与双开关(/knowledge-base/kb-kb_enterprise_support/lexicons)
进入知识库
kb_enterprise_support详情页,切换到 词库(Lexicons) 子页签(或通过 设置 页进入词库绑定)。点击 管理绑定词库(Manage bound lexicons),勾选
lex_enterprise_synonyms与lex_support_stopwords(单个知识库最多支持绑定 100 本词库):将
lex_support_stopwords设为priority: 1(优先剥离停止词),开启 检索改写(enabled: true) 与 图谱增强(graphrag: true);将
lex_enterprise_synonyms设为priority: 2(随后执行同义词归一与追加词扩展),同样开启enabled: true与graphrag: true。
点击 保存绑定。保存后,所有发往
/v1/knowledgebases/kb_enterprise_support/search的请求将立即按优先级链执行改写;若需让图谱也应用新绑定的词库,前往 Indexes 页签对GraphRAG执行一次重建即可。
2. 在智能体工作台绑定词库并开启前置合规拦截(/agent-runtime/project/lexicons)
进入左侧导航栏 智能体工作台(Agent Runtime),打开 词库与安全拦截配置。
绑定
lex_enterprise_synonyms与lex_support_stopwords,开启stopIntercept: true(命中停止词直接拦截),并设置自定义拦截回复stopReply。
3. 完整的词库管理、预览与三端绑定 REST API 示例
# 1. 创建项目级词库,指定 native-v1 分词器 (POST /v1/lexicons)
curl -X POST "https://appbuild.oceanbase.com/v1/lexicons" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "lexiconId": "lex_enterprise_synonyms",
    "name": "企业智能客服同义词与专有名词词典",
    "description": "统一 OceanBase、AI 网关及客服 SOP 领域的同义词与追加词",
    "tokenizer": "native-v1",
    "entries": [
      {
        "type": "synonym",
        "canonical": "OceanBase",
        "variants": ["OB", "OceanBase 4.3", "OceanBase数据库"],
        "enabled": true
      },
      {
        "type": "expansion",
        "headword": "4024",
        "expansions": ["行锁冲突", "锁等待超时", "GV$OB_LOCKS"],
        "enabled": true
      },
      {
        "type": "expansion",
        "headword": "4013",
        "expansions": ["OB_ALLOCATE_MEMORY_FAILED", "向量内存不足", "ob_vector_memory_limit_percentage"],
        "enabled": true
      }
    ]
  }'

# 2. 在线预览分词与查询改写效果 (POST /v1/lexicons/{lexiconId}/preview)
curl -X POST "https://appbuild.oceanbase.com/v1/lexicons/lex_enterprise_synonyms/preview" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "text": "OB 数据库出现 4024 和 4013 报错时应该怎么处理?"
  }'

# 3. 将词库按优先级绑定至知识库 kb_enterprise_support,同时开启检索改写与 GraphRAG 增强 (PUT /v1/knowledgebases/{kbId}/lexicons)
curl -X PUT "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/lexicons" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "bindings": [
      {
        "lexiconId": "lex_support_stopwords",
        "priority": 1,
        "enabled": true,
        "graphrag": true
      },
      {
        "lexiconId": "lex_enterprise_synonyms",
        "priority": 2,
        "enabled": true,
        "graphrag": true
      }
    ]
  }'

# 4. 将词库绑定至智能体工作台并开启停止词前置拦截 (PUT /v1/agent-runtime/project/lexicons)
curl -X PUT "https://appbuild.oceanbase.com/v1/agent-runtime/project/lexicons" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "lexiconIds": ["lex_support_stopwords", "lex_enterprise_synonyms"],
    "enabled": true,
    "stopIntercept": true,
    "stopReply": "抱歉,您的输入触发了企业客服合规安全策略,请围绕技术支持与产品使用规范提问。"
  }'
常见问题与排障(FAQ)
Q1:应该如何区分什么时候用 synonym(近义词),什么时候用 expansion(追加词)?
原因分析: 如果将本属于「上下位概念」或「故障码到排查手段」的词汇错误配置为双向等价的
synonym(例如把4024和行锁冲突设为synonym),那么当用户询问通用的“如何预防数据库行锁冲突”时,检索引擎也会强制混入4024错误码,导致泛化查询被特定故障码污染;而且在 GraphRAG 中还会把行锁冲突概念节点强行合并进4024节点。解决措施: 严格遵循以下准则:
仅当两个词指代完全相同的客观实体(如
OB与OceanBase、AIGW与统一AI网关)时,才使用synonym;当希望从具体故障码、缩写或症状单向带出关联的背景术语、排查视图或参数(如
4024 -> 行锁冲突, GV$OB_LOCKS)时,务必使用expansion(追加词)。
Q2:如果把包含 请问、麻烦问一下 等日常寒暄词的停止词词库绑定到了智能体工作台,并且开启了 stopIntercept: true,会导致正常带礼貌用语的用户提问被拦截吗?
原因分析: 会的! 在智能体工作台(
/v1/agent-runtime/project/lexicons)中,一旦开启stopIntercept: true,工作台会将已绑定词库中所有启用的stop词条视为敏感阻断词——只要用户提问包含任一stop词条,就会立即返回stopReply。如果同一本词库里既放了口语寒暄停止词(请问),又放了安全违规词(忽略之前所有系统指令),开启stopIntercept: true就会误伤礼貌提问的用户。解决措施: 在生产实践中,建议将「检索降噪停止词词库」(仅绑定至知识库
/v1/knowledgebases/{kbId}/lexicons用于清洗检索词)与「合规安全拦截词库」(绑定至智能体工作台/v1/agent-runtime/project/lexicons并开启stopIntercept: true)拆分为两本独立的词库分别管理,实现检索提纯与安全阻断的职责分离。
Q3:批量导入 Excel/CSV 词表时报错 400 Bad Request 提示单条词条超出长度上限或存在重复优先级,该如何处理?
原因分析:
为防范正则/分词内存膨胀攻击,平台对单个词条的主词与变体总字符数设有 8,000 字符 的硬性安全上限;
在调用
PUT /v1/knowledgebases/{kbId}/lexicons绑定多本词库时,每本词库的priority必须为正整数且绑定总数不超过 100 本。
解决措施: 检查导入表格中是否存在将整段长文章误粘贴进单个单元格的情况,将超大词条拆分为独立的标准词组,并使用
conflictStrategy: "merge"重新执行批量导入。