
模型(LLM Gateway)
模型(LLM Gateway) 是 Agentbase v2.10.0 项目访问大语言模型、向量嵌入模型、重排模型与多模态视觉模型的统一底座入口。通过控制台左侧导航栏的 模型(Models) 页面,研发与运维团队可以集中管理模型供应商(Provider)连接凭据、从内置厂商预设目录一键导入模型参数、执行逐模型健康检查、签发受限网关密钥(Gateway Key),并为项目内的知识库、记忆中心、智能体工作台与可观测性评估提供开箱即用的模型算力支撑。
功能概述
在企业级 AI 应用开发中,直接将上游大模型厂商(如阿里云百炼 DashScope、OpenAI、Anthropic 或私有化部署的 vLLM/Ollama)的原始 API Key 分发给各个微服务或前端客户端,会带来严重的密钥泄露风险、超时重试不一致以及用量账单无法按项目归集等痛点。
Agentbase 的 模型(LLM Gateway) 通过三个核心功能页签解决上述问题:
模型提供商(Providers):
内置 24 个主流厂商预设、313 个预置模型目录,自动带入每个模型的上下文窗口(Context Window)、最大输出 Token、Embedding 默认维度与输入上限、Tool Call 支持标记及多模态能力。
支持单项目注册多个供应商连接(如生产主连接
dashscope-prod),配置优先级故障转移顺序、请求超时时间与自动重试次数。提供实时 模型发现(Model Discovery) 与 逐模型健康探测(Health Probe),确保底层算力持续处于
HEALTHY状态。
网关密钥(Gateway Keys):
签发以
abk_为前缀的受限执行密钥(如gw-key-support-bot),明文仅在创建时展示一次,服务端仅存储高强度哈希值与前缀。支持按密钥配置允许调用的模型白名单、每分钟请求速率限制(RPM)与月度 Token 预算上限,且仅允许调用推理执行端点,天然隔离管理面权限。
用量统计(Usage):
实时统计项目内通过网关密钥及平台内部服务(知识库、记忆、智能体工作台、评估)产生的请求次数、输入/输出 Token 消耗与错误分布。
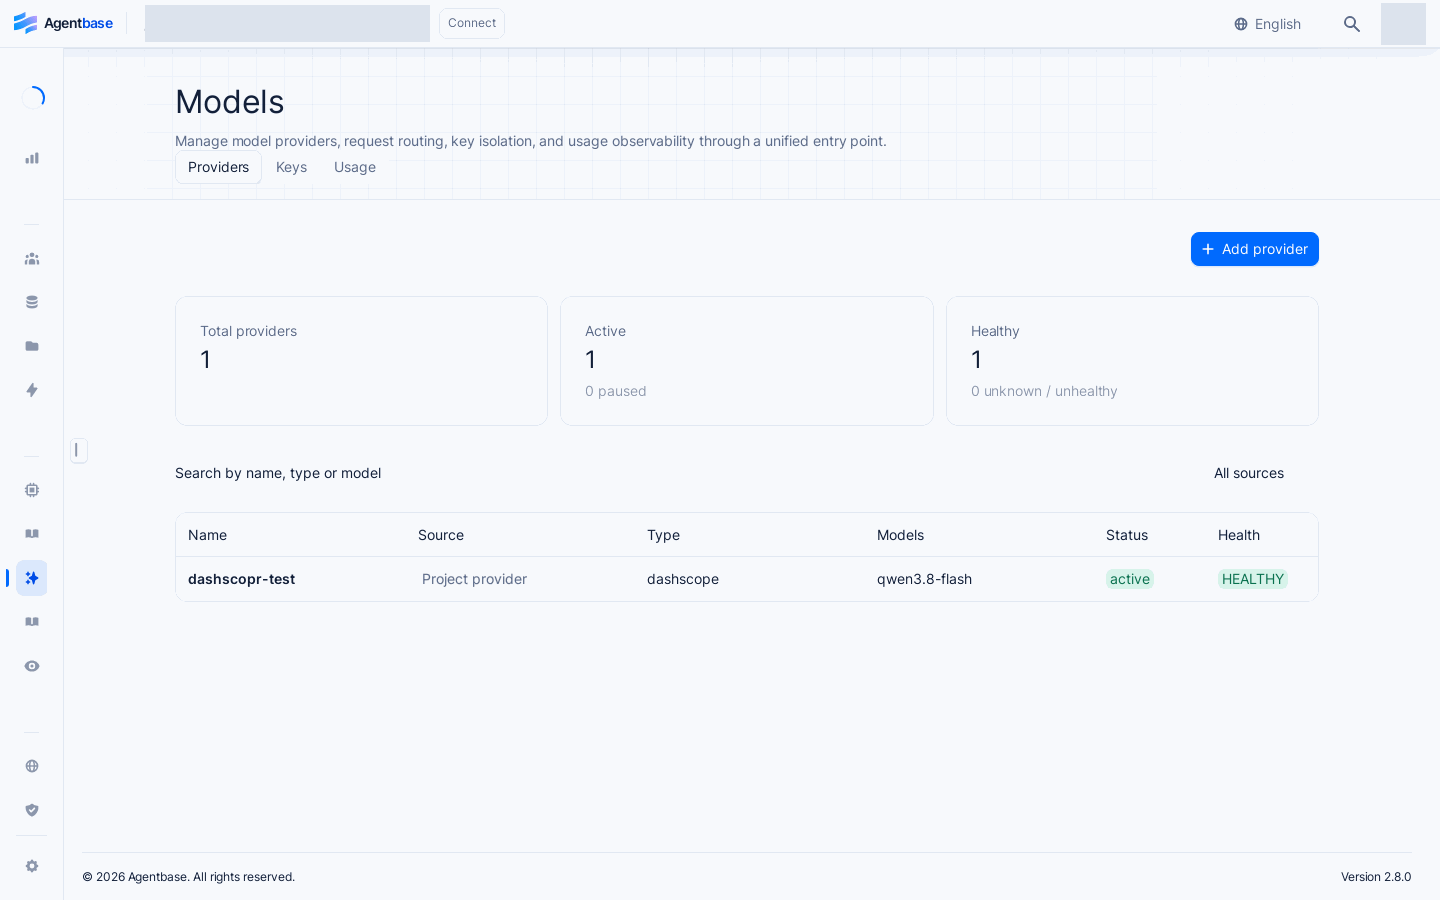
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
核心概念与架构
LLM Gateway 路由与算力供给架构
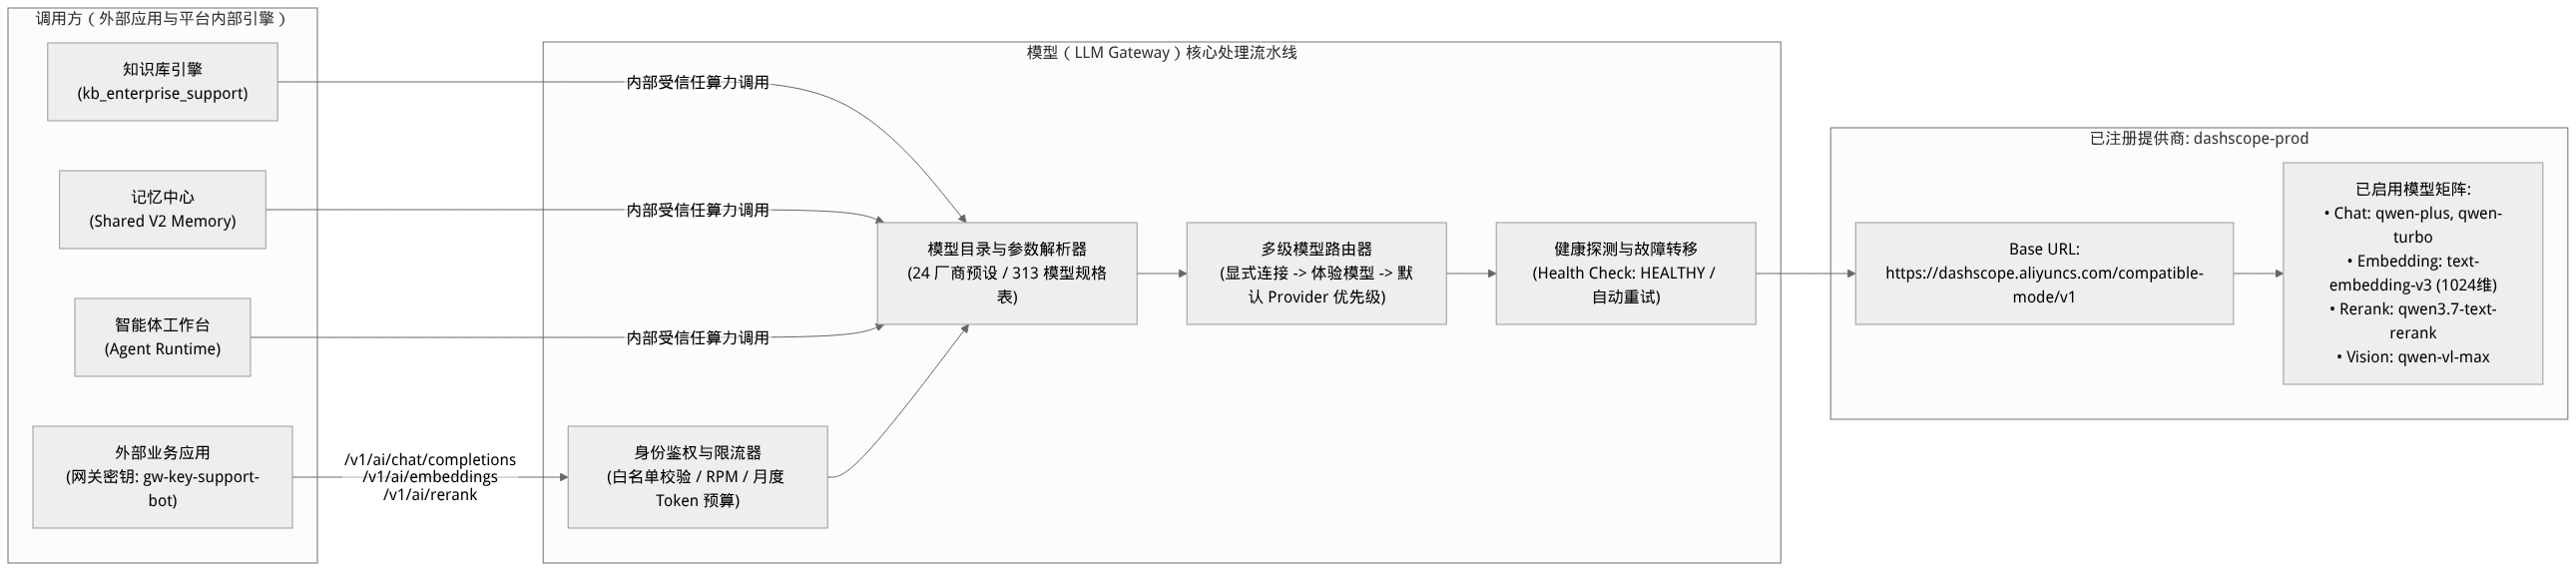
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
核心概念说明表
| 核心概念 | 英文标识 | 详细说明 |
|---|---|---|
| 模型提供商连接 | Provider | 项目与上游大模型推理服务之间的加密连接实例(如 dashscope-prod)。包含协议类型、Base URL、加密存储的 API Key、启用的能力集合及模型参数表。 |
| 厂商预设目录 | Provider Preset Catalog | 平台内置的 24 个主流厂商(含通义千问 DashScope、火山方舟、DeepSeek、OpenAI、Anthropic、vLLM 等)与 313 个标准模型模板。选择预设后可一键导入模型的上下文窗口、最大输出与向量维度。 |
| 模型能力分类 | Capabilities | 分为四类标准能力:chat(对话与文本生成)、embedding(文本与多模态向量化)、rerank(召回结果语义重排)、vlm(视觉图片理解)。下游模块按能力标签过滤可选模型。 |
| 按模型参数 | Model Parameters | 绑定在具体模型条目上的精细规格参数,包括 contextWindow(上下文窗口)、maxOutputTokens(最大输出 Token)、embeddingDimension(向量维度,如 1024)、maxInputTokens(最大嵌入输入 Token)等。 |
| 网关密钥 | Gateway Key | 格式为 abk_... 的项目级推理专用密钥(如 gw-key-support-bot)。自带项目路由上下文,调用时无需额外传递 X-Appwrite-Project 请求头。 |
| 平台体验模型 | Trial Model Binding | 由平台管理员全局配置并授权给项目试用的受管模型。项目成员可在不接触底层供应商密钥的情况下直接选用体验模型完成原型验证。 |
角色、入口与关联关系
角色权限要求
| 操作项 | Owner / Admin | Developer | 只读成员 / 访客 |
|---|---|---|---|
| 查看已注册 Provider 列表、模型目录与健康状态 | 支持 | 支持 | 支持 |
| 新增、编辑、删除 Provider 连接或更新上游 API Key | 支持 | 仅限授权开发者 | 不支持 |
| 触发模型发现(Discover)与健康探测(Health Check) | 支持 | 支持 | 不支持 |
| 创建、编辑限额或吊销网关密钥(Gateway Key) | 支持 | 仅限授权开发者 | 不支持 |
| 查看项目模型调用量与 Token 统计报表 | 支持 | 支持 | 支持 |
控制台入口与下游模块映射
控制台路径:进入组织
Agentbase 企业智能中台-> 选择项目企业智能客服与知识中台 (enterprise-ai-hub-210)-> 左侧导航栏点击 模型(Models)。下游能力绑定映射(以标杆连接
dashscope-prod为例):qwen-plus(Chat):绑定至 智能体工作台(Agent Runtime) 作为在线客服主对话模型,同时用于 知识库 的answer=true接地答案合成、GraphRAG 实体关系抽取、Wiki 自动编译与 记忆中心 的长期事实抽取。qwen-turbo(Chat):作为高并发轻量对话模型与 AI 网关 逻辑模型lm-enterprise-chat的故障转移备选模型。text-embedding-v3(Embedding,1024 维):绑定至 知识库kb_enterprise_support与 记忆中心,负责文档分块(Chunk)向量化、知识图谱节点嵌入及查询向量生成。qwen3.7-text-rerank(Rerank):绑定至 知识库 混合检索(searchMode=hybrid)流水线,对向量与全文召回的候选片段执行 Cross-Encoder 语义精排。qwen-vl-max(Vision / VLM):绑定至 知识库 的图片理解(Image Understanding)与 VLM 文档解析器,自动解读文档中的架构图、流程图与扫描表格。
功能详解与操作指南
一、通过厂商预设注册生产级提供商(dashscope-prod)
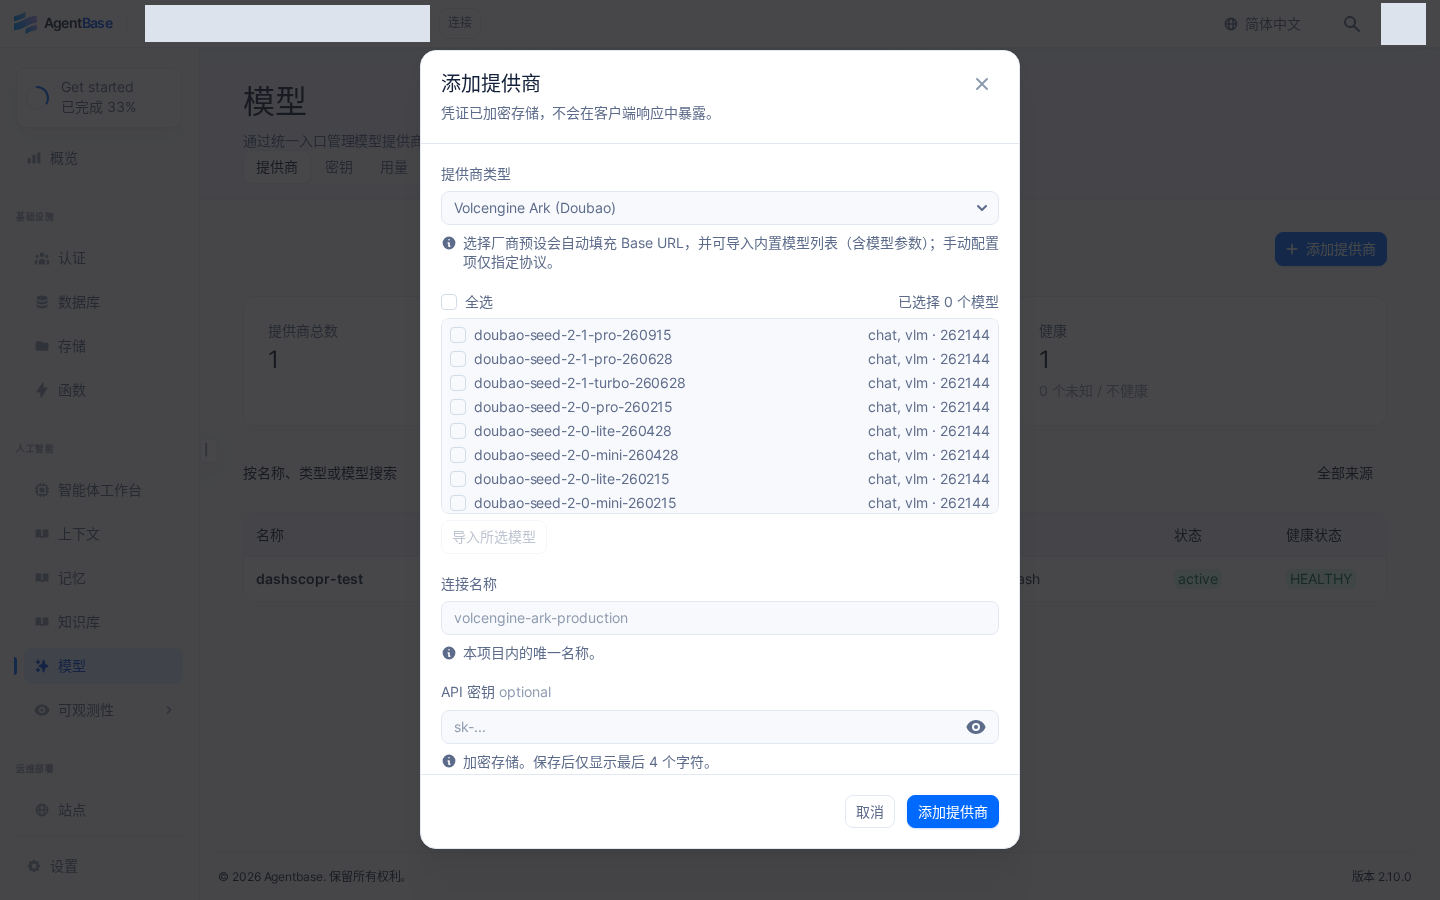
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
操作步骤
在 模型(Models) 页面切换到 模型提供商(Providers) 页签,点击右上角 添加提供商(Add provider) 按钮。
在弹窗顶部的 创建方式 中选择 厂商预设(推荐),从厂商下拉列表中选择 通义千问(DashScope)。
按照下表填写
dashscope-prod的核心配置参数:
| 配置字段 | 参数名 | 标杆配置值 | 字段说明与校验规则 |
|---|---|---|---|
| 连接名称 | name | dashscope-prod | 项目内唯一标识,建议使用“厂商-环境”命名规范 |
| 协议类型 | providerType | openai / dashscope | 预设自动匹配 OpenAI 兼容协议与百炼原生扩展接口 |
| 服务地址(Base URL) | baseUrl | https://dashscope.aliyuncs.com/compatible-mode/v1 | 预设自动填充;服务端强制执行 URL/DNS 安全策略校验,禁止指向内网回环或元数据敏感地址 |
| API Key | apiKey | <DASHSCOPE_API_KEY> | 阿里云百炼 API 密钥;落库时采用 AES-GCM 加密存储,任何读取接口均不回显明文 |
| 允许能力 | enabledCapabilities | ["chat", "embedding", "rerank", "vlm"] | 勾选该连接对外暴露的模型能力类别 |
| 默认主模型 | defaultModel | qwen-plus | 当调用方未显式指定模型或平台内部任务请求默认 Chat 模型时使用的模型 |
| 对话模型列表 | chatModels | qwen-plus, qwen-turbo | 供智能体对话、知识库合成回答、图谱构建与记忆抽取调用 |
| 向量模型列表 | embeddingModels | text-embedding-v3 | 供知识库文档分块嵌入与记忆向量化调用 |
| 重排模型列表 | rerankModels | qwen3.7-text-rerank | 供知识库多路召回结果重排(Rerank)调用 |
| 视觉模型列表 | vlmModels | qwen-vl-max | 供知识库图片理解(Image Understanding)与多模态解析调用 |
| 超时时间(秒) | timeoutSeconds | 120 | 单次上游 HTTP 推理请求超时阈值,默认 120 秒 |
| 最大重试次数 | maxRetries | 2 | 遇到瞬时网络抖动或 502/503/504 时的自动重试次数 |
| 路由优先级 | priority | 10 | 数值越小优先级越高,用于跨 Provider 同名模型故障转移排序 |
| 设为默认连接 | isDefault | true(开启) | 标记为当前项目的默认模型供应商连接 |
在 内置模型导入与按模型参数 区域,勾选需要导入的模型条目,核对并确认各模型的精细参数:
| 模型标识 | 能力类型 | 上下文窗口 (contextWindow) | 最大输出 (maxOutputTokens) | 向量维度 (embeddingDimension) | 最大嵌入输入 (maxInputTokens) | 工具调用 (supportsTools) |
|---|---|---|---|---|---|---|
qwen-plus | chat | 131072 (128K) | 8192 | - | - | true |
qwen-turbo | chat | 131072 (128K) | 8192 | - | - | true |
text-embedding-v3 | embedding | - | - | 1024 | 8192 | - |
qwen3.7-text-rerank | rerank | 32768 | - | - | 4000 | - |
qwen-vl-max | vlm / chat | 32768 | 4096 | - | - | true |
点击 创建(Create) 完成注册。
二、执行模型发现与健康探测(Health Probe)
提供商创建完成后,建议立即验证上游连通性与各能力端点的可用性:
在 模型提供商 列表中找到
dashscope-prod连接行。点击操作列的 健康检查(Health Check) 按钮(或通过管理接口调用探测)。
系统将自动对已启用的
qwen-plus、text-embedding-v3、qwen3.7-text-rerank等模型发起轻量级探针请求:若上游认证通过且响应正常,连接状态更新为绿色
HEALTHY,并记录探测耗时(Latency)。若上游返回
401 InvalidApiKey或404 ModelNotFound,状态将标记为红色UNHEALTHY并展示具体错误摘要。
当上游厂商新增模型或调整模型列表时,可点击 发现模型(Discover Models) 与 刷新缓存(Refresh Cache),将最新可用模型同步至项目模型目录。
三、签发与管理网关密钥(gw-key-support-bot)
为使外部业务服务安全调用项目内的模型能力,需在 网关密钥(Keys) 页签签发受限密钥:
切换到 网关密钥(Keys) 页签,点击 创建密钥(Create key)。
填写密钥配置项:
密钥名称(Name):
gw-key-support-bot(用于企业智能客服机器人后端调用)允许的模型白名单(Allowed Models):可勾选允许访问的具体模型(如
qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank),留空则默认允许调用项目目录内的全部模型。每分钟速率限制(Rate Limit RPM):例如填写
120(默认执行端点限流为60请求/分钟)。每月 Token 预算(Monthly Token Budget):例如填写
10000000(1,000 万 Tokens),超出预算后请求将返回429 Too Many Requests。到期时间(Expires At):可选设置密钥自动失效时间戳。
点击 创建 后,弹窗会展示唯一一次明文密钥(格式如
abk_live_...)。请立即复制并妥善保存至业务系统的密钥管理服务(KMS)或环境变量中。
四、通过 OpenAI / Anthropic 兼容端点调用模型验证
签发 abk_ 网关密钥后,业务应用可直接使用标准 OpenAI SDK、Anthropic SDK 或原生 HTTP 请求访问以下四类执行端点:
1. 对话补全(Chat Completions:POST /v1/ai/chat/completions)
curl -X POST "https://appbuild.oceanbase.com/v1/ai/chat/completions" \
  -H "Authorization: Bearer <APPBASE_GATEWAY_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-plus",
    "messages": [
      {"role": "system", "content": "你是企业智能客服与知识中台助手。"},
      {"role": "user", "content": "如何排查 OceanBase 向量索引构建超时?"}
    ],
    "stream": false,
    "temperature": 0.3
  }'
2. 文本向量化(Embeddings:POST /v1/ai/embeddings)
curl -X POST "https://appbuild.oceanbase.com/v1/ai/embeddings" \
  -H "Authorization: Bearer <APPBASE_GATEWAY_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "text-embedding-v3",
    "input": [
      "OceanBase 分布式事务与向量索引排障指南",
      "AI 网关模型路由与限流计费规范"
    ],
    "dimensions": 1024
  }'
3. 语义重排(Rerank:POST /v1/ai/rerank)
curl -X POST "https://appbuild.oceanbase.com/v1/ai/rerank" \
  -H "Authorization: Bearer <APPBASE_GATEWAY_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3.7-text-rerank",
    "query": "向量索引内存不足报错 4013 怎么处理?",
    "documents": [
      "当出现 OB_ALLOCATE_MEMORY_FAILED (-4013) 时,需检查 ob_vector_memory_limit_percentage 参数配置。",
      "智能客服工单流转遵循一线坐席初审、二线专家复核的标准作业程序(SOP)。"
    ],
    "top_n": 2
  }'
4. 查询项目可用模型目录(Models:GET /v1/ai/models)
curl -X GET "https://appbuild.oceanbase.com/v1/ai/models" \
-H "Authorization: Bearer <APPBASE_GATEWAY_KEY>"验证结果:
/v1/ai/models返回聚合后的模型列表,包含qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank、qwen-vl-max及其能力标注与来源信息。切换到控制台 模型 -> 用量(Usage) 页签,可实时看到上述 Chat、Embedding 与 Rerank 调用的请求计数与 Token 消耗明细。
常见问题与排障
Q1:添加阿里云百炼(DashScope)连接时,Base URL 应该填写哪个地址?为什么 Rerank 模型也能正常工作?
在使用内置 通义千问(DashScope) 厂商预设时,推荐将 Base URL 保持为默认的 https://dashscope.aliyuncs.com/compatible-mode/v1。Agentbase 的 DashScope 适配器会自动处理协议路由:对于 qwen-plus、qwen-turbo、text-embedding-v3、qwen-vl-max 走 OpenAI 兼容路径,而对于 qwen3.7-text-rerank 等重排模型,网关底层会自动对齐百炼原生 Rerank 协议端点并统一返回标准化的排序结构,调用方无需关心底层差异。
Q2:知识库摄取长文档时提示 Embedding 输入超限(Input length exceeds maximum allowed tokens),如何调整?
在 模型 -> 模型提供商 中编辑 dashscope-prod,展开 按模型参数(Model Parameters) 找到 text-embedding-v3,检查其 最大输入 Token(Max Input Tokens) 配置(text-embedding-v3 支持最高 8192 Tokens)。同时,在知识库的分块配置(Chunking Parser)中,建议将 chunkTokenNum 设置在 512~1024 之间,确保单个分块加上标题前缀后远低于嵌入模型的输入上限。
Q3:网关密钥(abk_...)可以用来调用创建知识库或修改 Provider 的管理接口吗?
不可以。 网关密钥遵循严格的最小权限原则,仅被授权访问 /v1/ai/* 模型执行端点(Chat Completions、Embeddings、Rerank、Anthropic Messages 与模型列表查询)。任何针对 Provider、Gateway Key、知识库或数据库的增删改管理操作,均必须使用项目在 总览 -> API Keys 中签发的 Server API Key 或控制台管理员会话。
Q4:同一个模型名称在多个 Provider 中都存在时,LLM Gateway 如何决定路由到哪个连接?
如果在请求中未显式指定连接标识,LLM Gateway 会遵循以下自动路由顺序:
若该项目绑定了匹配的平台体验模型(Trial Model)且未显式指定项目连接,优先尝试体验模型路由;
在项目自建 Provider 中,优先选择标记为 默认连接(
isDefault = true) 的提供商;若存在多个可用连接,则按连接配置的 优先级(
priority) 从高到低依次路由,并在主连接发生超时或 5xx 故障时自动按重试策略故障转移至备选连接。