
文档与摄取管理
文档与摄取(Documents & Ingestion) 是知识库(如 kb_enterprise_support)将原始非结构化文件转化为高质量可检索分块(Chunks)与向量的核心生产车间。通过知识库详情页的 文档(Documents) 页签,用户可以批量上传或绑定存储桶文件、灵活配置文档解析器(text / vlm / mineru)与五种分块策略(general / title / smart / regex / faq)、管理层级分类标签与精确定位标识(documentTag、subProductId)、跟踪异步摄取状态机(202 排队 -> processing -> ready),并对生成的分块进行在线审阅、编辑与图片理解结果核验。
功能概述与核心场景
高质量的 RAG 问答效果取决于“解析准不准、分块合不合理、标签细不细”。Agentbase v2.10.0 在文档与摄取模块提供了精细化的全生命周期控制能力:
双模式文件接入与批量上传:
控制台批量直传:文件选择器支持单批次最多上传 50 个文件,自动将原始文件持久化至知识库专属存储桶(如
kb_enterprise_docs)并创建文档记录,默认上传后立即触发异步摄取。Storage 文件 ID 绑定:支持通过 API 直接引用已上传至项目存储桶(Storage)的
fileId创建文档并启动摄取,避免重复传输大文件。
三类多模态文档解析器(Document Parsers):
支持针对纯文本/Markdown 的极速解析(
text)、针对复杂扫描件与架构图的视觉大模型解析(vlm,驱动qwen-vl-max),以及针对复杂双栏 PDF、跨页表格与数学公式的深度版面还原(mineru)。支持 Excel(
.xlsx/.xls)按工作表(Sheet)结构化切片,并可叠加 图片增强(Image Understanding) 自动提取内嵌图表的语义描述。
五种可参数化分块策略(Chunking Parsers):
内置
general(通用定长滑窗)、title(按 Markdown/文档标题层级切分)、smart(语义边界智能切分)、regex(自定义正则表达式切分)与faq(问答对结构切分),支持精细调节chunkTokenNum、overlapPercent、titleLevel、minChunkTokens等参数。
双层标签治理体系(层级目录标签 +
documentTag定位标识):支持斜杠分隔的父子层级标签(如
技术支持/数据库/OceanBase),提供标签树目录视图与平铺列表视图。v2.10.0 新增定位标识
documentTag与subProductId:遵循{subProductId}_{sectionCode}_{fileKey}标准规范,支持在文档列表、混合检索与 Wiki 冲突裁决中按子产品或文档定位码做精确过滤。
分块级(Chunk-level)透明审阅与在线热修:
文档摄取变为
ready后,可在文档详情页逐个查看分块文本、Token 长度、关联图片理解摘要,并支持在线编辑修正分块文本或删除噪声分块,修改后自动重算对应向量。
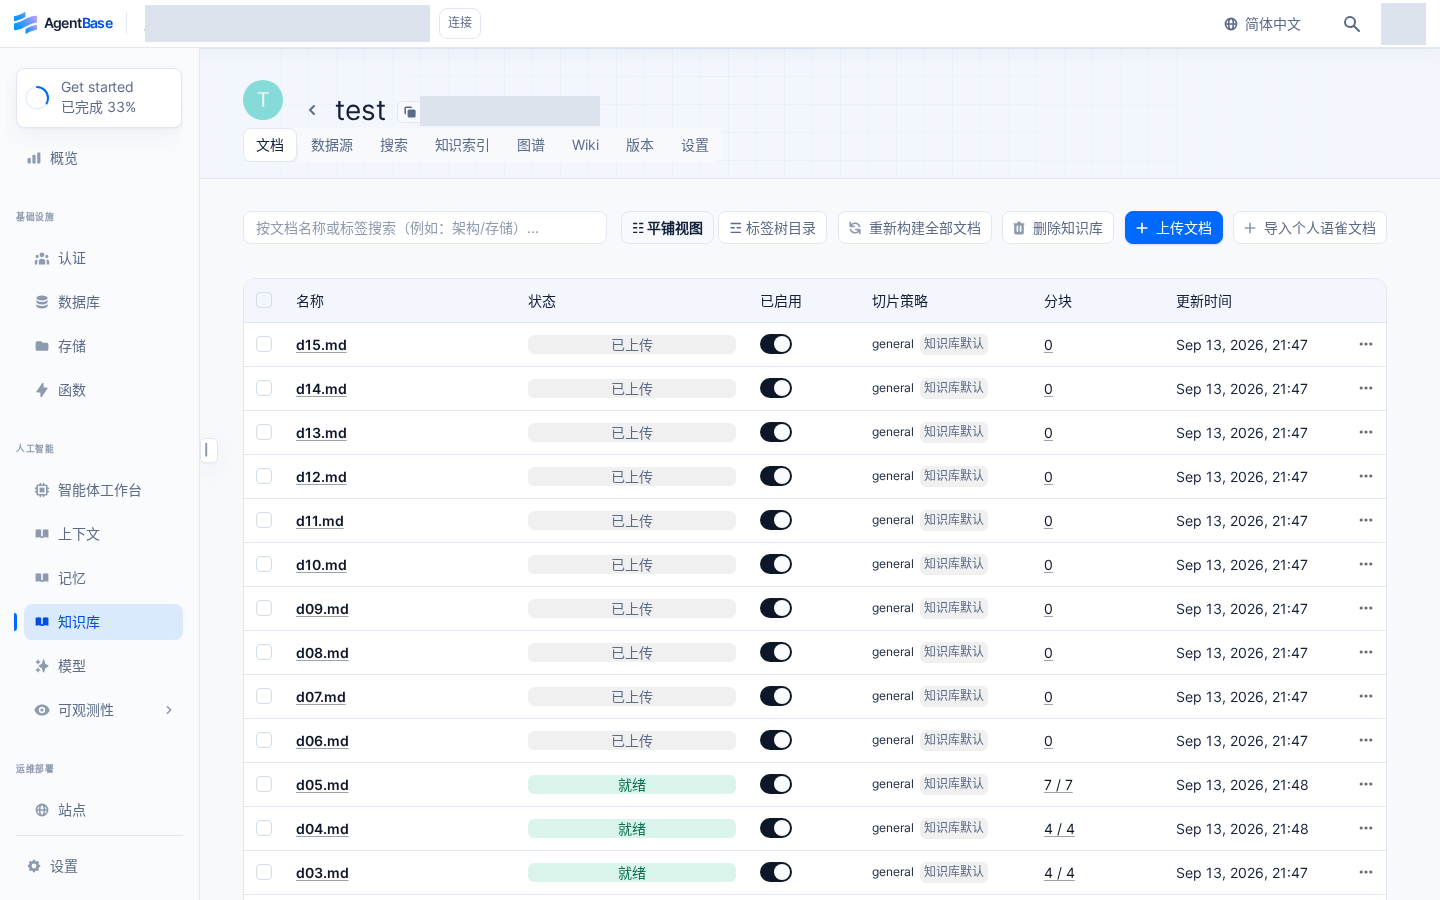
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
核心概念与架构
文档异步摄取与分块向量化状态机
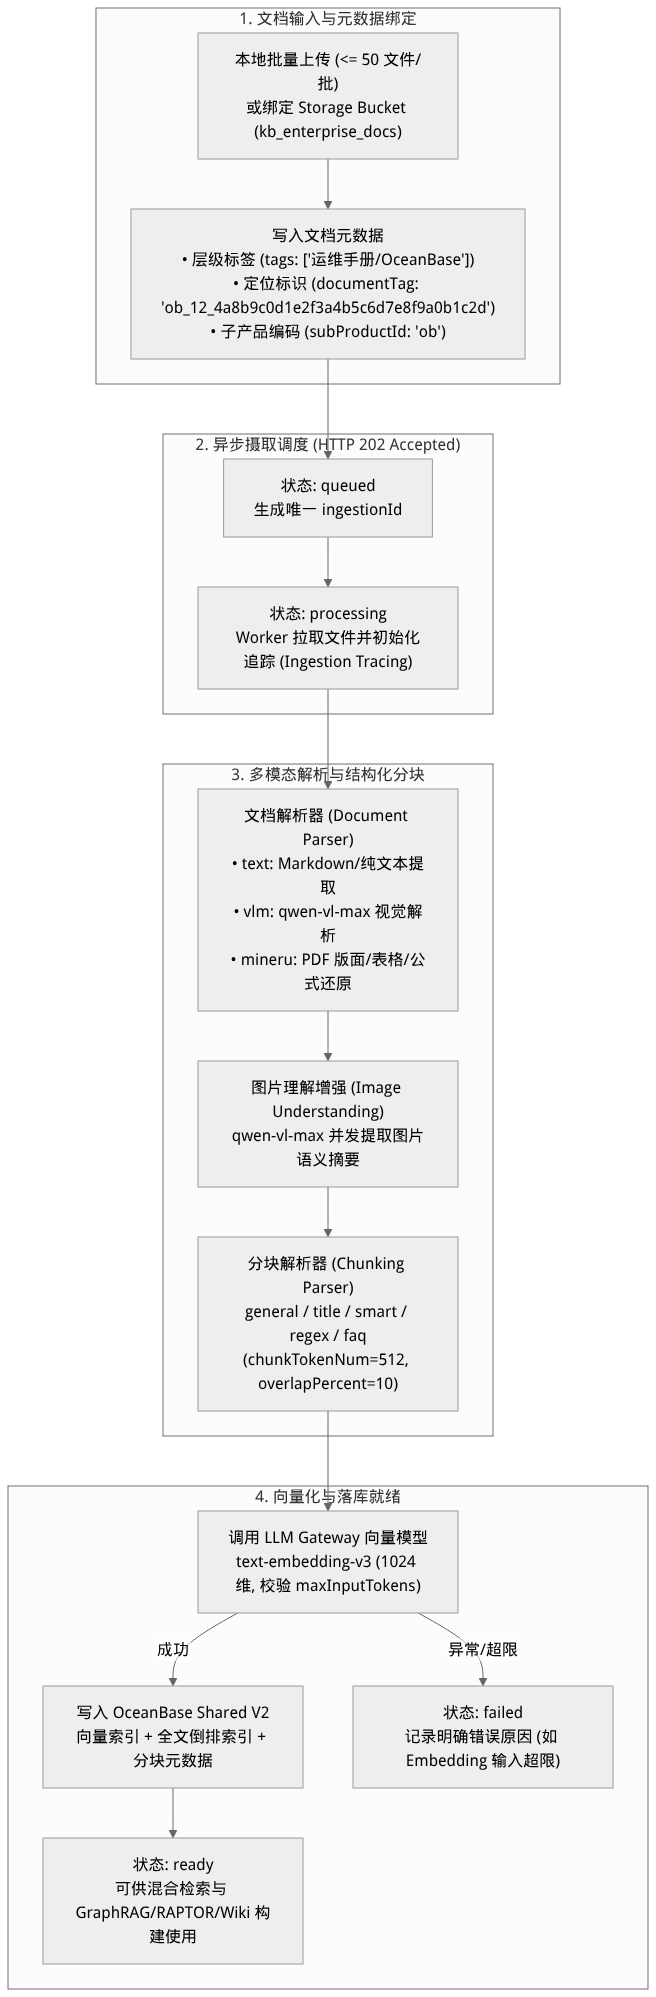
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
解析器与分块器核心概念表
| 组件维度 | 可选类型 | 适用文档场景与核心逻辑 |
|---|---|---|
文档解析器 (documentParser) | text | 适用于结构清晰的 .md、.txt、.docx、.html 及常规电子版文档,解析速度最快、零额外视觉模型开销。 |
文档解析器 (documentParser) | vlm | 调用项目已注册的视觉大模型(如 dashscope-prod 下的 qwen-vl-max)逐页识别复杂排版、扫描件、手写批注与架构流程图。 |
文档解析器 (documentParser) | mineru | 针对学术论文、技术白皮书与复杂财务报表 PDF,精准识别多栏排版、跨页表格与 LaTeX 公式并转换为结构化 Markdown。 |
分块解析器 (chunkingParser) | general | 通用滑动窗口分块。按固定的 chunkTokenNum(默认 512)与 overlapPercent(默认 10%)切分,适用无明显标题结构的长文本。 |
分块解析器 (chunkingParser) | title | 按文档标题层级(titleLevel,默认 3 即 ###)切分章节,并将父级标题路径自动注入分块上下文,非常适合架构白皮书与排障手册。 |
分块解析器 (chunkingParser) | smart | 综合段落边界、语义连贯性与最小分块阈值(minChunkTokens,默认 128)动态合并碎片段落、切分超长段落。 |
分块解析器 (chunkingParser) | regex | 按用户指定的正则表达式(regexPattern)切分文档,适用于日志归档、特定格式法条或标准化条目文件。 |
分块解析器 (chunkingParser) | faq | 专门针对「问:... 答:...」或雙列问答表格,确保每一对 Q&A 完整保留在同一个独立分块中,不被截断。 |
功能入口与权限矩阵
控制台入口、REST API、SDK 方法与权限矩阵
| 控制台入口 / 功能模块 | 前端路由路径 | 对应 REST API 端点 | Server SDK 方法(Node.js / Python) | 所需 RBAC 角色 / API Key Scope | 跨模块依赖关系 |
|---|---|---|---|---|---|
文档列表、目录树与 documentTag 筛选 | /console/project-default-enterprise-ai-hub-210/knowledge-base/kb-kb_enterprise_support/documents | GET /v1/knowledgebases/{kbId}/documents | knowledgeBase.listDocuments() / list_documents() | 角色:owner、admin、developer、member(只读)Scope: knowledgebases.read | 支持按层级 tags、documentTag、subProductId 过滤 |
| 批量上传文档或绑定存储桶文件 | /console/.../kb-kb_enterprise_support/documents(点击「上传文档 Upload documents」) | POST /v1/knowledgebases/{kbId}/documents | knowledgeBase.createDocument() / create_document() | 角色:owner、admin、developerScope: knowledgebases.write | 创建文档记录返回 HTTP 201;摄取任务异步处理 |
| 查询异步摄取进度与触发重摄取 | 文档列表状态徽章与行操作「重新摄取(Re-ingest)」 | POST /v1/knowledgebases/{kbId}/documents/{docId}/ingestionsGET .../ingestions/{ingestionId} | knowledgeBase.createIngestion()knowledgeBase.getIngestion() | 角色:owner、admin、developerScope: knowledgebases.write / read | 依赖 dashscope-prod 的 text-embedding-v3(1024 维)与 qwen-vl-max(详见 知识库设置) |
| 编辑文档标签与定位标识 | 文档行操作「编辑标签(Edit tags)」 | PATCH /v1/knowledgebases/{kbId}/documents/{docId} | knowledgeBase.updateDocument() | 角色:owner、admin、developerScope: knowledgebases.write | documentTag 联动 混合检索、知识图谱 与 Wiki 冲突工作台 |
| 分块(Chunks)透明审阅与在线热修 | /console/.../kb-kb_enterprise_support/documents/{docId} | GET /v1/knowledgebases/{kbId}/documents/{docId}/chunksPATCH .../chunks/{chunkId} | knowledgeBase.listChunks()knowledgeBase.updateChunk() | 角色:owner、admin、developer(只读成员仅查看)Scope: knowledgebases.write | 编辑分块后自动重算 1024 维向量并将 高级知识索引 标记为 stale (chunk_updated) |
| 导入语雀 URL 与外部数据源同步 | 文档页「导入语雀 URL」或 数据源 页签 | POST /v1/knowledgebases/{kbId}/datasources/{id}/sync | knowledgeBase.syncDataSource() | 角色:owner、admin、developerScope: knowledgebases.write | 完整 OAuth2 与个人令牌同步指南详见 外部数据源接入与语雀增量同步 |
功能详解与操作指南
一、上传企业知识文档并配置分块参数
在标杆知识库 kb_enterprise_support 中,我们摄取了 4 篇核心生产文档。以下是具体操作步骤:
在知识库 文档(Documents) 页签点击右上角 上传文档(Upload documents)。
拖拽或选择本地文件(单次最多支持 50 个文件):
Agentbase企业架构白皮书.md智能客服SOP标准作业手册.mdOceanBase分布式事务与向量索引排障指南.mdAI网关模型路由与限流计费规范.md
在上传配置面板中设置解析与分块参数(可保持知识库默认值,也可针对当前批次单独定制):
| 参数名称 | 字段标识 | 推荐配置值 | 取值范围与说明 |
|---|---|---|---|
| 立即开始摄取 | autoIngest | true(开启) | 上传完成后立即创建异步摄取任务(返回 202) |
| 文档解析器 | documentParser | text(PDF 选 mineru 或 vlm) | 可选 text / vlm / mineru |
| 分块解析器 | chunkingParser | title | 可选 general / title / smart / regex / faq |
| 目标分块 Token 数 | chunkTokenNum | 512 | 建议范围 128~2048,须小于 Embedding 模型的 maxInputTokens |
| 分块重叠比例(%) | overlapPercent | 10 | 相邻分块保留 10% 的重叠上下文,防止跨块语义断裂 |
| 标题切分层级 | titleLevel | 3 | 仅 title 模式生效,按 H1/H2/H3 标题切分章节 |
| 最小分块 Token 数 | minChunkTokens | 128 | 低于该阈值的短小章节自动与相邻同级段落合并 |
| 开启图片理解 | imageUnderstanding.enabled | true | 调用 qwen-vl-max(并发度 1–8,推荐 4)生成图片文字解读 |
二、管理层级标签与定位标识(documentTag & subProductId)
为了在海量文档中实现毫秒级定向检索与目录治理,Agentbase 支持两套互补的标签机制:
1. 层级目录标签(Hierarchical Tags)
在文档列表中点击目标文档右侧的 编辑标签(Edit tags)。
输入以
/分隔的父子层级标签,例如:为
OceanBase分布式事务与向量索引排障指南.md添加标签:技术支持/数据库/OceanBase为
AI网关模型路由与限流计费规范.md添加标签:技术支持/AI平台/AI网关为
智能客服SOP标准作业手册.md添加标签:客服运营/标准作业/SOP
点击文档列表左上角的视图切换按钮,可在 目录树视图(Folder Tree View) 与 平铺列表视图(Flat View) 之间自由切换。
2. 文档定位标识(documentTag 与 subProductId)
自 v2.10.0 起,每篇文档均可绑定结构化的定位标识 documentTag 与子产品编码 subProductId:
格式规范:
documentTag必须符合{subProductId}_{sectionCode}_{fileKey}格式,其中fileKey为 32 位十六进制字符串(如ob_12_4a8b9c0d1e2f3a4b5c6d7e8f9a0b1c2d)。自动派生规则:创建或更新时,同时提交非空
documentTag并省略或清空subProductId,系统会从定位标识首段派生子产品编码。清除与有效过滤值:更新时,传入
subProductId: ""且不同时提交非空documentTag,会删除独立字段;但读取与过滤仍会回退到已有定位标识的首段。若要去掉这两处子产品关联,可同时清空subProductId与documentTag;这也会移除文档定位标识,应先确认调用方不再依赖该定位值。通过 API 更新文档定位标识并查询摄取状态示例:
# 1. 为文档写入 documentTag 与层级标签
curl -X PATCH "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/documents/doc_ob_troubleshooting" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "documentTag": "ob_12_4a8b9c0d1e2f3a4b5c6d7e8f9a0b1c2d",
    "subProductId": "ob",
    "tags": ["技术支持/数据库/OceanBase", "核心排障"]
  }'

# 2. 触发单文档重新摄取(返回 HTTP 202 Accepted 与 ingestionId)
curl -i -X POST "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/documents/doc_ob_troubleshooting/ingestions" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>"

# 3. 轮询摄取任务状态直至变为 ready
curl -X GET "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/documents/doc_ob_troubleshooting/ingestions/ing_9f8e7d6c5b4a3210" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>"
三、审阅与编辑分块(Chunks)及整库重建(Reindex)
查看分块列表:在文档列表中确认
Agentbase企业架构白皮书.md等 4 篇文档状态均为绿色的ready后,点击文档名称进入 文档详情(Document Details) 页。检查与在线编辑分块:
页面按顺序展示切分出的全部 Chunk 卡片,每张卡片显示分块序号、Token 计数、章节路径与正文内容。
若开启了图片理解,含图分块下方会展示由
qwen-vl-max生成的 图片理解摘要(Image Caption / VLM Summary)。点击任意分块卡片右上角的 编辑(Edit),可直接修正错别字、补充关键上下文或更新专有参数;保存后系统会自动调用
text-embedding-v3重新计算该分块的1024维向量并更新 OceanBase 索引。
整库重建(Reindex):
当您在知识库设置中修改了全局默认分块策略(如将
chunkTokenNum从512改为800)后,回到 文档 页签顶部点击 整库重建(Reindex),系统将批量为库内全部文档派发异步重新摄取任务。
外部数据源(Data Sources)与语雀同步管理
一、配置语雀(Yuque)数据源连接
在 kb_enterprise_support 知识库中接入企业语雀技术文档空间,支持 OAuth 2.0 授权接入 与 Access Token 接入 两种方式:
步骤 1:打开新建数据源向导
进入知识库
kb_enterprise_support详情页,切换到 数据源(Data sources) 页签。点击右上角 添加数据源(Add data source) 按钮,数据源类型选择 语雀(Yuque)。
步骤 2:完成身份认证与空间绑定
根据企业安全规范填写数据源连接参数:
| 配置项 | 参数名 | 标杆配置示例 | 说明与校验规则 |
|---|---|---|---|
| 数据源名称 | name | 企业技术支持语雀知识库 | 知识库内可读名称,便于区分不同团队的语雀空间 |
| 数据源类型 | type | yuque | 当前内置支持语雀知识库连接器 |
| 认证方式 | authType | oauth 或 token | 推荐使用 OAuth 一键跳转授权;自动化流水线可使用语雀 Personal Access Token |
| 语雀服务地址 | baseUrl | https://www.yuque.com(或企业专属语雀域名) | 自动通过服务端安全 URL 白名单与 DNS 校验 |
| 访问令牌 | accessToken | <YUQUE_ACCESS_TOKEN> | 落库时加密存储,读取接口永不回显明文 |
| 目标知识空间标识 | namespace / repoId | ob-support/kb-handbook | 格式为 团队或个人Login/知识库Slug 或语雀 Book 数字 ID |
| 默认标签前缀 | defaultTags | ["语雀同步/技术支持"] | 同步入库的文档自动打上该层级标签,便于在文档目录树中归类 |
| 默认子产品编码 | subProductId | ob | 为同步进入的文档自动关联子产品标识 |
点击 测试连接并保存(Test & Create),系统会验证远端空间读取权限并生成唯一的 dataSourceId(如 ds_yuque_enterprise_01)。
二、从外部数据源选择性批量导入文档
如果您只需要将语雀空间中的部分核心文档(例如《智能客服SOP标准作业手册》与《AI网关模型路由与限流计费规范》)导入知识库,可使用交互式目录树导入功能:
在 数据源(Data sources) 列表中点击
企业技术支持语雀知识库右侧的 浏览并导入(Browse & Import)。弹窗左侧会实时加载远端语雀知识库的章节目录树(TOC),展示每篇文档的标题、Slug 与最后更新时间。
勾选需要导入的目标文档,在右侧确认解析配置:
文档解析器:选择
text(若语雀文档包含大量流程图与架构截图,建议开启 图片理解 Image Understanding 并选用qwen-vl-max)。分块策略:选择
title(chunkTokenNum = 512,overlapPercent = 10)。
点击 开始导入(Start Import),系统会在后台拉取选中文档的 Markdown 源码与图片附件,写入
kb_enterprise_docs存储桶并自动派发异步摄取任务。
三、触发增量同步作业(Sync Runs)与状态监控
当远端语雀知识库中的排障指南或 SOP 发生日常修订时,可通过控制台或 API 触发数据源同步作业:
1. 控制台触发与监控
在 数据源(Data sources) 页签找到目标数据源
ds_yuque_enterprise_01,点击 立即同步(Sync now)。展开数据源下方的 同步记录(Sync runs) 面板,可实时查看每一次同步作业的执行状态机与统计计数:
| 同步状态 | 状态标识 | 含义说明 |
|---|---|---|
| 排队中 | queued | 同步请求已被接受,正在等待后台同步 Worker 调度 |
| 同步中 | running | 正在拉取远端语雀目录、比对文档修订版本并触发变更文档的重新摄取 |
| 已完成 | completed | 全部新增与变更文档均已成功拉取并提交摄取流水线 |
| 部分失败 | partial_failed | 大部分文档同步成功,个别文档因远端权限受限或格式异常失败(可查看错误明细并重试) |
| 已失败 | failed | 远端 Token 失效、网络不可达或空间被删除导致同步中断 |
2. 通过 REST API 管理数据源与触发同步
后端研发或 CI/CD 定时流水线可通过以下标准接口自动化触发增量同步:
# 1. 查询知识库已挂载的数据源列表
curl -X GET "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/datasources" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>"

# 2. 触发指定数据源的增量同步作业 (POST /v1/knowledgebases/{knowledgeBaseId}/datasources/{dataSourceId}/syncs)
curl -X POST "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/datasources/ds_yuque_enterprise_01/syncs" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "syncMode": "incremental",
    "triggerIngest": true
  }'

# 3. 查询同步作业运行记录与变更统计
curl -X GET "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/datasources/ds_yuque_enterprise_01/syncs" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
-H "X-Appwrite-Key: <APPBASE_API_KEY>"验证结果:
接口返回新创建的同步运行记录(含
syncId、status、addedCount、updatedCount、skippedCount、failedCount)。回到 文档(Documents) 页签,可以看到发生更新的文档已自动完成重新分块与向量更新,状态恢复为
ready,且检索测试(Search)中的来源链接(View Source)可直接跳转或预览最新内容。
上传与摄取文档
进入知识库 → 上传文档:文件选择器支持单批最多 50 个文件;文件上传到知识库专属存储后创建文档记录。默认上传后立即开始摄取,也可以关闭自动摄取。
等待文档状态变为 Ready,再打开文档详情查看分块。文档未就绪时先检查该文档的状态与处理结果,不要把尚未完成摄取的文档当作可检索内容。
需要调整解析器或分块参数时,先在该文档配置中修改,再对受影响文档重新摄取。配置变更不会回写到已摄取的旧文档。
Reindex 对知识库中的全部文档重新执行摄取与索引;只需更新少量文档时优先使用逐文档重新摄取。
URL / 外部数据源:通过 Data sources 接入;当前内置的数据源类型为语雀(Yuque,含 OAuth 授权导入与 URL 导入),支持查看同步记录与管理数据源。
文档与分块管理
文档列表支持按名称或标签检索、删除文档和打开文档详情;详情页按分块(chunk)组织摄取内容。
层级标签用于组织文档,可通过标签树或平铺视图浏览;定位标识(documentTag,2.10.0)用于精确标记产品、章节和文件。两者用途不同,不要把层级标签路径写入
documentTag。创建 / 更新文档可写定位字段;格式、派生和清除边界见本页“文档定位标识”小节。写入后可在文档列表与检索中按实际定位值过滤(见检索测试)。
分块支持编辑与删除;开启图片理解后,分块的图片理解结果可在文档详情中查看。
Excel 摄取:表格按工作表(sheet)切片解析;可配置图片增强(图片解读模型、提示词与并发度 1–8),提升含图表格与文档的摄取质量。
嵌入输入限制:嵌入模型的最大输入 Token 在 Models(LLM Gateway)的 Provider 表单「最大输入 Token」配置;超限的摄取输入会显式失败。
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
常见问题与排障(FAQ)
Q1:文档摄取状态变成 failed,报错提示 Embedding 输入超限,该如何排查与解决?
原因分析: 当单个分块的 Token 长度超过了
dashscope-prod中为text-embedding-v3配置的maxInputTokens时,摄取任务会显式失败以防止截断丢数。解决措施:
前往 模型(LLM Gateway)-> 模型提供商,检查
text-embedding-v3的最大输入 Token 配置(可设为8192);点击该失败文档右侧的 解析配置(Parser Config),将
chunkTokenNum调小(如512)或将分块器由regex改为smart/title,然后点击 重新摄取(Re-ingest)。
Q2:扫描版 PDF 或包含大量架构图的文档,使用默认 text 解析器提取不出文字怎么办?
原因分析: 默认
text解析器仅提取文档内嵌的原生文本流,不会对光栅化图片或扫描页执行视觉 OCR 与拓扑理解。解决措施:
请先确认已在 模型(LLM Gateway) 的
dashscope-prod连接中启用了vlm能力并导入了qwen-vl-max;将该文档的文档解析器切换为
vlm或mineru,并在 知识库设置中心 开启 多模态图片理解(Image Understanding) 开关后重新摄取。
Q3:documentTag 的格式有什么校验要求?如果格式不合法会怎样?
原因分析:
documentTag遵循{subProductId}_{sectionCode}_{fileKey}的三段式规范:首段仅允许字母或数字,第二段仅允许数字,两段可为空;末段fileKey必须为 32 位十六进制字符(接受大小写,写入时统一为小写)。独立subProductId的非空值限 1–64 位字母或数字,不接受连字符、下划线或空格。解决措施: 如果传入的字符串不符合格式约束,API 会返回
400 Bad Request参数校验错误。请确保按{subProductId}_{sectionCode}_{32位hex}构造,或若仅需自由文本分类,请使用文档的 层级标签(tags) 字段。
Q4:Excel 表格上传后是如何被切分和向量化的?
原因分析: 表格数据具有强行列结构关联,若按普通纯文本滑动窗口切分会导致数据行脱离表头(Header)而丧失语义。
解决措施: Excel 文件(
.xlsx/.xls)由内置表格解析器按 工作表(Sheet) 进行结构化切片,自动在每个分块中保留表头(Header)与数据行的对应关系;若表格内嵌有业务截图且开启了图片理解,系统会按配置的并发度调用qwen-vl-max生成图片说明并归入对应 Sheet 的分块中。