
在线与数据集评估、知识库评测与根因分析
功能概述
在线与数据集评估(Evaluations & Root Cause Analysis,控制台入口为 智能体运维 → 评估 与 评估技能)是 Agentbase(v2.10.0)提供的全场景自动化质量度量与智能归因引擎。在企业大模型应用落地过程中,仅靠人工抽检无法覆盖海量线上对话,也难以量化每次 Prompt 调整、模型切换或知识库分块/索引参数变更带来的真实收益或退化。
在 Agentbase 企业智能中台(69c6d1aa00062e6bb60)的标杆项目 企业智能客服与知识中台(enterprise-ai-hub-210)中,评估引擎基于 dashscope-prod 下的 qwen-plus(默认评估模型)与 qwen-vl-max(视觉评估模型),提供四大类专业评估任务与端到端根因诊断闭环:
通用评估(General Evaluations):支持平台内置三语模板(正确性、忠实度、幻觉、RAG 查询质量、上下文相关性、SQL 语义等价、会话意图跟随等)与项目自定义模板(含绑定只读 Evaluation Skills 与 AI Gateway 只读 MCP 取证工具 的自定义 Agent 评估器),支持对在线 Trace、Observation、Session 或数据集运行(Dataset Run)自动打分;
Memory 专项评估(Memory Evaluations):按 Memory 流水线的 10 个核心阶段(事实抽取、更新/遗忘决策、画像提取、技能蒸馏、经验蒸馏、知识合并、知识验证、查询改写、检索等)进行精细化评测;
知识库解析与分块质量评估(Parsing & Chunking Quality):对知识库
kb_enterprise_support的文档解析(完整性、忠实度、结构三维)与切片分块(边界、上下文、独立完整性、大小、冗余五维)按各占 50% 权重打分,支持逐页/逐块下钻与视觉模型核验;知识索引质量评估(Knowledge Index Quality,
v2.10.0重磅能力):对 GraphRAG、RAPTOR 与 LLM Wiki 三类高级索引产物执行“规则全量检查 + 分层确定性抽样模型评估 + 二次独立复核(Grounding Review)”,并结合scoreAnalysis根因分析与参数对照建议 定位质量瓶颈。
核心概念与架构
评估系统将“评测模板与技能管理 → 多源目标变量映射 → 异步评测执行与二次复核 → 低分自动/手动根因分析(RCA)”整合在一条可验证、防篡改的流水线中。
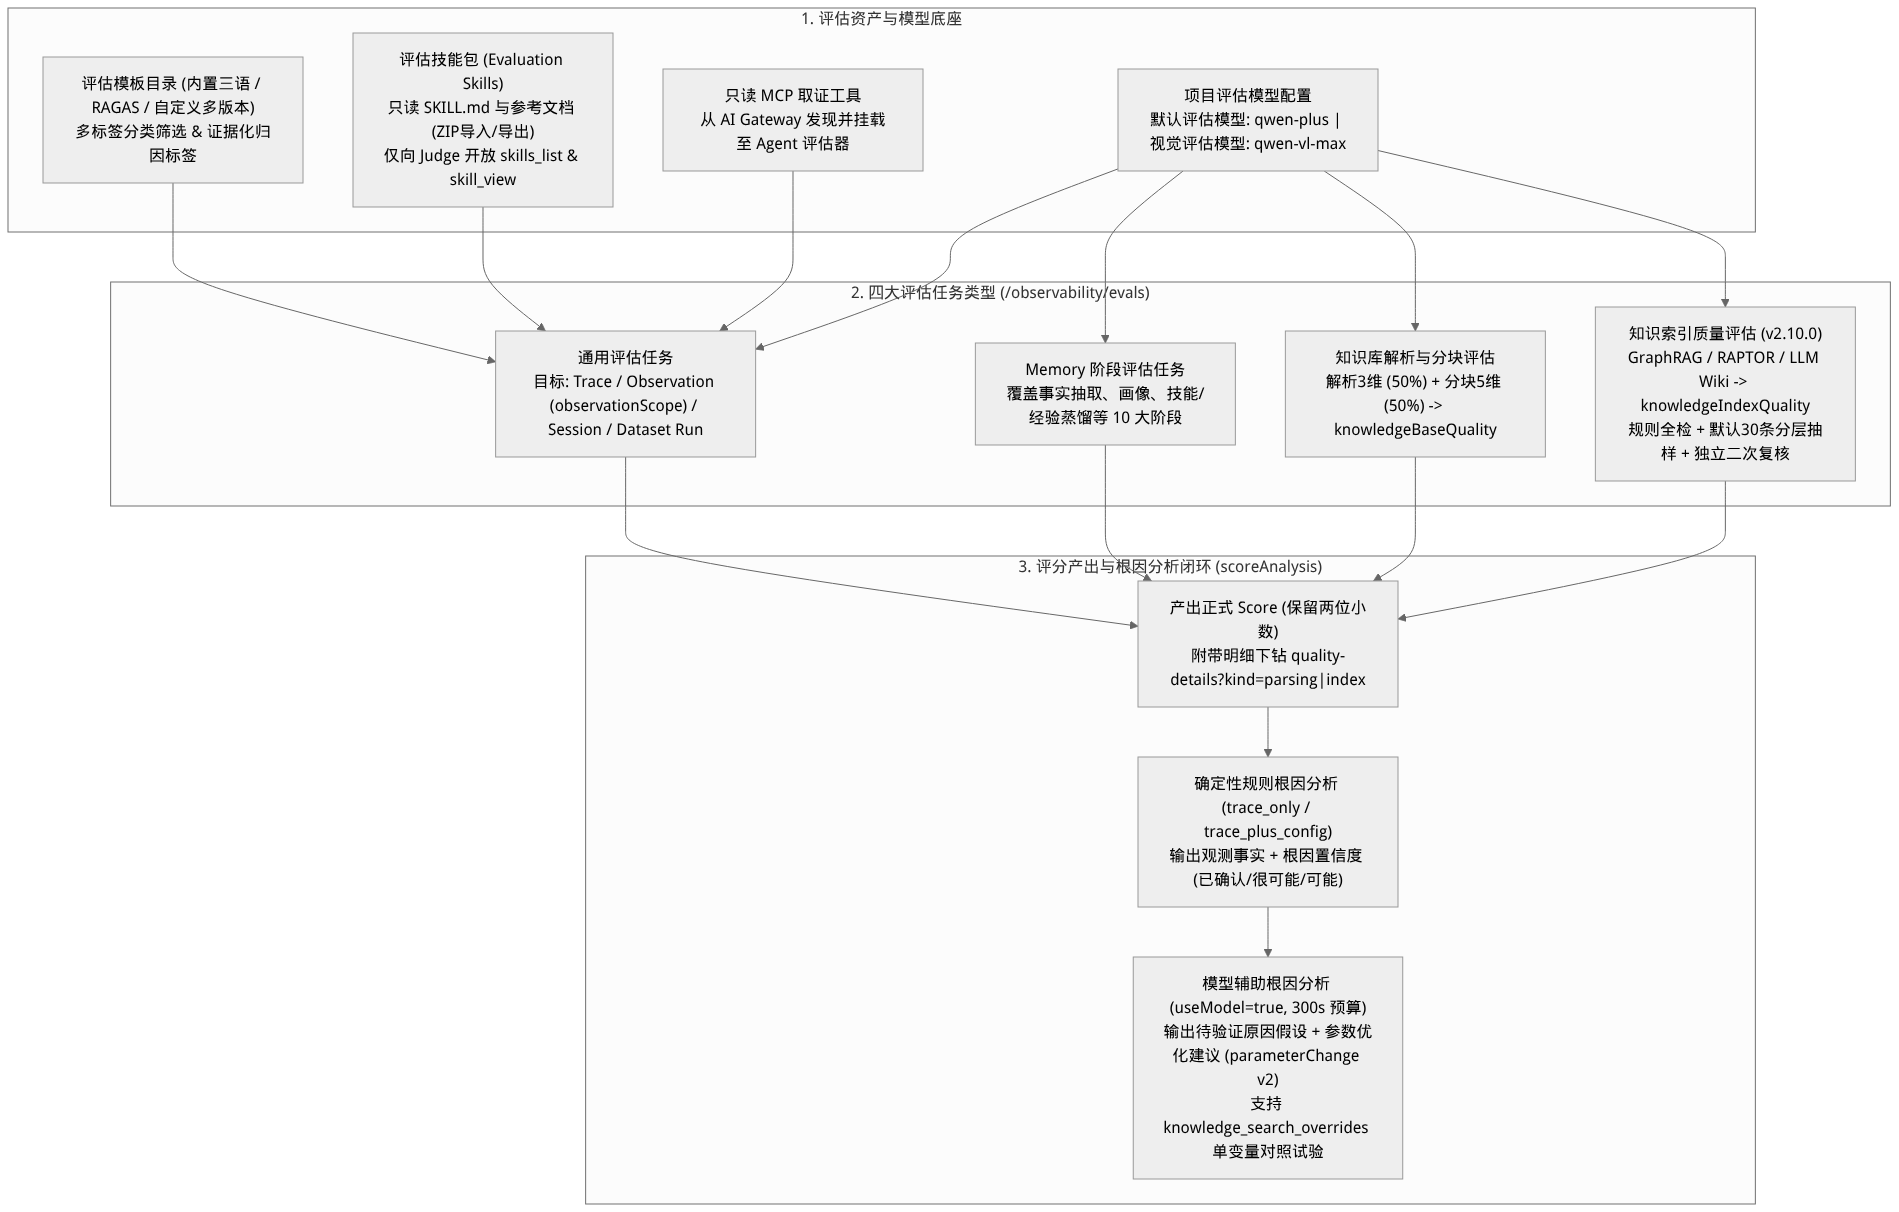
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
四大评估任务类型与适用场景对照表
| 任务类型 | 评测对象与数据来源 | 核心评测维度与算法机制 | 评分元数据标识 |
|---|---|---|---|
| 通用评估 | 单条/批量 Trace、特定 Observation(通过 observationScope 按类型与名称规则扇出)、Session 或 Dataset Run | 使用 LLM-as-a-Judge 模板(Prompt / Program / Agent 执行方式)映射 input、output、expected_output、trajectory 等变量打分。 | 标准 EVAL Score(智能体工作台专用 RAG 模板生成 ragEvaluation 签名元数据) |
| Memory 评估 | 项目内带 capability:memory 的记忆操作链路 | 针对事实抽取、冲突更新决策、画像生成、技能蒸馏、经验蒸馏、知识合并/验证、查询改写与检索共 10 类流水线阶段执行证据核查。 | EVAL Score(关联 Memory 阶段归因标签) |
| 知识库解析评估 | 开启了摄取追踪(tracingEnabled=true)的知识库文档与切片(如 kb_enterprise_support) | - 文档解析(占 50%):完整性、忠实度、结构 3 个维度; - 文档分块(占 50%):边界合理性、上下文保留、独立完整性、块大小、冗余度 5 个维度。支持 PDF/图片页调用 qwen-vl-max 视觉比对。 | knowledgeBaseQuality(下钻接口 quality-details) |
知识索引质量评估(v2.10.0) | 已成功构建索引产物的知识库版本(GraphRAG / RAPTOR / LLM Wiki) | - GraphRAG:实体描述忠实度、关系支持度、社区报告忠实度与覆盖; - RAPTOR:摘要忠实度、关键内容覆盖、层级摘要一致性; - LLM Wiki:页面忠实度、引用支持度、内容覆盖、跨页面一致性。 三类各自独立聚合成 0~1 能力级质量分(不合成总分)。 | knowledgeIndexQuality(下钻接口 quality-details?kind=index) |
角色、入口与关联关系
控制台入口与 REST API 权限矩阵
控制台入口位于:项目 enterprise-ai-hub-210 → 智能体运维(Observability / AgentOps) → 评估(Evals) 及 评估技能(Evaluation Skills)。
| 功能模块 | 控制台路径后缀 | 核心 REST API 端点 | 所需权限 Scope |
|---|---|---|---|
| 评估模板与任务管理 | /observability/evals | /v1/observability/evals/* | observability.evals.read / write |
| 默认/视觉评估模型与模型 RCA 开关 | /observability/evals(顶部模型设置区) | GET/PUT /v1/observability/evals/root-cause-analysis-settings | observability.models.read / write |
| 知识索引质量评估预览与创建 | 创建评估任务 → 知识库解析评估(勾选索引能力) | POST /v1/observability/evals/index-preview、POST /v1/observability/evals/index | observability.evals.write + 知识库读取权限 |
| 评分明细下钻(解析/分块/索引) | 评分详情页 质量明细 | GET /v1/observability/scores/{scoreId}/quality-details?kind=index | observability.scores.read |
| 评估技能包管理与 ZIP 下载 | /observability/evaluation-skills | GET/POST /v1/observability/evaluation-skills、GET .../:skillId/versions/:versionId/download | observability.evals.read / write |
| Prompt 确定性解析 | /observability/prompts | GET /v1/observability/prompts/resolve | observability.prompts.read |
功能详解与操作指南
1. 浏览评估模板目录与配置默认/视觉评估模型
进入项目
enterprise-ai-hub-210的 智能体运维 → 评估(Evals) 页面。在页面顶部模型配置区,确认已绑定项目的默认评估模型(如
dashscope-prod下的qwen-plus)与视觉评估模型(如qwen-vl-max),并可按需开启 使用模型进行根因分析(useModel) 开关。在 模板目录 中,支持按来源(平台内置、RAGAS、项目自定义)、评测轮次(单轮 / 多轮 / 轨迹)以及多标签分类筛选模板:
平台内置模板全面支持
zh-CN、en-US、ja-JP三语,涵盖正确性(Correctness)、忠实度(Faithfulness)、上下文相关性(Context Relevance)、RAG 查询质量(Query Quality)、SQL 语义等价、会话意图跟随以及知识索引质量模板;自定义模板支持多版本管理(发布新版本时保留历史版本供既有任务重放,支持配置证据化归因标签)。
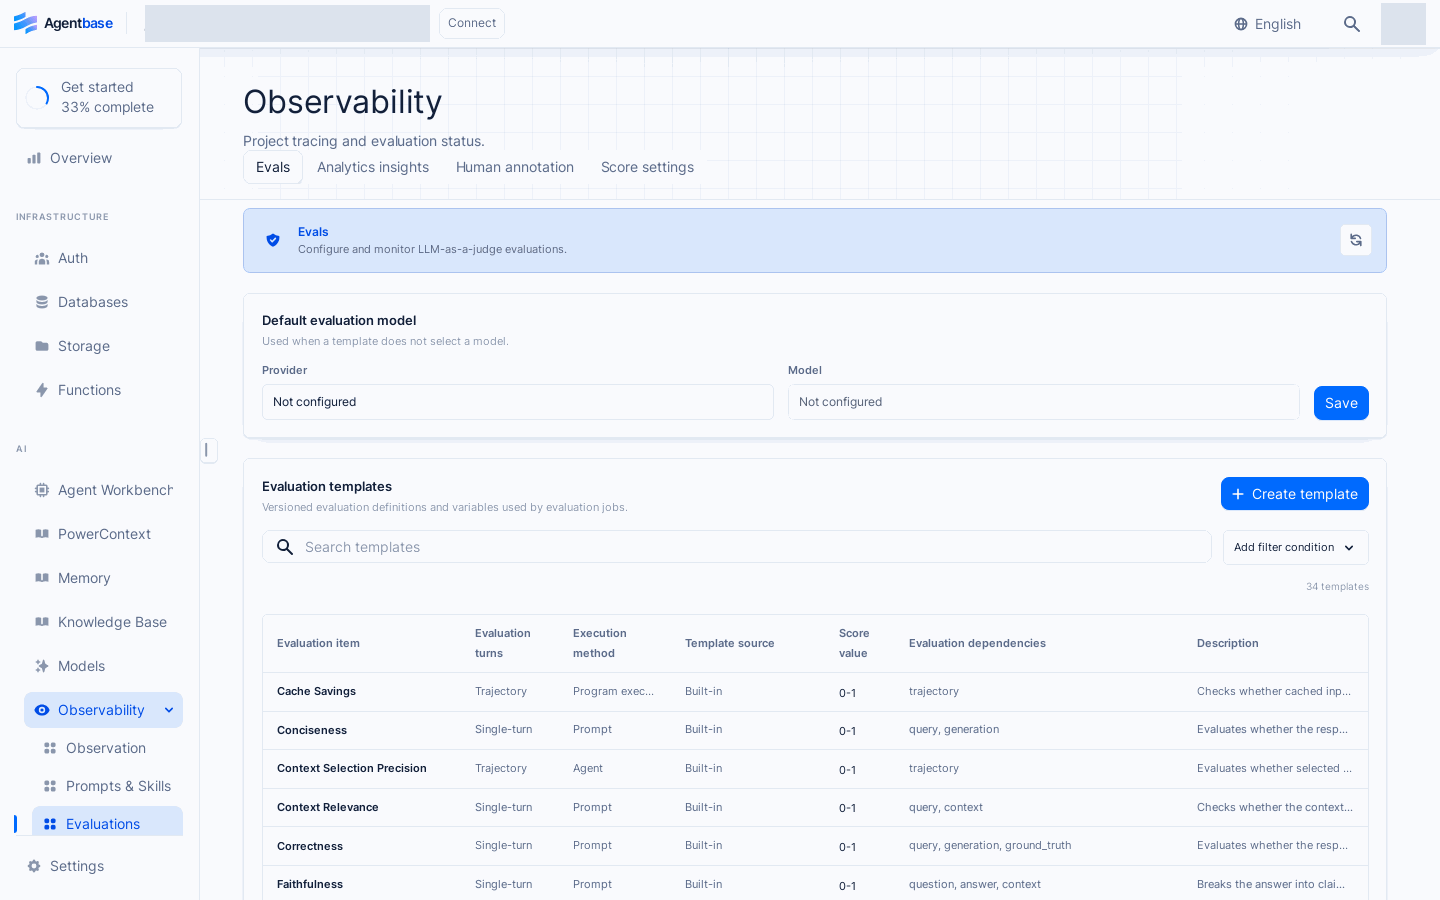
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
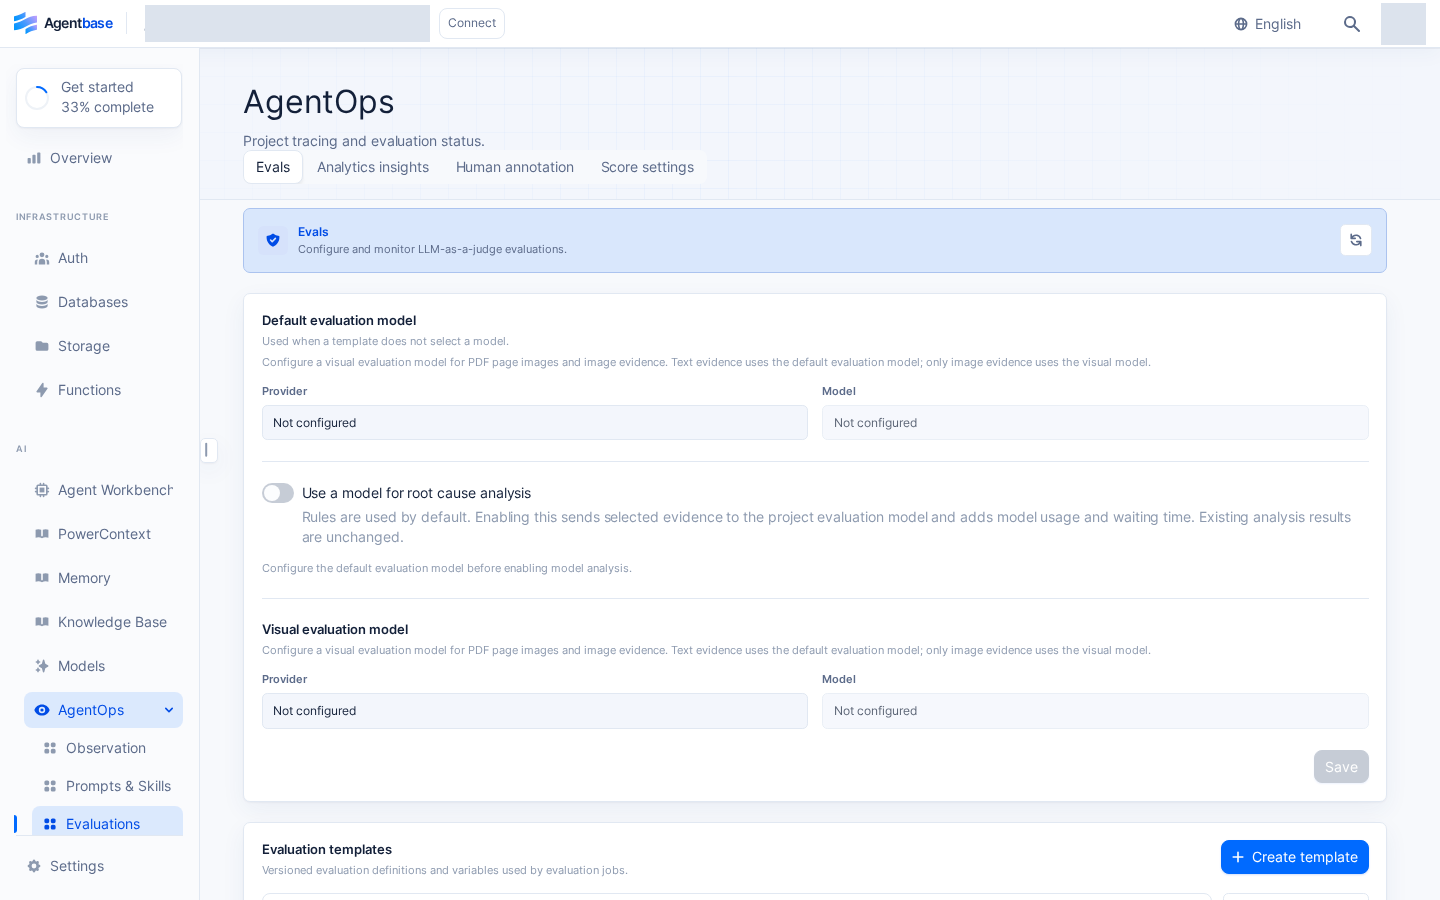
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
2. 管理评估技能(Evaluation Skills)与挂载只读 MCP 工具
当内置 Prompt 模板不足以表达复杂的企业专属评审规范(如多达数十页的金融客服合规手册或特定 SQL 审美规范)时,可创建项目级、版本化的 评估技能(Evaluation Skills):
在左侧导航栏打开 智能体运维 → 评估技能(Evaluation Skills)(路由:
/observability/evaluation-skills)。创建或导入评估技能包:
支持直接在表单中填写技能名称(
name)、描述(description)和 Markdown 正文创建;也支持上传
.zip、.tar.gz或.tgz压缩包(包根目录必须包含带name和descriptionfront matter 的SKILL.md,还可包含guides/rubric.md等任意相对路径参考文档;服务端安全检查严禁包含可执行脚本、符号链接或目录穿越)。
版本发布、冻结快照与 ZIP 导出:
草稿(
DRAFT)版本支持在线编辑、新建或删除包内文件;确认无误后发布为不可变版本(基于contentHash寻址);只有项目自定义且
executionMethod=agent的评估模板可以绑定 Evaluation Skill(每个模板最多绑定 8 个 不同 Skill 的已发布版本),并可同时挂载从 AI Gateway(prod-enterprise-ai-gateway)发现的只读 MCP 取证工具;严格隔离边界:Evaluation Skill 与智能体工作台中被测 Agent 使用的 Project Skill 完全隔离——它绝不进入被测 Agent 的工具列表,仅在评估任务最终 Judge 阶段向评审模型开放
skills_list与skill_view两个只读工具(单次读取 ≤256 KiB、累计 ≤512 KiB、工具循环最多 8 步),实际读取的文件路径与哈希会记录到 Score 元数据的evaluationSkillsprovenance 中;在版本详情页单击 下载.zip文件(
GET /v1/observability/evaluation-skills/:skillId/versions/:versionId/download),即可导出<Skill名称>-v<版本号>.zip完整归档包。
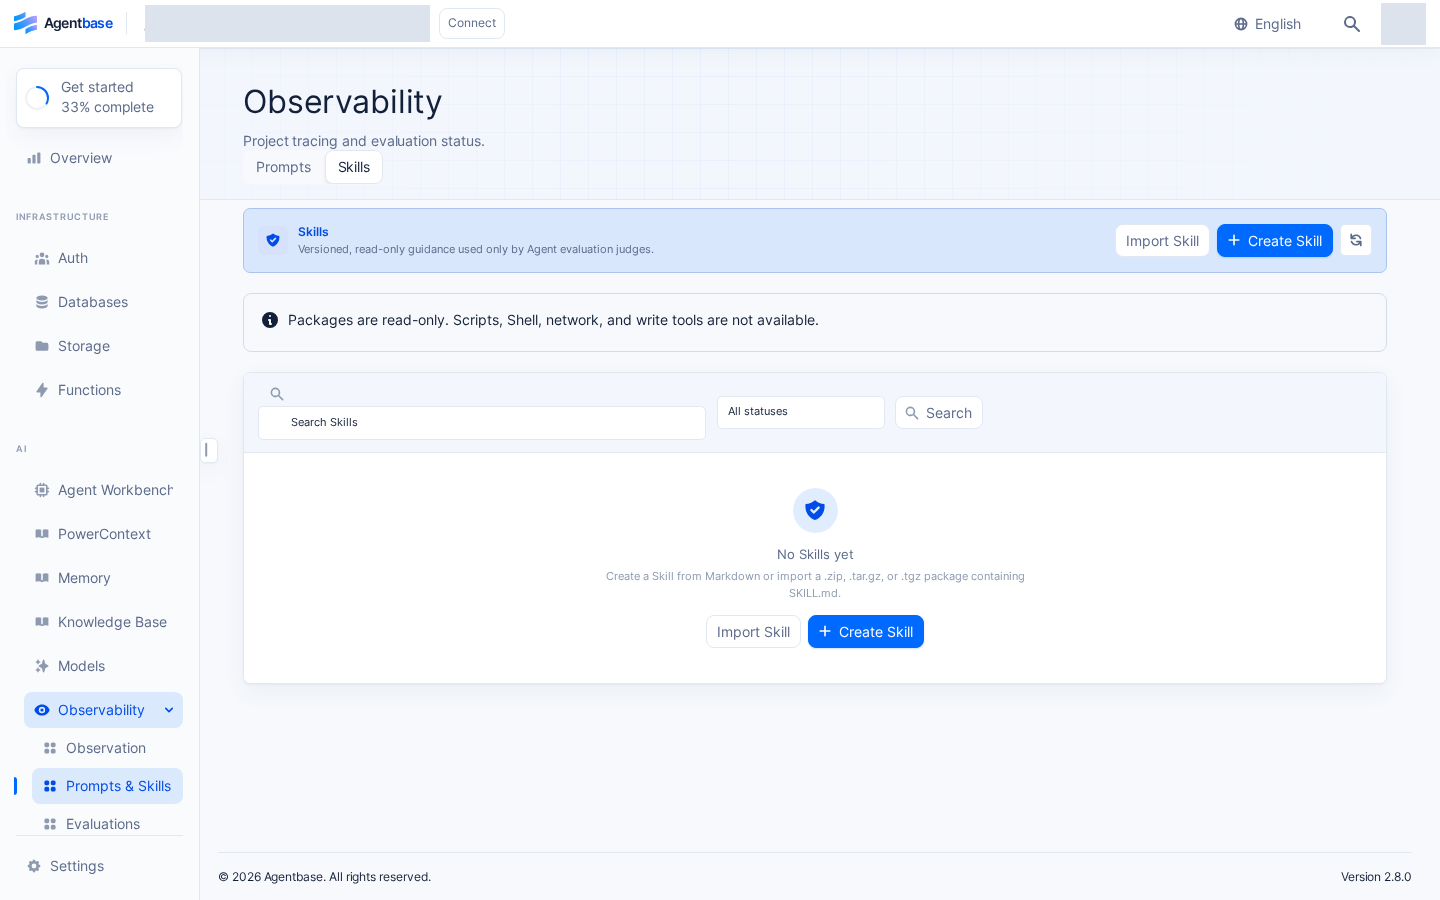
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
3. 创建知识库解析质量与知识索引质量评估任务(kb_enterprise_support)
针对标杆知识库 kb_enterprise_support(企业智能客服与技术支持知识库)(已摄取 4 篇核心技术文档并启用了 GraphRAG、RAPTOR 与 Wiki 10 个编译页面),可在同一向导中发起解析/分块评估与索引产物质量评估:
在 智能体运维 → 评估 页面单击 创建评估任务,在任务类型中选择 知识库解析评估。
选择目标知识库
kb_enterprise_support及当前生效版本。
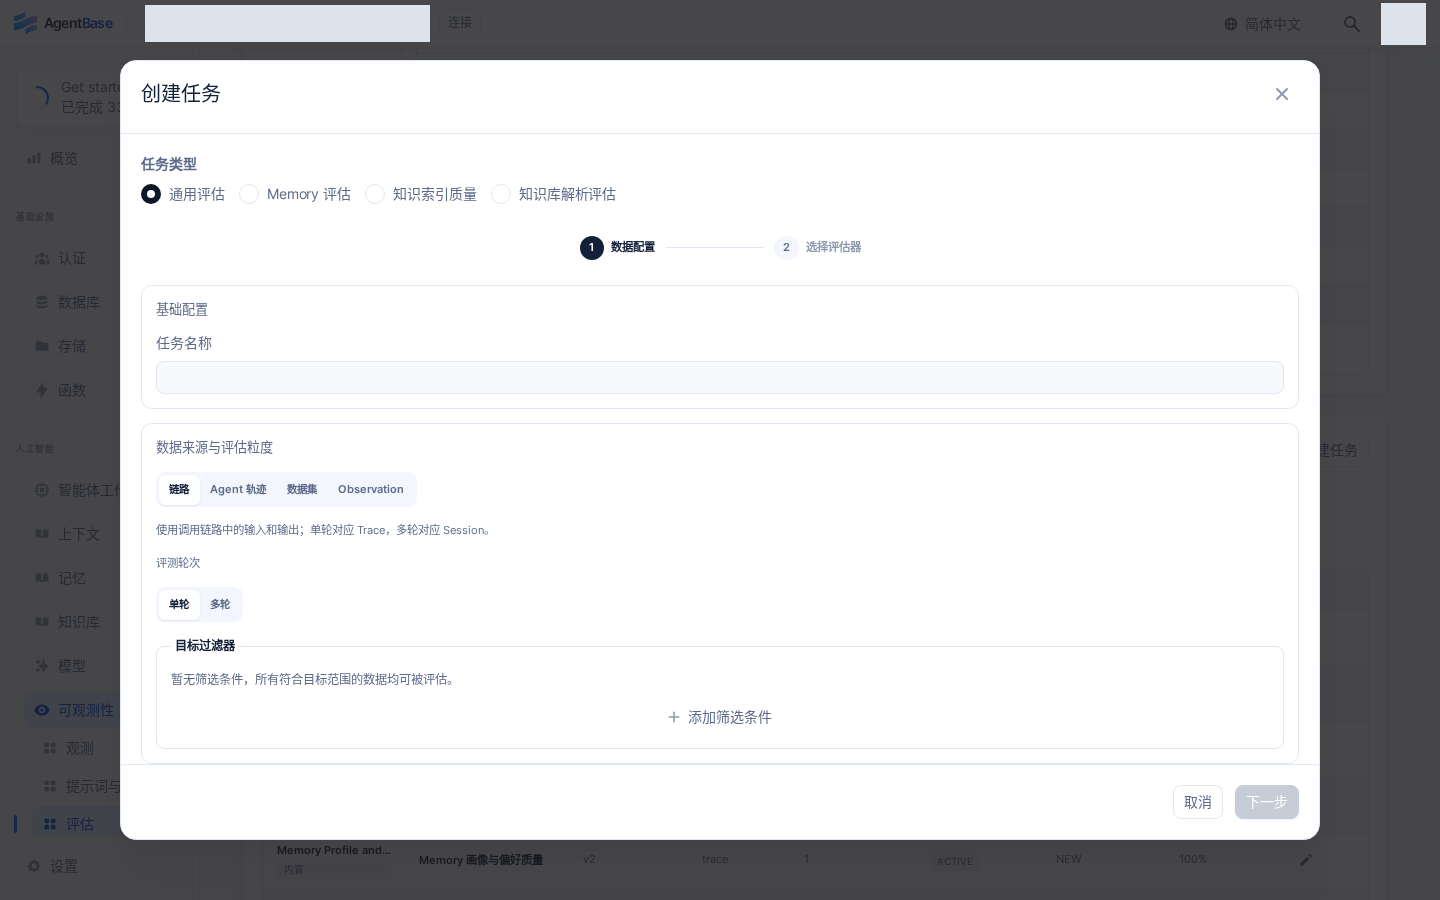
界面参考:沿用已登记的历史截图,演示数据与当前项目可能不同;本次未重新取图。
配置知识索引质量评估(
v2.10.0):在知识库版本下方,按需勾选已成功构建且未过期的索引能力:GraphRAG、RAPTOR、LLM Wiki(默认均不勾选);
分层抽样与规则全检机制:
每类索引能力默认开启抽样,默认抽样数量为
30条(可修改为任意正整数,或关闭抽样执行全量评估)。记录数按具体索引产物计算:GraphRAG 的实体、关系与社区报告,RAPTOR 的层级摘要节点,LLM Wiki 的页面;抽样按记录类型、树层级和文档/页面类型进行分层,并绑定冻结结果确定性选择(任务重试时复用完全相同的样本,不会随机漂移);
规则检查始终遍历该能力的全部记录(检查来源引用有效性、实体关系端点、子节点层级、Wiki 页面修订 hash 与
payload.modelCompletion是否存在截断),不受抽样数量限制;提交前系统自动调用
POST /v1/observability/evals/index-preview展示预计评估记录数;当单类超过 100 条 或三类合计超过 300 条 时,页面会显示费用与耗时增加提醒(不阻断提交)。
二次独立复核(Grounding Review)与待复核区隔离:
评估模型对每条有效索引记录的适用维度打分后,系统会使用同一评估模型再发起一次独立复核请求(
knowledge-index-review-grounding-v10),按冻结正文的零基非空行号逐行核查模型给出的满分或扣分是否被底层来源原文真实支持、重要陈述的前提条件/例外/版本号是否遗漏或变义;若原始记录存在规则错误(如生成截断、来源缺失、证据不自洽),直接隔离进入待复核区,不参与能力质量分聚合,也不生成误导性的配置建议;
若原始校验通过,系统正式发布
0~1能力级质量分(抽样模式标为“样本质量分”),并将二次复核的风险意见保存在modelReview中供下钻审阅。
# 示例:通过 REST API 预览并创建 kb_enterprise_support 的 GraphRAG、RAPTOR 与 Wiki 索引质量评估
export APPBASE_ENDPOINT="https://appbuild.oceanbase.com/v1"
export APPBASE_PROJECT_ID="enterprise-ai-hub-210"

# 1. 预览三类索引产物的可评估记录规模
curl -fsS -X POST "${APPBASE_ENDPOINT}/observability/evals/index-preview" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  --data '{
    "knowledgeBaseId": "kb_enterprise_support",
    "capabilities": {
      "graphrag": { "enabled": true, "sampleSize": 30 },
      "raptor": { "enabled": true, "sampleSize": 30 },
      "wiki": { "enabled": true, "sampleSize": 30 }
    }
  }' | jq .

# 2. 正式提交知识索引质量评估任务 (指定中文评分模板 zh-CN)
curl -fsS -X POST "${APPBASE_ENDPOINT}/observability/evals/index" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  --data '{
    "name": "kb_enterprise_support-v210-索引产物全面质量评估",
    "knowledgeBaseId": "kb_enterprise_support",
    "locale": "zh-CN",
    "capabilities": {
      "graphrag": { "enabled": true, "sampleSize": 30 },
      "raptor": { "enabled": true, "sampleSize": 30 },
      "wiki": { "enabled": true, "sampleSize": 30 }
    }
  }' | jq .
4. 评分根因分析(Root Cause Analysis / scoreAnalysis)与参数对照验证
当评估产生低分(关联 Trace 且归一化值 normalizedValue <= 0.5 的数值评分会自动触发;用户也可在评分详情或“分析洞察”列表中对任意关联 Trace 的数值评分手动点击 根因分析)时,系统异步生成结构化的 scoreAnalysis 诊断报告:
| 诊断层次与字段 | 运行机制与技术特性 | 输出内容与行动指导 |
|---|---|---|
分析模式 (analysisMode) | 自动识别 trace_only(外部上报或无配置快照)与 trace_plus_config(平台托管 Agent / RAG / Memory 且携带服务端签名配置快照)。 | 严格基于当次冻结证据,绝不拿当前可变配置伪造历史运行状态。 |
确定性规则诊断 (source=rules) | 默认零模型成本执行,核验执行状态、工具错误、检索空结果、上下文截断与理由一致性。 | 输出可核验的观测事实、根因分类及三级置信度(已确认 confirmed / 很可能 probable / 可能 possible)。 |
模型增强归因 (source=model) | 当项目开启 PUT /v1/observability/evals/root-cause-analysis-settings({"useModel": true})时启用,单次调用超时预算提升至 300 秒(24 KB 证据预算)。 | 对照问题、检索候选、模型回答、标准答案与解析/索引原文,输出待验证原因假设(最高置信度为 probable),如 query_drift、context_irrelevance、answer_ungrounded、threshold_filtering。 |
参数级修改建议 (parameterChange) | 遵循 schemaVersion=2 协议,仅引用当次已知历史值的白名单配置字段(如 RAG 的 limit、similarityThreshold、vectorWeight、rerank、allowDegraded,或 Memory 的 prompt.skillDistillationPrompt)。 | 给出 1 个主修改参数(primary)与最多 2 个依赖参数(dependencies),附带当前实际值、建议新值(百分之一网格精度)、支撑候选 ID 与原文短引文。 |
| 单变量对照试验验证 | 系统不会自动修改生产配置。针对 RAG 参数建议,开发者可在 Agent Runtime ReAct Run 请求中传入 knowledge_search_overrides 对同题、同标准答案执行隔离对照。 | 对比修改前后的四项 RAG 分数(查询质量、上下文相关性、忠实度、答案准确性)与 Token 消耗,确认真实改善后再合入正式配置。 |
用数据集评估 RAG 回答
需要比较检索配置或回答效果时,使用 Datasets → 目标数据集 → Runs → 创建运行。当前版本沿用该流程,不需要寻找额外的“评估 RAG”按钮。创建运行前确认具有数据集、运行与评估权限,项目中已有可用模型和配置了知识来源的 Agent。
准备与创建
在数据集 Items 中整理一组固定问题,每题填写参考答案(Expected output)。参考答案应独立核对,不能直接复制本次实际回答充当正确答案;CSV 导入步骤见数据集。
先确认知识库内容和索引可用,并用检索测试检查关键问题能够找到来源。
在 Runs 创建运行,填写名称与说明,选择 Agent 执行方式及已配置知识来源的项目 Agent 或 Gateway Agent。普通 Prompt 调用缺少可信检索证据时,不能生成这些专用 RAG 指标。运行参数只放业务配置,不填写密钥。
进入评估器选择步骤,按需选择下表中的平台内置模板,可在同次运行选多个模板。系统绑定本次运行的真实检索、问题和回答证据;答案准确性使用该样本的参考答案,无需手写证据路径。
确认执行目标、模型、模板和问题范围后提交,等待运行与评分分别完成,再进入详情逐题查看结果。
| 评估指标 | 回答的问题 | 需要检查的证据 |
|---|---|---|
| 查询质量 | 检索问题是否准确表达原问题 | 用户问题与实际检索查询 |
| 上下文相关性 | 用于回答的资料是否相关 | 本次运行的检索上下文 |
| 回答忠实性 | 回答是否受到资料支持 | 实际回答与检索上下文 |
| 答案准确性 | 回答是否与参考答案一致 | 实际回答与独立准备的参考答案 |
读取结果与继续改进
在 Runs 打开运行,逐项对照问题、参考答案、实际回答、各指标评分和错误;通过关联 Trace 检查检索与生成过程,并在可用的评分详情查看根因分析。缺少检索证据、证据身份无法验证或缺少参考答案属于评估错误,不是零分,也不表示通过。
先区分没有运行成功、没有检索到资料、答案未引用正确资料以及评分失败,再决定修改知识库、Agent 或评估配置。每次只调整一个待验证因素,用同一组问题与参考答案创建下一次运行;同时比较逐题结果、失败数量及延迟,而不只比较平均分。高分和模型给出的优化建议仍需人工核对关键事实。
提交回执丢失时
超时或强制刷新可能发生在服务已经接收请求之后。保留原标签页,先在运行列表确认是否已创建。 原标签页的页面会话仍保留时,刷新或在同一标签页返回创建流程,才可恢复待确认请求身份;同时保持项目、数据集、执行方式和语言一致,保留待确认名称并重新填写相同配置。
若提示上次结果尚未确认,不要改名或更改配置反复提交。新开标签页、关闭后重新打开、清除浏览器数据或换浏览器时,都不能保证待确认请求身份仍在;即使是同一浏览器,也不能承诺重新提交会去重。此时先核对已有运行及其状态,无法确认则联系管理员协助检查,不直接重提。
常见问题与排障
1. 创建知识库解析评估或索引质量评估时,为什么某些知识库或索引能力选项处于禁用状态?
原因分析:
知识库解析评估要求目标知识库已开启摄取追踪(
tracingEnabled: true)且平台开启了agentops.ingestionTracingEnabled,并在开启后完成过文档摄取;知识索引质量评估要求对应能力(GraphRAG / RAPTOR / LLM Wiki)在所选知识库版本下已成功完成构建、未过期且具有有效的
generation结果。若尚未构建或预览接口核验失败,复选框会自动禁用。
解决措施:前往 知识库管理 确认
kb_enterprise_support的追踪开关已开启,且 GraphRAG、RAPTOR 与 Wiki 索引状态均为ready后,重新打开创建评估任务弹窗。
2. 为什么知识索引质量评估的得分旁标记了“样本质量分”或“部分完成”,且部分记录进入了“待复核区”?
原因分析:
当开启抽样(如默认每类 30 条)时,聚合得分基于分层抽取的样本计算,因此明确标为 样本质量分;
当某条索引产物在构建时发生模型输出长度截断(
payload.modelCompletion非完整终态)、来源引用缺失,或原始评分维度不自洽时,系统不会将其记为 0 分拉低均值,也不会放行通过,而是将其隔离至 待复核区。
解决措施:在评分详情页点击下钻查看
quality-details?kind=index,切换到 待复核区 检查具体记录的规则警告或modelReview二次复核意见,针对性修复源文档或调整构建参数后重新构建。
3. 开启“使用模型进行根因分析(useModel: true)”后,历史已经生成的低分 Score 会自动重新调用模型分析吗?
原因分析:不会。为避免产生非预期的批量大模型调用费用,切换
useModel开关、更换默认评估模型或仅刷新评分列表页面,均不会自动重算历史已存在的分析制品。解决措施:若希望用最新开启的模型辅助能力重新诊断某条历史低分 Score,请进入该 Score 详情页(或在“分析洞察”列表中选中该条记录),手动单击 根因分析 并确认二次弹窗,系统会生成独立的
reanalysisId隔离执行并更新展示结果。