
统一 AI 网关(AI Gateway)
统一 AI 网关(AI Gateway) 是 Agentbase v2.10.0 面向企业多智能体、多模型与多工具生产环境打造的高级 AI 数据面治理中心。通过控制台左侧导航栏的 AI 网关(AI Gateway) 页面,架构师与运维团队可以按网关实例(如 prod-enterprise-ai-gateway)构建隔离的推理与工具入口,统一编排 逻辑模型(Logical Models)、主备故障转移(Fallback Deployments)、安全护栏(Guardrail Profiles)、语义缓存(Semantic Cache Policies)、MCP 工具审批与智能体代理、主体凭证与硬性预算(Principals & Budgets) 以及全维度流量质量观测。
功能概述
当企业 AI 应用从单点原型走向生产级规模化交付时,单纯的模型 API 转发已无法满足高可用、合规安全与成本精益化要求。统一 AI 网关通过以下五大功能页签提供全生命周期治理能力:
网关(Gateways):
创建与管理独立的网关实例(如
prod-enterprise-ai-gateway,实例 ID:gw_7194685489feb1e169548619)。查看网关专属数据面端点(
/ai-gateway/g/{gatewayId}/v1/...)、挂载的逻辑模型、安全护栏、语义缓存策略与不可变运行时快照(Runtime Snapshot)状态。
模型路由(Model Routing):
定义面向业务解耦的逻辑模型(Logical Model)(如
lm-enterprise-chat),底层挂载多个物理模型部署目标(Deployments,如主模型qwen-plus与备选模型qwen-turbo),支持按权重分流、按优先级自动容灾降级。支持从项目已注册的 Provider(如
dashscope-prod)一键发现并导入标准模型目录,配置模型费率卡(Rate Card)以核算精准调用成本。
工具与智能体(Tools & Agents):
集中注册 MCP(Model Context Protocol)Server、OpenAPI 工具、内联 API、Serverless Function 以及托管的 AppBase 标准模型与 AppBase RAG 连接模板。
内置严格的工具审批状态机(无需审批 / 按策略审批 / 始终审批),强制拦截未评审或高危工具直接以「无需审批」模式上线。
支持 A2A(Agent-to-Agent)与 HTTP Agent 统一接入与协议代理。
策略与凭证(Policies & Credentials):
管理安全护栏配置(如
gp-enterprise-safety)与语义缓存策略(如cp-semantic-cache)。提供策略版本差异对比(Diff)、策略决策解释与 OPA(Open Policy Agent)Dry-Run 预演。
管理访问主体(Principals)、签发绑定至当前网关实例的 API Key 凭证,并实施跨周期的硬性预算与配额控制(Budgets:QPS / 突发并发 / 请求次数 / Token 总额,支持分钟、小时、日、月周期)。
流量与质量(Traffic & Quality):
实时采集每一次经过网关的推理与工具调用轨迹,按 凭证 / 角色 / 逻辑模型 / 物理部署 / 工具 / 智能体 多维度聚合分析请求量、首包延迟(TTFT)、P95/P99 耗时、语义缓存命中率、护栏拦截率与 Token 成本。
历史错误状态示例:图中显示 503 / AI Gateway project schema is not available。请先检查项目网关配置和服务状态;该图用于识别异常页面。本次未重新取图。
核心概念与架构
统一 AI 网关请求处理与治理流水线
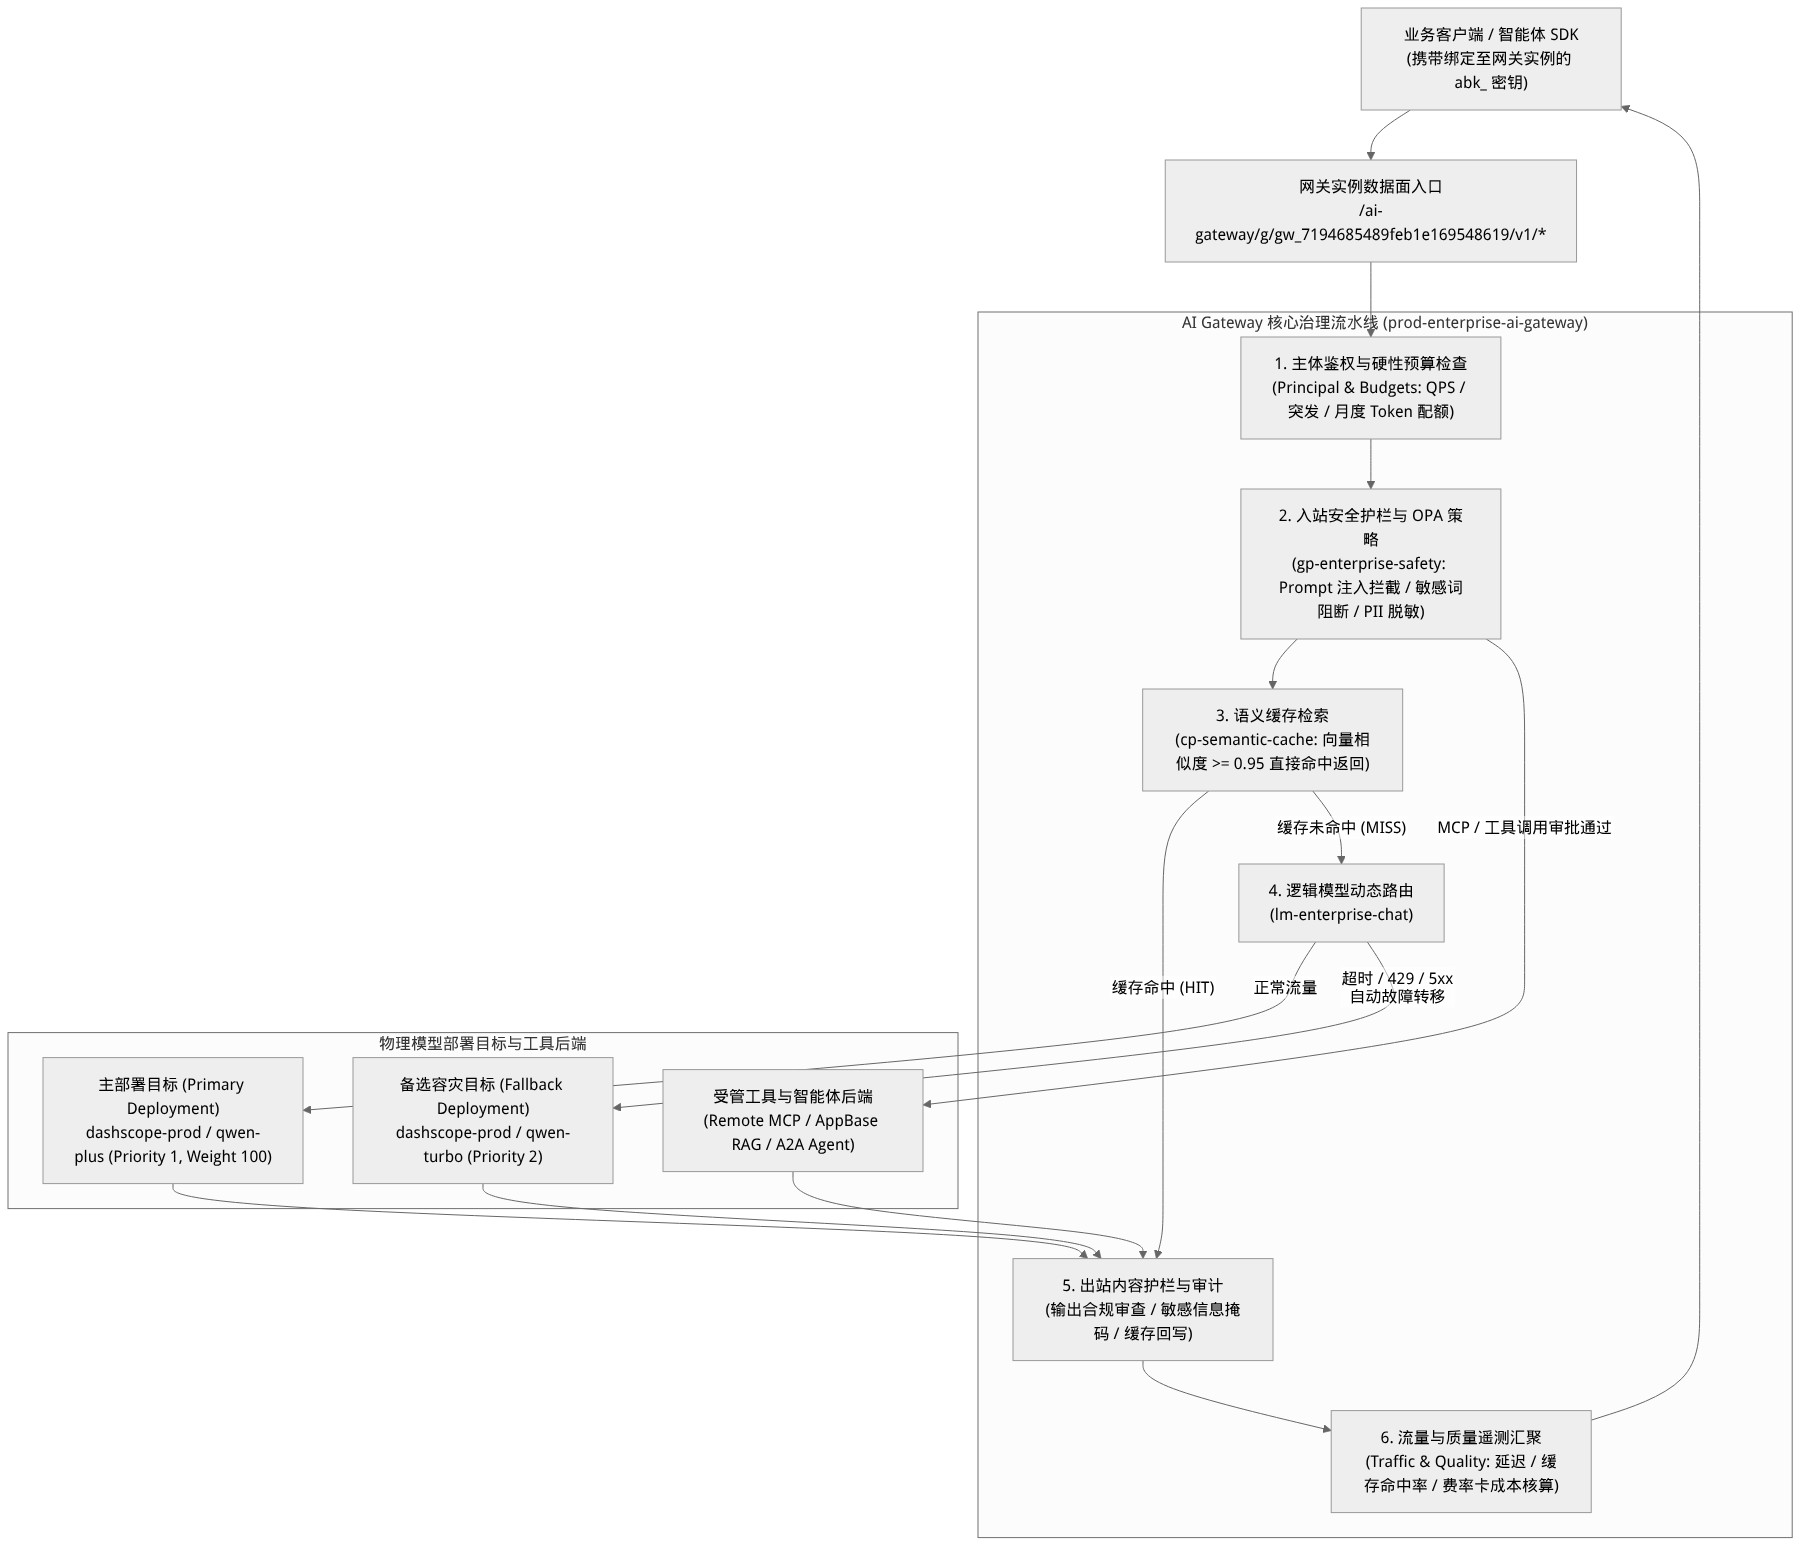
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
核心概念与配置实体表
| 实体名称 | 英文标识 | 标杆实例示例 | 核心职责说明 |
|---|---|---|---|
| 网关实例 | Gateway Instance | prod-enterprise-ai-gateway (gw_7194685489feb1e169548619) | 独立的数据面流量入口与策略挂载边界。每个实例拥有唯一的 gatewayId 与不可变运行时配置快照(Snapshot)。 |
| 逻辑模型 | Logical Model | lm-enterprise-chat | 面向业务暴露的虚拟模型名。业务代码固定请求 lm-enterprise-chat,无需感知底层物理模型的切换、升级或跨厂商容灾。 |
| 模型部署目标 | Model Deployment / Target | 主:qwen-plus备: qwen-turbo | 逻辑模型底层绑定的具体 Provider 模型及路由权重、优先级、并发上限与单目标超时参数。 |
| 安全护栏配置 | Guardrail Profile | gp-enterprise-safety | 定义入站(Input)与出站(Output)的内容安全检测规则,涵盖越狱/注入攻击阻断、PII(手机号/身份证/银行卡/密钥)自动掩码或拒绝、合规关键词过滤。 |
| 语义缓存策略 | Cache Policy | cp-semantic-cache | 基于 Embedding 向量相似度的智能缓存机制。当新请求的语义向量与历史缓存条目的余弦相似度达到阈值(如 0.95)时,直接返回缓存响应。 |
| 主体与凭证 | Principal & Credential | principal-support-agent | 调用网关的业务身份主体及其绑定的 abk_ 网关密钥、角色标签与允许访问的逻辑模型/工具范围。 |
| 硬性预算配额 | Budget | budget-monthly-support | 绑定在网关、主体或密钥维度的硬性限额,支持 QPS、突发请求数(Burst)、总请求数与总 Token 消耗的分钟/小时/日/月周期熔断。 |
角色、入口与关联关系
启用前提与权限矩阵
统一 AI 网关属于项目级高级治理服务,默认处于关闭状态。要访问左侧导航栏的 AI 网关(AI Gateway) 入口,需同时满足两个条件:
项目服务已启用:组织管理员或项目 Owner 已在 项目设置(Settings -> Services) 中开启 AI Gateway 服务。
成员具备对应 RBAC 权限:当前登录成员在组织/项目中具备 AI Gateway 读取或管理权限。
| 权限维度 | Owner / Admin | Developer | 安全/合规审计员 |
|---|---|---|---|
| 创建/修改网关实例与封存运行时快照 | 支持 | 不支持 | 只读查看快照历史 |
配置逻辑模型(lm-enterprise-chat)与主备部署路由 | 支持 | 支持 | 只读 |
编辑安全护栏(gp-enterprise-safety)、OPA 策略与执行 Dry-Run | 支持 | 支持 Dry-Run 调试 | 支持审批与审计查看 |
| 审批高危 MCP 工具发布与管理连接模板 | 支持 | 可提交工具注册申请 | 支持安全评审 |
| 签发网关专属凭证与调整硬性预算(Budgets) | 支持 | 仅限个人测试凭证 | 只读查看预算消耗 |
与其他模块的协同关系
与「模型(LLM Gateway)」的关系:AI 网关在配置逻辑模型的部署目标时,可直接从「模型」页已注册的
dashscope-prodProvider 中导入qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank等物理模型,实现底层连接凭据的安全复用;同时两套数据面入口完全独立。与「知识库(Knowledge Base)」的关系:在 工具与智能体 页签中,AI 网关内置了 AppBase RAG 托管连接模板,可将知识库
kb_enterprise_support直接封装为标准 MCP 工具挂载到网关实例上,供外部 Agent 统一调用。与「可观测(Observability)」的关系:网关层产生的追踪 Span、护栏命中事件、语义缓存命中指标与模型部署健康度会实时同步至可观测中心。
功能详解与操作指南
一、创建网关实例(prod-enterprise-ai-gateway)与快照治理
登录控制台,进入项目
企业智能客服与知识中台 (enterprise-ai-hub-210),点击左侧导航栏 AI 网关(AI Gateway)。在默认的 网关(Gateways) 页签中,点击 创建网关(Create gateway) 按钮,填写以下配置:
| 字段名称 | 参数标识 | 标杆配置值 | 说明 |
|---|---|---|---|
| 网关名称 | name | prod-enterprise-ai-gateway | 生产环境企业智能客服与知识中台统一网关 |
| 网关标识(ID) | gatewayId | gw_7194685489feb1e169548619 | 系统生成或自定义的唯一实例 ID,作为数据面 URL 路径的一部分 |
| 描述信息 | description | 承载客服对话主备路由、安全护栏与语义缓存的生产网关 | 说明网关的业务用途与归属团队 |
| 默认安全护栏 | defaultGuardrailProfile | gp-enterprise-safety | 实例级默认挂载的入站/出站安全护栏策略 |
| 默认缓存策略 | defaultCachePolicy | cp-semantic-cache | 实例级默认挂载的语义缓存策略 |
运行时快照封存(Runtime Snapshot):
当完成逻辑模型、护栏与权限策略配置后,点击网关详情页右上角的 封存运行时快照(Seal Runtime Snapshot)。
系统会生成一份带版本号与 SHA-256 摘要的不可变配置快照,便于线上变更审计与出现异常时一键回溯。
二、配置逻辑模型(lm-enterprise-chat)与主备容灾路由
切换到 模型路由(Model routing) 页签,点击 从 Provider 导入模型(Import from Provider),选择
dashscope-prod,将qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank导入网关标准模型目录,并配置对应的 Token 费率卡(Rate Card,用于自动计算每千 Token 成本)。点击 创建逻辑模型(Create logical model),配置
lm-enterprise-chat:
| 配置项 | 参数名 | 标杆配置值 | 路由行为说明 |
|---|---|---|---|
| 逻辑模型名称 | logicalModelName | lm-enterprise-chat | 客户端请求体中 model 字段填写的逻辑名称 |
| 能力类型 | capability | chat | 支持 OpenAI Chat Completions、Responses 与 Anthropic Messages 协议 |
| 路由策略 | routingStrategy | priority_failover(优先级主备容灾) | 优先路由至 Priority 1 部署目标;当主目标发生超时、429 限流或 5xx 错误时,零中断自动切换至 Priority 2 备选目标 |
| 主部署目标(Target 1) | deployments[0] | Provider: dashscope-prodModel: qwen-plusPriority: 1, Weight: 100Timeout: 60s | 承载正常生产流量的主力高推理能力模型 |
| 备选部署目标(Target 2) | deployments[1] | Provider: dashscope-prodModel: qwen-turboPriority: 2, Weight: 100Timeout: 30s | 当 qwen-plus 出现上游限流或高延迟时的自动降级兜底模型 |
三、配置安全护栏(gp-enterprise-safety)与语义缓存(cp-semantic-cache)
切换到 策略与凭证(Policies & Credentials) 页签,分别配置安全护栏、语义缓存与硬性预算:
1. 安全护栏配置(gp-enterprise-safety)
| 护栏规则项 | 作用方向 | 标杆配置值 | 触发动作 |
|---|---|---|---|
| Prompt 注入与越狱检测 | 入站(Inbound) | enabled = true(严格模式) | 阻断请求(BLOCK),返回标准合规提示与 400 GuardrailBlocked |
| PII 敏感隐私信息脱敏 | 入站 + 出站(Both) | 检测手机号、身份证号、银行卡号、API 密钥 | 自动掩码替换(REDACT,如 138****5678)后再发往模型或返回客户端 |
| 企业违禁词与竞品恶意引导过滤 | 入站 + 出站(Both) | 关联企业合规词表 | 阻断生成并记录安全审计事件 |
| OPA 策略预演(Dry-Run) | 策略发布前验证 | 输入测试 JSON 载荷 | 在不改变线上流量的前提下,预览策略允许/拒绝决策及规则命中明细 |
2. 语义缓存策略配置(cp-semantic-cache)
| 缓存参数项 | 参数名 | 标杆配置值 | 说明 |
|---|---|---|---|
| 策略名称 | name | cp-semantic-cache | 企业客服高频问答语义缓存策略 |
| 向量化模型 | embeddingModel | text-embedding-v3 (1024 维) | 用于计算用户提问语义向量的嵌入模型 |
| 相似度命中阈值 | similarityThreshold | 0.95 | 仅当余弦相似度 $\ge 0.95$ 时才判定为语义等价并命中缓存,兼顾准确率与召回率 |
| 缓存有效期(TTL) | ttlSeconds | 3600(1 小时) | 缓存条目的自动过期时间;知识库版本发布后支持一键清空关联缓存 |
| 排除条件 | bypassWhen | temperature > 0.7 或携带 X-AI-Gateway-No-Cache: true | 高随机性创作请求或显式要求实时计算的请求自动绕过缓存 |
3. 凭证签发与硬性预算(Budgets)
在 凭证与预算 区域,为客服业务主体创建专属 abk_ 网关密钥(强制绑定至 gw_7194685489feb1e169548619),并配置多维硬性配额:
QPS 限额:
20请求/秒,突发上限(Burst):40。日度请求数配额:
100,000次/天。月度 Token 硬性预算:
50,000,000Tokens/月(达到80%触发告警,达到100%立即硬性熔断阻断超支)。
四、配置工具与智能体(Tools & Agents)及审批流
切换到 工具与智能体(Tools & Agents) 页签。
点击 从连接模板创建(Create from template):
可选择托管模板 AppBase RAG,将其绑定至项目内的
kb_enterprise_support知识库;或选择 Remote MCP / OpenAPI / Function 接入外部工单查询工具。
设置工具审批模式(Approval Mode):
无需审批(None):仅允许已完成安全评审的低风险只读工具(如公开文档检索)使用;高危或未评审工具系统会强制禁止以「无需审批」模式发布。按策略审批(Policy-based):根据调用主体角色与参数范围动态决定是否需要人工或上游确认。始终审批(Always):涉及生产数据库写操作、工单状态变更或外部通知发送的工具必须经过显式审批。
五、验证多协议数据面调用与流量质量观测
使用绑定至 gw_7194685489feb1e169548619 的网关密钥,验证 OpenAI Chat Completions、Responses 与 Anthropic Messages 兼容接口:
# 1. 调用网关实例的 OpenAI Chat Completions 兼容入口
curl -X POST "https://appbuild.oceanbase.com/ai-gateway/g/gw_7194685489feb1e169548619/v1/chat/completions" \
  -H "Authorization: Bearer <APPBASE_AI_GATEWAY_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "lm-enterprise-chat",
    "messages": [
      {"role": "user", "content": "我的工单号是 TK-20261022-001,联系电话 13800138000,请帮我解释 OceanBase 向量索引排障步骤。"}
    ]
  }'

# 2. 调用网关实例的 Anthropic Messages 兼容入口
curl -X POST "https://appbuild.oceanbase.com/ai-gateway/g/gw_7194685489feb1e169548619/v1/messages" \
  -H "x-api-key: <APPBASE_AI_GATEWAY_KEY>" \
  -H "anthropic-version: 2023-06-01" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "lm-enterprise-chat",
    "max_tokens": 1024,
    "messages": [
      {"role": "user", "content": "请总结智能客服 SOP 标准作业手册中的工单升级时限要求。"}
    ]
}'验证结果:
在第一条请求中,
gp-enterprise-safety护栏自动将手机号13800138000脱敏为138****8000后再发往lm-enterprise-chat(底层由qwen-plus响应)。切换到 流量与质量(Traffic & Quality) 页签,可在 调用记录 与 多维用量表 中按凭证、逻辑模型
lm-enterprise-chat、物理部署qwen-plus查看本次调用的状态码、耗时、Token 数、费率卡折算成本及护栏/缓存命中标签。
常见问题与排障
Q1:可以不带 /ai-gateway/g/{gatewayId} 前缀,直接通过 /v1/ai/chat/completions 调用逻辑模型 lm-enterprise-chat 吗?
不可以。 统一 AI 网关的设计原则是「严格按网关实例隔离,不提供无 Gateway ID 的推理别名路由」。逻辑模型 lm-enterprise-chat、护栏 gp-enterprise-safety 与缓存 cp-semantic-cache 均挂载在具体网关实例 gw_7194685489feb1e169548619 下,因此必须通过 /ai-gateway/g/gw_7194685489feb1e169548619/v1/... 路径访问。
Q2:为什么注册了一个新的 MCP 工具后,无法将其审批模式设置为「无需审批(No Approval)」?
为了防范未授权工具调用导致的数据越权或生产事故,AI 网关内置了强制安全门禁:任何被标记为高风险等级(High Risk)或尚未通过安全评审(Unreviewed)的工具,系统在接口与控制台层面均严禁直接以「无需审批」模式发布。请先由项目管理员完成工具安全评审并将风险等级确认为低风险只读,或改用「按策略审批 / 始终审批」模式。
Q3:语义缓存(cp-semantic-cache)命中后返回了旧版本的知识回答,如何立即刷新?
当知识库(如 kb_enterprise_support)发布了新版本或业务规则发生重大变更时,您可以:
在单次调试请求头中携带
X-AI-Gateway-No-Cache: true强制穿透缓存并更新结果;前往 AI 网关 -> 策略与凭证 找到
cp-semantic-cache,点击 清空缓存条目(Purge Cache) 或调高相似度阈值、缩短 TTL。
Q4:主模型 qwen-plus 触发自动容灾切换到备选模型 qwen-turbo 时,客户端需要修改代码重试吗?
不需要。 故障转移在 AI 网关内部透明完成。客户端只需单次请求逻辑模型 lm-enterprise-chat,网关检测到主部署目标超时或返回 429/5xx 后,会在同一请求生命周期内自动切换至备选部署目标 qwen-turbo,并在响应元数据及 流量与质量 观测日志中标注实际执行的物理部署目标。