
链路追踪、观测节点、会话与人工标注
功能概述
链路追踪与人工标注(Traces, Observations, Sessions, Users, Scores & Annotation Queues)是 Agentbase 智能体运维(Observability / AgentOps)的日常排障与人工复核核心工作台。在智能体应用的研发与生产运维中,开发团队不仅需要查看单次请求的端到端执行瀑布图,还需要跨链路检索特定大模型调用(GENERATION)或工具执行(TOOL),按会话(Session)或用户(User)还原多轮对话上下文,并通过结构化评分(Scores)与多人协同标注队列(Annotation Queues)持续沉淀高质量评测标准。
在 Agentbase 企业智能中台(69c6d1aa00062e6bb60)的标杆项目 企业智能客服与知识中台(enterprise-ai-hub-210)中,运维团队通过本模块实现全方位追踪与质检:
实时追踪 VIP 架构师
user_zhangwei_001与工程师user_lina_002提交的工单处理链路(如TK-20261022-001),在同一详情页中自由切换ATIF-v1.8规范化智能体轨迹、层级观测树(Observation Tree) 与 时间轴瀑布图(Timeline);跨链路排查
qwen-plus、text-embedding-v3、qwen3.7-text-rerank及知识库kb_enterprise_support(含graphrag与wiki增强检索子节点)的耗时与 Token 消耗;通过 人工标注队列(Annotation Queues) 将疑难工单链路指派给领域专家,使用
5 分钟租约(Lease)机制完成NUMERIC、CATEGORICAL与BOOLEAN多维评分复核。
核心概念与架构
单次智能体执行在可观测引擎中被解构为“顶层 Trace 容器 + 树状 Observation 节点 + 规范化 ATIF 轨迹 + 多源 Score 评价”的四维关联结构。
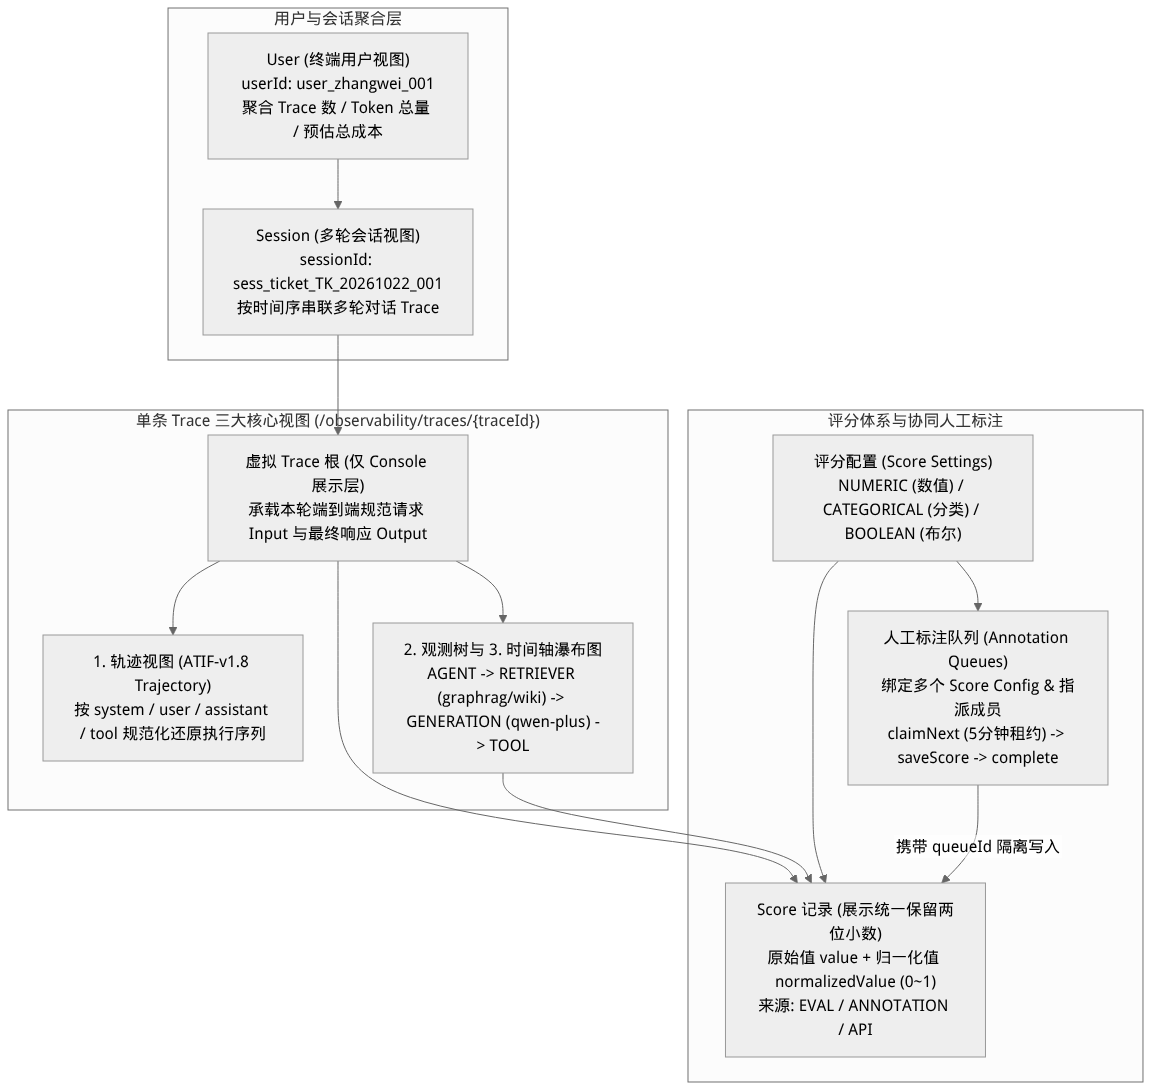
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
Observation 观测节点类型与技术语义表
观测类型 (type) | 典型产生组件 | 核心记录字段与排障用途 |
|---|---|---|
AGENT | 智能体工作台 (react.run / react.step) | 记录智能体编排循环、思考步骤与子任务分发,修正并保持 assistant / user / tool 消息角色层级。 |
GENERATION | LLM Gateway / Memory / Agent Runtime | 记录大模型推理调用(如 qwen-plus、qwen-vl-max),包含 model、modelParameters、input、output、精确 Token 用量(input / output / total 及互斥拆分的 cached / reasoning)与估算成本。 |
TOOL | Agent 工具执行 (tool.execute) | 记录 MCP 工具、数据库查询或自定义函数调用的入参、返回结果、执行状态与耗时。 |
RETRIEVER | 知识库 /search 与 Memory 检索 | 记录向量与混合检索过程。在知识库检索 Trace 中,实际尝试增强检索时还会生成 graphrag 与 wiki 子节点,记录 retrieval.status、retrieval.returned_count 与 stage.duration_ms。 |
EMBEDDING | 向量化阶段 (embed_query) | 记录调用 text-embedding-v3 生成查询或文档向量的耗时与 Token 消耗。 |
SPAN | 通用处理阶段 (context.prepare / HTTP / 队列) | 记录非模型类的内部阶段耗时(如上下文准备、未请求增强检索时的默认跳过阶段、HTTP 客户端调用与队列投递)。 |
EVENT | 瞬时关键事件 (memory.ingest.stage_failed) | 记录无持续时长的瞬时状态跳变或异常事件(如阶段错误码 errorCode、gatewayStatus)。 |
EVALUATOR / GUARDRAIL / CHAIN | 评估器与安全护栏 (gp-enterprise-safety) | 记录在线护栏拦截检查、评估器执行或复合调用链步骤。 |
角色、入口与关联关系
控制台入口与 REST API 映射
在项目 enterprise-ai-hub-210 的 智能体运维(Observability / AgentOps) 侧栏中,相关页面与底层 API 对应关系如下:
| 页面名称 | 控制台路径后缀 | 核心 REST API 端点 | 所需权限 Scope |
|---|---|---|---|
| 链路列表与详情(Traces) | /observability/traces · /traces/{traceId} | GET /v1/observability/traces、GET /v1/observability/traces/{traceId} | observability.traces.read |
| 调用观测列表(Observations) | /observability/observations | GET /v1/observability/observations | observability.traces.read |
| 会话视图(Sessions) | /observability/sessions · /sessions/{sessionId} | GET /v1/observability/sessions、GET /v1/observability/sessions/{sessionId} | observability.sessions.read |
| 用户视图(Users) | /observability/users · /users/{userId} | GET /v1/observability/users、GET /v1/observability/users/{userId} | observability.users.read |
| 评分与评分设置(Scores) | /observability/scores · /score-settings | GET/POST /v1/observability/scores、GET/POST /v1/observability/score-configs | observability.scores.read / write |
| 人工标注队列(Annotations) | /observability/annotations | /v1/observability/annotation-queues 及 /assignments、/items、/items/next、/scores、/complete | observability.annotations.read / write / submit |
作用域标签过滤(APPBASE_TRACE_TAGS)与跨系统跳转
为了帮助运维人员快速区分平台托管能力产生的 Trace 与外部业务上报的 Trace,Traces 列表顶部提供了基于权威遥测标签的作用域筛选器:
capability:agent(托管智能体链路):来自 Agent Runtime 工作台的链路;capability:rag(托管知识库链路):来自知识库kb_enterprise_support的文档摄取、GraphRAG/RAPTOR/Wiki 构建及混合检索链路;capability:memory(托管记忆链路):来自 Memory 服务的写入、检索、画像与蒸馏链路(在 Memory 页面点击 Trace 页签即自动携带?tag=capability%3Amemory跳转至此);agentbase-external(外部上报链路):业务应用通过 SDK 或 OTLP 自主上报的链路。
功能详解与操作指南
1. 查询链路(Traces)与剖析三大详情视图
进入项目
enterprise-ai-hub-210的 智能体运维 → 链路(Traces) 页面。支持按 作用域标签、用户 ID(
userId,如user_zhangwei_001)、链路名称(name)、起止时间 或在搜索框输入完整 Trace ID(在九州云图部署环境下,还支持直接输入SOFA-TraceId检索匹配的metadata.cloudAtlasTraceId)进行精确查找。单击任意一条 Trace 进入详情页,页面顶部提供 轨迹(Trajectory)、观测树(Observation Tree) 和 时间轴(Timeline) 三个视图切换按钮:
默认视图与智能回退规则:
当服务端已生成有效、非空的持久化
ATIF-v1.8轨迹且 URL 未指定特定observation参数时,页面默认打开“轨迹”视图,按system/user/assistant/tool规范化节点展示多模态内容(含文本、图片、音频结构化字段)与工具调用过程;当 URL 带有有效
?observation=<observationId>参数时,页面自动打开 观测树 并高亮选中该节点,方便团队成员通过复制 URL 分享精准定位;若当前 Trace 为纯检索链路或 ATIF 轨迹尚未生成/为空,页面安全回退至 观测树 并禁用轨迹按钮,绝不展示空白面板。
虚拟 Trace 根说明: 观测树与时间轴最外层显示一个虚拟 Trace 根节点,用于展示本轮端到端规范请求(Input)与最终回答(Output)。该虚拟根仅存在于前端展示层,不会重复计入 Observation 总数、Token 消耗或最慢节点统计。
2. 跨链路筛选调用观测(GET /v1/observability/observations)
当需要直接排查“过去 24 小时所有返回 ERROR 级别的 TOOL 调用”或“所有耗时最长的 qwen-plus GENERATION 节点”时,使用 观测(Observations) 列表页或调用 GET /v1/observability/observations:
| 查询参数 | 类型 | 必填 | 取值约束与分页契约 |
|---|---|---|---|
name | string | 否 | 观测节点名称精确匹配(如 "qwen-plus-diagnosis")。 |
type | string | 否 | 逗号分隔的一个或多个合法观测类型,如 "GENERATION,TOOL"(禁止包含空项或未知类型,否则返回 400)。 |
level | string | 否 | 日志级别过滤:DEFAULT、DEBUG、WARNING、ERROR。 |
traceId / environment | string | 否 | 按所属 traceId 或运行环境(如 "production")精确过滤。 |
from / to | string | 否 | ISO-8601 起止时间范围(若 from > to 返回 400)。 |
limit | integer | 否 | 单页条数,取值 1 ~ 100,默认 25。 |
offset | integer | 否 | 分页偏移量,必须是 limit 的整数倍(如 limit=25 时,offset 仅允许 0, 25, 50...,否则返回 400 general_argument_invalid)。 |
# 查询 enterprise-ai-hub-210 项目中所有 GENERATION 与 TOOL 类型的观测节点(第 1 页,每页 25 条)
curl -fsS --get "https://appbuild.oceanbase.com/v1/observability/observations" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  --data-urlencode "type=GENERATION,TOOL" \
  --data-urlencode "environment=production" \
  --data-urlencode "limit=25" \
  --data-urlencode "offset=0" | jq .
3. 追踪多轮会话(Sessions)与终端用户(Users)
会话视图(Sessions): 进入 智能体运维 → 会话(Sessions),按
sessionId(如sess_ticket_TK_20261022_001)查看同一客户在一次工单处理过程中的全部多轮问答 Trace,方便评估多轮意图跟随与上下文连贯性。用户视图(Users): 进入 智能体运维 → 用户(Users),查看按
userId(如user_zhangwei_001、user_lina_002)聚合的活跃时间窗口、累计 Trace 数量、Observation 数量、总 Token 消耗与预估总成本,单击用户名即可下钻查看该用户发起的所有历史 Trace。
4. 管理评分体系(Scores)与五档归一化分布
Agentbase 支持三种数据类型的评分配置(Score Settings):
评分数据类型 (dataType) | 取值与配置方式 | 归一化值 (normalizedValue) 计算规则与控制台展示 |
|---|---|---|
NUMERIC(数值型) | 定义最小值 minValue 与最大值 maxValue(如 0 ~ 1 或 1 ~ 5) | 系统严格依据该 Score 绑定的 configId(包含已归档配置)将原始分数线性归一化至 [0, 1] 区间,并划分为 五档质量分布(Excellent / Good / Average / Poor / Very Poor)。控制台所有数值评分统一保留 两位小数(如 0.92)。 |
CATEGORICAL(分类型) | 定义枚举类别集合(如 ["准确", "部分遗漏", "严重幻觉"]) | 记录命中的类别字符串 stringValue,支持在评分列表中按分面统计各分类占比。 |
BOOLEAN(布尔型) | 二值判断(true / false,对应数值 1 / 0) | 适合“是否遵循 SOP”、“是否触发安全红线”等二元合规检查。 |
查看与筛选评分:在 智能体运维 → 评分(Scores) 页,支持按时间、评估任务、五档质量档位、评估器、来源(
EVAL/ANNOTATION/API)和数据类型多选筛选;展开顶部 洞察区 可查看总数据量、归一化五档条数分布与时间趋势。直接人工评分与批量删除:已登录项目成员可在 Trace、Observation 或 Session 详情页直接添加、修改或删除
ANNOTATION人工评分;在评分列表页还支持勾选当前页最多 100 条ANNOTATION人工评分,经不可撤销确认后执行异步批量删除(EVAL与API产生的评分不可通过人工批量删除移除)。
5. 使用人工标注队列(Annotation Queues)协同复核
当需要组织多名领域专家对一批线上低分或疑难 Trace/Observation/Session 进行标准化盲评或复核时,使用 智能体运维 → 人工标注(Annotations):
创建标注队列并绑定配置与成员:
单击 创建标注队列(
POST /v1/observability/annotation-queues),填写队列名称(如"VIP工单回答质量专家复核队列"),绑定一个或多个评分配置(scoreConfigIds);通过成员分配设置(
PUT /v1/observability/annotation-queues/{queueId}/assignments)指派允许参与该队列标注的项目成员。
将待复核对象加入队列:
在 Trace 列表、Trace 详情或 Session 页面勾选目标项,单击 加入标注队列(
POST /v1/observability/annotation-queues/{queueId}/items),支持幂等入队并查看目标所属的全部队列及PENDING/COMPLETED状态。
5 分钟租约领取、打分与完成闭环:
仅被指派的项目成员可在队列详情页单击 开始标注 / 领取下一项(
POST .../items/next);系统为该成员签发 5 分钟独占租约(Lease),防止多人同时标注同一条记录产生冲突(若中途退出可调用
POST .../items/{itemId}/release释放租约);标注员对照左侧 Trace/Observation/Session 原文,按右侧绑定的所有评分配置逐项录入分数与评语(
POST .../items/{itemId}/scores,队列评分带有专属queueId隔离标记,不可通过普通直接评分接口篡改);完成全部必填评分项后,单击 完成本项(
POST .../items/{itemId}/complete),该队列项状态变为COMPLETED并自动推进队列完成进度。
# 示例:通过 REST API 创建人工标注队列并将一条疑难工单 Trace 加入队列
export APPBASE_ENDPOINT="https://appbuild.oceanbase.com/v1"
export APPBASE_PROJECT_ID="enterprise-ai-hub-210"

# 1. 创建人工标注队列 (绑定数值型与布尔型评分配置)
QUEUE_RESP="$(curl -fsS -X POST "${APPBASE_ENDPOINT}/observability/annotation-queues" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  --data '{
    "name": "企业客服SOP合规与技术准确性复核队列",
    "description": "针对 P0 工单链路进行人工专家复核",
    "scoreConfigIds": ["sc_sop_compliance_bool", "sc_tech_accuracy_num"]
  }')"

QUEUE_ID="$(echo "${QUEUE_RESP}" | jq -er '.id')"

# 2. 将工单 Trace 幂等加入该标注队列
curl -fsS -X POST "${APPBASE_ENDPOINT}/observability/annotation-queues/${QUEUE_ID}/items" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  --data '{
    "items": [
      {
        "objectId": "tr_support_ticket_20261022_001",
        "objectType": "TRACE"
      }
    ]
  }' | jq .
查找一条轨迹
选择时间范围、轨迹范围,并输入 Trace 名称或 ID;点击 Apply。范围选项包括 Agent、RAG、Memory、外部轨迹、Agent Runtime 和 Knowledge Base;PowerContext 仅在实例提供该能力时出现。
在结果中核对名称、时间、延迟、Observation 数量、Environment、User ID 和 Session ID。列表上方还显示结果总数,以及当前页的 P50/P95 延迟、平均 Observation 数和 Environment 数;翻页后当前页统计会随之变化。
点击列表中的轨迹,或在 Open trace 中输入当前项目的 Trace ID 直接打开详情。若打开的列表带有 Name 或 User 筛选标签,可点标签旁的 × 移除该条件后继续查看。
名称/ID 搜索、类别和时间范围会共同影响结果。没有找到记录时,先扩大时间范围、恢复轨迹范围并清除搜索条件;仍无结果时,再核对 Trace ID 是否属于当前项目,以及写入侧是否向该项目发送了 Trace。
分析轨迹详情
详情顶部显示轨迹状态、Error Observation 数、Session、总耗时、最慢 Observation 和 Token 用量。若部分生成记录缺少 Token 用量,页面会将汇总标为“已知用量”,不要把不完整统计理解为完整总量。有关联 Session ID 时,可从详情跳转到对应会话。
在轨迹工作区按数据情况查看 Observation 树、时间线或可展示的 Agent trajectory。选择某条 Observation 后,右侧详情可检查输入、输出、metadata 与关联评分;Observation 还可能包含用量和成本信息。时间线适合定位耗时较长或带 Error 级别的阶段,树视图则便于沿父子 Observation 检查调用结构。
详情状态是基于观测证据生成的信号:存在 ERROR 级别的 Observation 时显示 Error;没有此类 Observation、但存在 Observation 或延迟证据时显示 Success;缺少这些证据时显示 Unknown。该状态不代替应用自身的业务响应校验;Unknown 或空 Observation 也不能据此判定调用成功或失败。
Memory 页面中的 Traces 入口会打开轨迹列表并筛选 Memory 轨迹,可用于检查记忆链路。需要按时间段比较调用数量、延迟、Token 或评分时,继续查看指标分析;数据集运行记录见数据集。
轨迹标准化与上报验收
核心概念与数据关系
在接入外部智能体(Agent)或在控制台排查执行链路时,需要先区分以下四类核心概念及其数据边界:
链路(Trace):代表智能体或业务应用的一次端到端执行边界,用于承载本轮请求的规范输入(Input)、最终输出(Output)以及全局归属信息(如项目环境
environment、用户userId、版本release)。观测节点(Observation):Trace 内部的具体执行阶段。常见类型包括大模型调用(
GENERATION)、工具执行(TOOL)、智能体编排(AGENT)、向量与混合检索(RETRIEVER)、向量化(EMBEDDING)以及通用处理阶段(SPAN)。多个 Observation 通过父子引用构成层级调用树。会话(Session):通过共享的
sessionId将多次独立 Trace 按时间串联,用于还原同一用户在多轮对话或长工单处理中的完整交互脉络。规范化轨迹(ATIF v1.8):即智能体轨迹交换格式(Agent Trajectory Interchange Format v1.8),是平台基于已落库的 Trace 与 Observation 证据,在服务端自动提取、校验并持久化的标准多轮交互序列。
写入入口与平台派生边界:外部应用仅需通过公开的 Events 批量摄取(Events ingestion) 或 OTLP/HTTP Traces 接口上报 Trace 与 Observation 原始数据。ATIF v1.8 由平台在服务端异步派生并持久化。调用方使用公开摄取格式上报,平台没有在上述入口提供直接上传 ATIF 的契约。
观测树完整与对话轨迹完整的区别:层级观测树(Observation Tree)旨在还原端到端技术调用栈,而对话轨迹(Trajectory)专注于呈现 system、user、assistant 与 tool 之间的有效决策与交互步骤。普通的 HTTP 客户端请求、上下文准备(SPAN)、队列投递或纯检索(RETRIEVER)节点属于底层支撑阶段,它们按实际采集内容保留在观测树与时间轴中,不必生成对话轨迹步骤。
外部 Agent 接入流程与上报要求
外部 Agent 接入智能体运维并生成可展示、可评测的标准轨迹,建议遵循以下五步流程:
配置读写分离的项目凭据 所有调用均通过公开项目鉴权接口完成。生产上报组件仅需使用具备写入权限(
observability.ingest.write)的项目 API Key;上报后的自动化回读验收或数据查询应使用具备读取权限(observability.traces.read)的独立 Key,或直接在控制台查看。请保持写 Key 与验收读 Key 分离,无需为生产 exporter 授予额外读取权限。规划事件标识与父子层级 上报事件包含两类 ID:外层
event.id是事件幂等 ID,内层body.id是 Trace 或 Observation 的实体 ID。网络重试同一事件时必须复用原外层event.id;发送状态更新事件(如generation-update)时则使用新的外层event.id并保持body.id不变,切勿在每次重试时重新生成 ID。 推荐 Trace ID 使用非全零 32 位小写十六进制字符串、Observation ID 使用非全零 16 位小写十六进制字符串,以便使用 W3Ctraceparent透传关联。该格式是跨组件串联与关联执行日志(Trace Logs)的推荐实践,Events 摄取入口本身并不强制要求所有实体 ID 均为十六进制。层级关联上,所有 Observation 的body.traceId均指向根 Trace,子节点通过parentObservationId指向直接父节点。按规范上报模型消息与工具关联
角色与真实轮次:模型节点(
GENERATION)的input可使用带role与content的messages数组,必须完整保留system、user、assistant、tool角色与真实轮次;output仅记录本轮模型真实生成的assistant内容及工具调用请求(tool_calls),严禁将输入 Prompt 混入output当作模型输出。多轮上下文与重叠处理:单次执行发生多次模型调用时,每次
GENERATION应如实上报当时完整的输入上下文。平台会按前缀重叠规则自动识别新增轮次,调用方不得仅因文本内容相同而擅自删减真实对话轮次。工具调用三处 ID 一致:模型
output.tool_calls中的调用id、工具节点(TOOL)metadata.toolCallId以及后续模型input中tool角色消息的tool_call_id应保持一致。工具 Observation 提供可核对的调用 ID 和真实返回值;后续模型消息则保留当时实际消费的工具结果。父子 Observation 引用不能代替工具调用 ID。平台存在部分兼容回退,但新接入不应依赖工具名称猜测关联。独立记录用量(Usage):每次模型调用应在各自的
GENERATION节点独立记录usage,不要将父级AGENT节点的汇总用量与子级GENERATION重复累加;未知的 Token 用量与成本(Cost)应保持缺省(未知),不要填零伪造。通用接入与特殊路径边界:平台对 OpenCode 链路设有额外的唯一无环权威上下文(Context Snapshot)、身份核验与完整性否决约束;普通外部 Agent 应统一按通用 ChatML 消息格式接入,切勿通过伪造来源标签或内部签名尝试启用特殊解析路径。
控制批次规模并校验返回结果 Events 接口单批支持 1–100 条事件;全部成功返回 HTTP
200,部分失败返回207 Multi-Status,调用方必须逐项检查响应中的errors[]。OTLP 入口仅支持 HTTP JSON 或 protobuf(可选 gzip,不支持 gRPC),其 JSON 请求体使用标准resourceSpans → scopeSpans → spans结构(不包裹 Eventsbatch);当前版本 OTLP 接口返回平台事件转换结果,同样必须检查errors[],不能盲目按标准 OTLPpartialSuccess解析。完成控制台展示与评估验收 数据落库后,可结合可观测性总览、在线与数据集评估与数据集执行质量评测与基准对比。如需查阅完整的请求协议、字段说明与代码示例,请在文档站的 SDK 参考 或 API 参考 栏目中选择 可观测。
四层上报验收矩阵
上报接口返回 HTTP 200、链路列表中能搜到 Trace,或观测树中能看到节点,均不能单独证明轨迹标准化与评估已全部通过。请按以下四层矩阵逐级验收:
| 验收层级 | 验收目标 | 核对方式与判定标准 | 常见未通过原因 |
|---|---|---|---|
| 1. 请求被接收 | 确认摄取接口已合法受理全部事件 | 检查写入接口响应:Events 返回 HTTP 200,errors[] 为空,且 successes[] 覆盖本批所有事件 ID;207 按部分失败处理。OTLP 检查平台转换结果及 errors[]。响应缺字段、非 JSON 或有未确认事件时均不能判为全部受理。 | 鉴权 Header 缺失、单批事件数超限、字段类型不匹配,或忽略了 207 响应中的逐事件错误。 |
| 2. 实体已落库 | 确认异步 Worker 已完成 Trace 与 Observation 持久化 | 在控制台链路详情查看观测树与时间轴,或使用读 Key 调用 Trace 详情接口核对顶层 trace 与 observations 列表。 | 刚受理尚在异步队列中、重试时错误生成了新实体 ID,或 traceId / parentObservationId 关联错误。 |
| 3. ATIF 轨迹就绪 | 确认平台已派生有效、非空且 ready 的 ATIF v1.8 轨迹 | 打开控制台链路详情默认进入“轨迹”视图(按钮可点击且内容完整),也可回读详情,核对 trajectory.schema_version=ATIF-v1.8、非空 steps 及预期步骤。非空字段只是必要检查;页面可展示不证明所有评估器证据均充分。 | 纯检索/普通 HTTP 链路无模型交互、分批上报尚未完结、消息角色缺失,或工具调用 ID 无法关联。 |
| 4. 评估证据充足 | 确认特定评估器(Prompt / Agent / Program)所需证据齐备 | 在评估任务预览与执行结果中核对 Score 及状态,按所选模板检查执行状态、评分来源及证据说明;Exempt / Evidence limited 表示该指标证据不足,不能当作正常通过或低分。不要假定所有模板共享同一个状态字段。 | 重复或缺失的模型调用、Usage 无法归属到用户轮次、缺少缓存/命令执行证据,或轨迹超出读取预算。 |
轨迹标准化与上报排障 FAQ
1. 外部上报的 Trace 已经包含 GENERATION 节点,为什么仍未生成可用轨迹?
原因与排查:观测树只要有已落库的 Observation 即可展示,而“轨迹”视图要求服务端成功派生有效、非空且状态为
ready的持久化ATIF v1.8数据。当 Trace 已包含GENERATION节点但轨迹仍不可用时,请重点排查:分批上报是否尚未完结(必需的模型或工具证据未到齐)、GENERATION的input/output是否缺少有效的消息角色(system/user/assistant/tool),或 OpenCode 链路的最新权威上下文快照是否因不完整或身份校验失败而被整体否决。对于不含模型交互的纯检索或普通 HTTP 链路,不生成对话轨迹属于预期行为。
2. 为什么轨迹中工具节点缺失,或者出现工具调用关联冲突?
原因与排查:平台通过调用 ID 将模型发起的
tool_calls、工具节点(TOOL)执行结果以及后续回传的tool消息串联。请核对:模型output.tool_calls中的每个调用是否同时具备非空id与函数名;TOOL节点的metadata.toolCallId是否与该id完全一致;后续GENERATION输入中的tool消息是否携带相同的tool_call_id。工具 Observation 的调用 ID 应能对应已知模型工具调用;结果冲突或无法消歧时会阻断投影。仅有后续模型的工具消息,不能代替独立工具 Observation 的完整执行证据。
3. 模型消息角色错误、把 Prompt 当成 output 或删减了相同文本轮次会有什么后果?
原因与排查:若未按真实交互保留
system、user、assistant、tool角色,或将输入 Prompt 写入GENERATION的output,会导致轨迹步骤角色错乱、把系统指令误判为模型回答。此外,若在多次模型调用间人为删减了文本相同的历史轮次,会破坏平台的前缀重叠比对基准,导致多轮历史断裂或重复生成用户步骤。请始终如实上报每次调用的完整上下文与当次真实输出。
4. 为什么评估结果或详情页提示 Token 证据受限(Exempt / Evidence limited)或统计不可信?
原因与排查:平台按规范化的用户轮次(User Turn)归属每个规范
GENERATION的 Token 用量。若规范 Generation 缺失、重复或无法归属到用户轮次,或缺少所选指标需要的真实用量,相关 Token 规则可能返回证据受限。规范用量统计会排除父级 Agent 汇总和评估器自身用量;不要为了展示统计而把汇总值伪装成另一条模型调用。其他消费者自行汇总时也应避免父子重复求和。请确保仅在每次真实模型调用上独立记录已知用量。
5. 批量上报返回 HTTP 207 部分失败或遇到网络超时,应该如何重试?
原因与排查:收到
207 Multi-Status时,已进入successes[]的事件已被受理,只需针对errors[]中的失败项排查原因:若属于字段格式或权限类4xx错误,应修正数据格式而非盲目重发;若遇到网络超时、429限流或可恢复5xx错误,应采用有上限的指数退避策略重试,且重试时必须复用原事件的外层event.id,以确保服务端幂等去重。
常见问题与排障
1. 为什么打开某条 Trace 详情时,“轨迹(Trajectory)”按钮是置灰不可点击的,直接显示了“观测树”?
原因分析:
轨迹视图专用于展示由智能体运行时生成并完整持久化的ATIF-v1.8规范轨迹。如果该条 Trace 是一次单纯的知识库检索(/search)、单次 Memory 写入,或者智能体运行尚在分批上报过程中、必需的 Generation/Tool 证据未完结,服务端尚未生成ready状态的 ATIF 轨迹,前端会按安全回退规则自动展示 观测树 并禁用轨迹按钮。解决措施:对于仍在运行或刚结束的 Agent Run,等待数秒后刷新页面即可;对于非 Agent 编排类的普通检索或网关调用,直接在 观测树 与 时间轴 中查看各节点详情。
2. 调用 GET /v1/observability/observations 分页查询时,为什么返回 400 general_argument_invalid?
原因分析:Observations 列表接口采用严格的页对齐稳定分页契约:
limit必须在1 ~ 100之间,且offset必须是limit的整数倍(例如当limit=20时,offset传10会被拒绝);此外,若type参数中包含了末尾多余逗号(如"GENERATION,")或未知观测类型,或from时间晚于to时间,也会返回 400。解决措施:按页码
pageIndex(从 0 开始)计算offset = pageIndex * limit,并确保type参数仅包含合法的大写观测类型枚举。
3. 为什么项目管理员或普通成员在人工标注队列(Annotation Queues)里无法点击“领取下一项”或提交评分?
原因分析:人工标注队列遵循严格的指派成员检查:即使拥有项目的查看权限,如果当前登录用户未被显式添加到该队列的 指派成员列表(Assignments) 中,服务端也会拒绝其领取租约(
claimNext)或提交队列评分。此外,若某一条目正被另一位被指派成员持有且 5 分钟租约尚未到期,其他成员也无法重复领取该条。解决措施:由队列管理员在队列设置中将目标成员加入指派列表;若前序标注员临时离开,可点击释放租约或等待 5 分钟租约自动过期后重新领取。