
GraphRAG、RAPTOR 与高级知识索引构建治理
本手册对应 Agentbase v2.10.0(控制台同版本)。
知识索引(Index Capabilities) 是 Agentbase v2.10.0 知识库突破传统平面分块检索(Flat Chunk RAG)局限、面向复杂多跳推理与跨文档宏观归纳打造的高级派生索引治理中心。通过知识库详情页的 知识索引(Indexes) 页签,企业可以在基础向量与全文索引之上,按需开启并精细化编排 GraphRAG(实体关系知识图谱与 Leiden 社区报告)、RAPTOR(基于 GMM+BIC 的递归抽象聚类摘要树) 以及 LLM Wiki(结构化知识百科编译) 三大高阶索引能力,配合版本代际号(currentGeneration)、陈旧化原因追踪(staleReason)以及进程级双信号量模型容量保护(ModelCapacity),确保后台大规模索引构建永不抢占线上实时检索(/search)的推理与向量化配额。
功能概述与核心场景
在企业级知识中台(如项目 企业智能客服与知识中台,ID:enterprise-ai-hub-210)服务一线与二线工程师时,传统「定长切块 + Top-K 向量召回」在两类典型高难度查询上往往捉襟见肘:
痛点一:多跳关联与根因链条断裂(Multi-hop Relational Queries) 例如用户提问:
“当 AI 网关触发上游限流降级时,如果底层 OceanBase 同时报 -4013 错误,按照客服 SOP 应该升级给哪个专家角色并调整什么内核参数?”该问题的答案分散在《AI网关模型路由与限流计费规范.md》、《OceanBase分布式事务与向量索引排障指南.md》与《智能客服SOP标准作业手册.md》三份不同文档的多个分块中,单次余弦相似度检索极易漏掉中间桥接分块。痛点二:跨文档全局总结与宏观脉络缺失(Global Summarization Queries) 例如技术总监提问:
“请全面总结整个知识库在系统高可用容灾、限流降级与故障应急演练方面的核心架构设计。”传统 Top-5 局部切片只见树木不见森林,无法提供跨越全库的宏观抽象结论。
Agentbase 高级知识索引构建治理 通过三大派生索引与严谨的作业调度机制彻底解决上述痛点:
GraphRAG(知识图谱索引)与词库增强消歧:
自动从
ready分块中利用qwen-plus抽取领域实体与有向语义关系,结合项目级词库(lexiconEnabled: true)将同义词实体(如OB、OceanBase 4.3)归一合并为标准主实体OceanBase并过滤停用词噪声,再经 Leiden 层次化社区发现算法生成多层级社区摘要报告并由text-embedding-v3向量化入库。
RAPTOR(递归抽象处理与树状检索):
将底层分块向量(Level 0)通过 高斯混合模型(GMM)软聚类 + 贝叶斯信息准则(BIC) 自动判定最优簇数量,调用
qwen-plus对每个语义簇生成抽象摘要并再次向量化,递归向上构建多层级语义摘要树(支持knowledgeBase跨文档全局树与document单文档层次树),让检索同时具备局部细节精度与全局主题视野。
LLM Wiki(知识百科编译)与
await_graphrag依赖栅栏:综合消费底层文档分块与 GraphRAG 抽取的实体/社区结构,自动编译生成以
kb-index为根入口的结构化百科章节树(如标杆库自动编译的 10 篇百科页面),并通过await_graphrag栅栏机制确保在联合构建时先完成图谱抽取再启动 Wiki 编译。
双轴状态机、陈旧感知与
ModelCapacity流量隔离:独立维护每项能力的配置状态(
disabled/configured/enabled)与运行状态(building/ready/stale/failed/cancelled),精准记录 6 类陈旧原因(staleReason),并通过进程级ModelCapacity双信号量机制严格限制后台索引构建的并发度,优先保障线上/search零延迟抖动。
核心概念与架构
三大高级派生索引构建流水线与 ModelCapacity 并发治理架构图
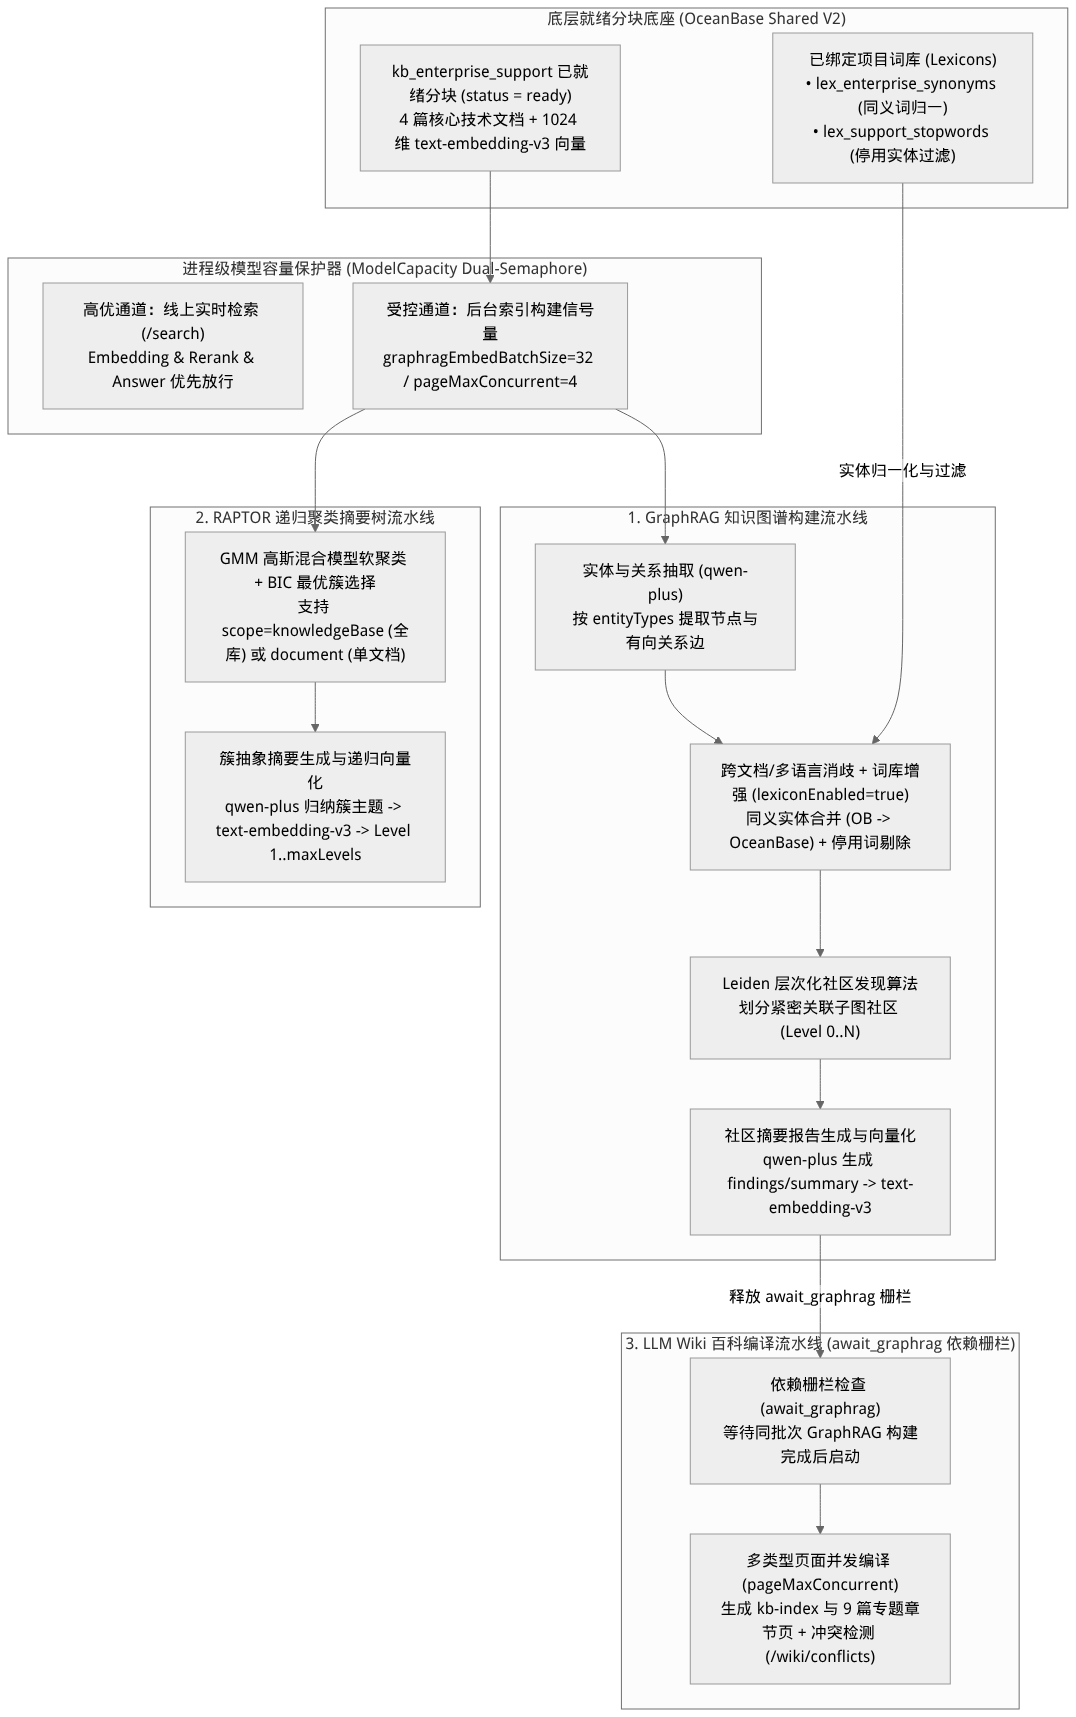
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
一、GraphRAG(知识图谱索引)深度原理与配置参数
GraphRAG 将非结构化文本转化为结构化的「实体(Entity)— 关系(Relation)— 社区报告(Community Report)」三层拓扑网络:
五步构建流水线:
Step 1(实体与关系抽取):遍历知识库中状态为
ready的分块,调用 Chat 模型(dashscope-prod下的qwen-plus)按预定义或自定义的entityTypes抽取实体名称、类型、上下文描述以及实体间的有向语义关系与关系强度权重(Weight)。Step 2(图谱词库增强与跨文档消歧):当开启
lexiconEnabled: true时,抽取器在落库前自动加载知识库绑定的项目词库(如lex_enterprise_synonyms与lex_support_stopwords):若抽取出的实体命中synonym变体词(如OB、OceanBase数据库),自动将其归并至规范主词OceanBase;若命中stop停用词,则直接丢弃该噪声实体。随后执行跨文档、跨语言同名异义消歧与描述融合。Step 3(Leiden 层次化社区检测):基于实体关系图的边权重运行 Leiden 图聚类算法,将高内聚的实体节点划分为不同层级(Level 0 细粒度子社区至高层全局社区)的拓扑社区。
Step 4(社区摘要报告生成):调用
qwen-plus为每个 Leiden 社区生成包含标题(title)、核心摘要(summary)、关键发现列表(findings)与重要性评分(rating)的结构化报告。Step 5(图谱向量化落库):以
graphragEmbedBatchSize(默认32)为批次大小,调用text-embedding-v3(1024维)对所有实体描述与社区摘要报告生成语义向量并持久化至 OceanBase 向量表中。
GraphRAG 核心配置参数表:
| 参数字段 | 类型 | 默认值 / 标杆值 | 详细说明与调优建议 |
|---|---|---|---|
enabled | boolean | true | 是否为当前知识库启用 GraphRAG 知识图谱能力。 |
entityTypes | string[] | ["产品模块", "故障码", "API接口", "配置参数", "SOP步骤", "专家角色"] | 限定大模型重点识别的领域实体类别;聚焦的实体类别能显著降低无意义通用名词抽取出图率。 |
lexiconEnabled | boolean | true | 图谱词库增强开关:开启后在实体抽取阶段实时应用已绑定词库的 synonym 归一规则与 stop 过滤规则。 |
language / outputLanguage | string | "zh-CN" | 可选 "zh-CN"、"en-US"、"auto"。控制实体综合描述与 Leiden 社区报告的生成语言。 |
graphragEmbedBatchSize | integer | 32(范围 1~128) | 实体与社区摘要向量化时的单批 Embedding 分块数,配合 ModelCapacity 控制并发吞吐。 |
extractionPrompt | string | 平台内置模板 | 可选自定义实体关系抽取提示词,支持针对数据库排障或金融合规领域定制抽取粒度。 |
二、RAPTOR(递归抽象处理与树状聚类索引)深度原理与配置参数
RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval)通过自底向上构建多层级语义摘要树,弥补平面分块缺乏跨段落宏观上下文的短板:
四步递归聚类流水线:
Level 0(叶节点层):直接以知识库已就绪的原始文档分块(Leaf Chunks)及其
1024维text-embedding-v3向量作为树的叶节点。GMM 软聚类 + BIC 准则:对当前层节点向量执行降维与 高斯混合模型(Gaussian Mixture Model, GMM)软聚类(允许单个跨主题分块同时归属多个相关语义簇),并使用 贝叶斯信息准则(Bayesian Information Criterion, BIC) 自动计算最优聚类簇数,避免人工硬编码簇个数导致欠聚类或过聚类。
簇抽象摘要与再向量化:针对每个聚类簇内的节点文本,调用
qwen-plus提炼生成更高一层的抽象总结节点(Summary Node),并调用text-embedding-v3计算该摘要节点的向量。递归收敛(Level 1..
maxLevels):对新生成的摘要节点重复执行「GMM+BIC 聚类 -> LLM 抽象总结 -> 向量化」,直至达到设定的最大树高maxLevels或剩余节点数无法继续聚类,形成完整的层次化语义树。
RAPTOR 核心配置参数表:
| 参数字段 | 类型 | 默认值 / 标杆值 | 详细说明与选型建议 |
|---|---|---|---|
enabled | boolean | true | 是否为当前知识库启用 RAPTOR 递归聚类摘要树能力。 |
scope | string | "knowledgeBase" | 聚类作用域: • "knowledgeBase":跨文档全局树,将全库所有文档的分块放在同一向量空间聚类,适合跨手册综合问答;• "document":单文档独立树,在每篇文档内部构建专属章节摘要树,适合超长白皮书或百页合同内部汇总。 |
maxLevels | integer | 3(范围 1~5) | 递归聚类树的最大层高(不含 Level 0 叶节点)。企业中型知识库推荐设为 3。 |
clusterSize | integer | 10(范围 3~50) | 单个语义簇容纳的目标子节点上限,影响每层 LLM 摘要的上下文聚合宽度。 |
summarizationPrompt | string | 平台内置模板 | 可选自定义簇摘要生成提示词,指导大模型保留关键参数、阈值与因果结论。 |
三、LLM Wiki 编译与 await_graphrag 依赖栅栏机制
当用户在 Indexes 页签同时启用 GraphRAG 与 LLM Wiki 并批量触发构建时,Agentbase 内置了 await_graphrag 依赖栅栏(Dependency Barrier):
为什么需要
await_graphrag:LLM Wiki 在规划全局百科目录(kb-index)和编写跨文档专题页面时,不仅读取原始文档分块,还会消费GraphRAG抽取出的高中心度核心实体与 Leiden 社区报告,以确保编译出的百科章节结构与全库知识图谱拓扑完全对齐。栅栏调度行为:当存在正在运行或同批次排队的
GraphRAG构建任务时,Wiki 构建作业会自动进入受控等待状态(记录栅栏状态await_graphrag),待GraphRAG成功落库(status = ready)后立即无缝唤醒 Wiki 编译器,按pageMaxConcurrent(默认4)并发生成 10 篇结构化百科页面。
四、双轴状态机、陈旧原因(staleReason)与 ModelCapacity 容量治理
1. 索引能力双轴状态机与 currentGeneration
每项高级索引能力(graphrag / raptor / wiki)均由两个正交状态维度及单调递增的代际号 currentGeneration 描述:
管理态(Lifecycle State):
disabled:未启用;configured:已保存参数但当前处于关闭状态;enabled:已启用,允许触发构建并在ready时参与线上混合检索。
数据就绪态(Data Readiness State):
building:后台 Worker 正在执行抽取、聚类或编译作业;ready:当前代际(currentGeneration)的派生索引已完整构建且与最新文档完全同步;stale:底层文档、分块、数据源或索引配置已发生变更,现有旧代际索引仍可继续服务线上查询(平滑保底),但需要触发incremental或rebuild作业升级至最新代际;failed:最近一次构建作业因上游模型不可用或配额耗尽而失败;cancelled:构建作业被管理员主动取消。
2. 六类标准陈旧原因(staleReason)字典
陈旧原因枚举值 (staleReason) | 触发场景说明 | 推荐修复动作 (operation + executionMode) |
|---|---|---|
document_ingested | 知识库新增上传了文档或对存量文档执行了重新摄取(Re-ingest) | operation: "build", executionMode: "incremental" |
document_deleted | 从知识库中删除了某篇已参与构建的文档 | operation: "repair" 或 executionMode: "rebuild" |
chunk_updated | 在文档详情页手工修改了某个分块(Chunk)的正文内容或删除了分块 | operation: "build", executionMode: "incremental" |
data_source_sync | 语雀等外部数据源执行增量同步(/datasources/{id}/sync)产生了新增或变更文档 | operation: "build", executionMode: "incremental" |
config_changed | 通过 PATCH /index-capabilities/{capability} 修改了 entityTypes、lexiconEnabled、scope 或提示词 | operation: "build", executionMode: "rebuild" |
manual_rebuild | 管理员显式请求强制全量重建 | operation: "build", executionMode: "rebuild" |
3. 进程级 ModelCapacity 双信号量并发保护
在生产环境中,GraphRAG 的实体抽取与 RAPTOR 的多层摘要会产生密集的 LLM(qwen-plus)与 Embedding(text-embedding-v3)调用。为防止后台构建任务打满上游模型 TPM/RPM 配额而导致前台客服问答(/search)超时,Agentbase 在 Worker 与 API 进程层实现了 ModelCapacity 双信号量隔离机制:
高优在线检索通道(Online Search Semaphore):为实时
/search请求预留保底并发配额,任何时刻优先获取模型调用令牌;后台索引构建通道(Background Indexing Semaphore):后台
graphrag、raptor、wiki作业通过独立受限信号量加上自适应退避(Adaptive Backoff)申领并发槽位,实现「前台零感知、后台稳吞吐」。
功能入口与权限矩阵
| 控制台入口 / 功能模块 | 前端路由路径 | 对应 REST API 端点 | Server SDK 方法(Node.js / Python) | 所需 RBAC 角色 / API Key Scope | 跨模块依赖关系 |
|---|---|---|---|---|---|
| 知识库 → 知识索引总览页 | /console/project-default-enterprise-ai-hub-210/knowledge-base/kb-kb_enterprise_support/indexes | GET /v1/knowledgebases/{kbId}/index-capabilities | knowledgeBase.listIndexCapabilities() / list_index_capabilities() | 角色:owner、admin、developer、member(只读)Scope: knowledgebases.read | 依赖知识库内至少存在 1 篇 status=ready 的文档 |
| 配置 GraphRAG / RAPTOR / Wiki 能力参数 | /console/.../kb-kb_enterprise_support/indexes(点击对应卡片「配置 Configure」) | PATCH /v1/knowledgebases/{kbId}/index-capabilities/{capability} | knowledgeBase.updateIndexCapability() | 角色:owner、admin、developerScope: knowledgebases.write | 依赖 dashscope-prod 中已配置 qwen-plus 与 text-embedding-v3;开启 lexiconEnabled 依赖已绑定词库 |
| 派发增量构建、修复或全量重建作业 | /console/.../kb-kb_enterprise_support/indexes(点击「构建 Build」或「重建 Rebuild」) | POST /v1/knowledgebases/{kbId}/index-operationsGET /v1/knowledgebases/{kbId}/index-operations | knowledgeBase.createIndexOperation()knowledgeBase.listIndexOperations() | 角色:owner、admin、developerScope: knowledgebases.write | 与版本管理(Versions)就绪门禁联动 |
| 取消正在运行的索引作业 | 最近任务列表行操作「取消(Cancel)」 | POST /v1/knowledgebases/{kbId}/index-operations/{operationId}/cancel | knowledgeBase.cancelIndexOperation() | 角色:owner、admin、developerScope: knowledgebases.write | 仅对 queued 或 running 状态的作业生效 |
| 清空指定派生索引数据 | 能力卡片更多菜单「清空索引数据(Clear)」 | POST /v1/knowledgebases/{kbId}/index-capabilities/{capability}/clear | knowledgeBase.clearIndexCapability() | 角色:owner、adminScope: knowledgebases.write | 请求体须显式传入 "confirm": true;仅清理派生索引,不删原始文档与基础分块 |
功能详解与操作指南
步骤 1:配置并启用 GraphRAG、RAPTOR 与 LLM Wiki 能力
登录控制台,进入项目
企业智能客服与知识中台 (enterprise-ai-hub-210)-> 知识库 ->企业智能客服与技术支持知识库 (kb_enterprise_support)-> 点击顶部 知识索引(Indexes) 页签。配置 GraphRAG(知识图谱):
点击 GraphRAG 卡片右上角的 配置(Configure) 按钮;
打开 启用能力(Enabled) 开关;
在 实体类型(Entity Types) 中输入:
产品模块、故障码、API接口、配置参数、SOP步骤、专家角色;勾选 启用词库增强(
lexiconEnabled),使图谱抽取自动关联已绑定的lex_enterprise_synonyms与lex_support_stopwords;输出语言(Language) 选择
简体中文 (zh-CN),向量化批大小(graphragEmbedBatchSize) 保持32,点击 保存配置。
配置 RAPTOR(递归聚类摘要树):
点击 RAPTOR 卡片上的 配置(Configure);
打开 启用能力(Enabled) 开关,聚类范围(Scope) 选择
整库跨文档聚类 (knowledgeBase),最大层数(Max Levels) 设为3,单簇大小(Cluster Size) 设为10,点击 保存配置。
配置 LLM Wiki(知识百科编译):
点击 LLM Wiki 卡片上的 配置(Configure);
打开 启用能力(Enabled) 开关,设置 输出语言(
wikiLanguage) 为zh-CN,最大页面并发数(pageMaxConcurrent) 为4,并勾选 等待 GraphRAG 就绪后编译(await_graphrag),点击 保存配置。
步骤 2:派发异步构建作业(build / repair)并监控代际演进
在 Indexes 页签上方,针对处于
configured或stale状态的能力卡片,点击 构建(Build):增量构建(
operation: "build", executionMode: "incremental"):推荐日常文档新增或语雀同步(data_source_sync)后使用,仅对增量变更的分块执行抽取与合并,速度最快、Token 消耗最低;全量重建(
operation: "build", executionMode: "rebuild"):当修改了entityTypes、切换了lexiconEnabled或调整了 RAPTOR 的scope(staleReason: config_changed)时使用,基于全库ready文档生成全新代际(currentGeneration + 1);索引修复(
operation: "repair"):当某次构建因上游网络抖动中断或需要对齐孤立边/节点时使用。
在页面下方的 索引构建任务列表(Index Operations) 中,可实时查看作业ID、目标能力(
graphrag/raptor/wiki)、执行模式、耗时以及进度详情。构建成功后,三张能力卡片状态均显示为绿色的ready,且currentGeneration递增。
步骤 3:通过 REST API 完整操控三大索引能力与作业生命周期
# 1. 查询知识库三大高级索引能力的当前状态、代际号与陈旧原因 (GET /index-capabilities)
curl -X GET "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-capabilities" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>"

# 2. 配置并启用 GraphRAG 索引能力,开启词库增强与自定义实体类型 (PATCH /index-capabilities/graphrag)
curl -X PATCH "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-capabilities/graphrag" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "enabled": true,
    "outputLanguage": "zh-CN",
    "config": {
      "entityTypes": ["产品模块", "故障码", "API接口", "配置参数", "SOP步骤", "专家角色"],
      "lexiconEnabled": true,
      "language": "zh-CN",
      "graphragEmbedBatchSize": 32
    }
  }'

# 3. 配置并启用 RAPTOR 递归聚类摘要树能力 (PATCH /index-capabilities/raptor)
curl -X PATCH "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-capabilities/raptor" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "enabled": true,
    "outputLanguage": "zh-CN",
    "config": {
      "scope": "knowledgeBase",
      "maxLevels": 3,
      "clusterSize": 10
    }
  }'

# 4. 配置并启用 LLM Wiki 能力并开启 await_graphrag 栅栏 (PATCH /index-capabilities/wiki)
curl -X PATCH "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-capabilities/wiki" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "enabled": true,
    "outputLanguage": "zh-CN",
    "config": {
      "wikiLanguage": "zh-CN",
      "pageMaxConcurrent": 4,
      "await_graphrag": true
    }
  }'

# 5. 触发带幂等键的增量或全量索引构建作业 (POST /index-operations)
curl -X POST "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-operations" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "capability": "graphrag",
    "operation": "build",
    "executionMode": "incremental",
    "idempotencyKey": "iop_graphrag_kb_support_20261022_01"
  }'

# 6. 取消正在排队或运行中的构建作业 (POST /index-operations/{operationId}/cancel)
curl -X POST "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-operations/iop_7c6b5a4d3e2f1098/cancel" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>"

# 7. 安全清空指定派生索引产物(需显式传入 confirm: true,不影响原始文档与分块)
curl -X POST "https://appbuild.oceanbase.com/v1/knowledgebases/kb_enterprise_support/index-capabilities/raptor/clear" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  -H "X-Appwrite-Key: <APPBASE_API_KEY>" \
  -H "Content-Type: application/json" \
  -d '{
    "confirm": true
  }'
常见问题与排障(FAQ)
Q1:为什么我已经新上传了文档且文档状态变成了 ready,但 GraphRAG 和 RAPTOR 卡片状态变成了黄色的 stale(陈旧)?此时线上检索会报错吗?
原因分析: 当底层文档新增(
document_ingested)、删除(document_deleted)、分块编辑(chunk_updated)或语雀数据源同步(data_source_sync)后,已构建的派生索引代际与最新文档分块之间产生了增量差异,因此系统将其状态标记为stale。此时线上检索绝不会报错:stale状态下,上一代际(currentGeneration)已就绪的图谱与 RAPTOR 摘要树依然正常参与线上混合检索,只是尚未包含最新变更文档的图谱边与高层聚类摘要。解决措施: 在业务低峰期或文档批量上传完毕后,进入 知识索引(Indexes) 页签点击对应卡片的 构建(Build)(选择
executionMode: "incremental"),待增量构建完成后状态即恢复为ready。注意:若您准备在 版本管理(Versions) 中封存(Seal)草稿版本,就绪门禁会强制要求所有已启用的索引能力必须消除stale状态并达到ready。
Q2:同时触发了 GraphRAG 和 LLM Wiki 构建,为什么 Wiki 任务一直停留在等待状态(await_graphrag)没有立即开始生成页面?
原因分析: 这是系统有意设计的
await_graphrag依赖栅栏保护机制。LLM Wiki 编译器在生成全局目录树(kb-index)和专题章节页时,需要引用 GraphRAG 抽取出的核心实体与 Leiden 社区摘要报告来提升百科结构完整性。如果 GraphRAG 尚在抽取或社区聚类中,Wiki 任务会主动挂起等待,避免基于残缺或旧版图谱编译出不一致的百科页面。解决措施: 无需人工干预或取消任务。一旦同批次的
GraphRAG构建作业流转为completed,后台调度器会在数秒内自动解除栅栏并按pageMaxConcurrent并发启动 Wiki 页面编译。
Q3:开启 GraphRAG 的 lexiconEnabled: true 后,修改了项目词库 lex_enterprise_synonyms 中的同义词词条,已生成的知识图谱会自动合并旧节点吗?
原因分析:
lexiconEnabled: true是在 GraphRAG 索引构建时(Index-time) 生效的机制——即在qwen-plus抽取实体后、写入 OceanBase 图谱表前,按当时的词库快照将同义变体归一到主词。因此,事后在词库中新增或修改同义词,会立即对在线检索(/search的 Query Rewrite)生效,但不会自动改写已经持久化在数据库中的历史图谱节点。解决措施: 如果您在
lex_enterprise_synonyms中补充了重要的核心领域同义词并希望更新图谱拓扑,请前往 知识索引(Indexes) 页签,在 GraphRAG 卡片上点击 重建(Rebuild)(operation: "build", executionMode: "rebuild"),系统将应用最新词库规则重新消歧并合并实体节点。
Q4:执行 POST .../index-capabilities/{capability}/clear 清空索引后,我上传的 4 篇源文档和基础向量分块会被删掉吗?
原因分析:
clear接口的设计边界是仅清除指定高阶能力(如graphrag或raptor)派生出的实体表、关系边表、社区报告或聚类摘要树节点,并将该能力的就绪状态重置为初始未构建态。解决措施: 您可以放心执行
clear(需传入"confirm": true):知识库内的原始文件(存储在kb_enterprise_docs)、文档元数据、基础分块(Chunks)以及1024维基础向量索引 100% 完好无损,基础混合检索(searchMode=hybrid)不受任何影响。