
记忆遗忘机制、艾宾浩斯衰减与数据保留治理
功能概述与核心场景
一个只会无限追加写入而缺乏受控遗忘机制(Controlled Forgetting)的企业级记忆系统,随着运行时间推移必然会走向退化:
过时事实污染上下文窗口:三个月前某次工单排查中的临时配置或早已下线的测试节点,如果长期滞留在检索候选集中,会干扰大模型对当前生产状态的判断;
高价值记忆被长尾噪声淹没:未经筛选的寒暄、一次性调试草稿(
working)与核心架构基线(long_term)争夺有限的向量召回 Top-K 名额与 Prompt Token 预算;企业数据安全与隐私合规要求(GDPR / 个人信息保护):企业合规审计明确要求对对话记录(
conversation)、客观事实(fact)、请求审计事件(audit)以及用户主动要求删除的数据实施严格的生命周期保留窗口(TTL)与不可逆擦除。
为此,Agentbase Memory(v2.10.0)构建了由 艾宾浩斯自适应衰减与跨层晋升模型(Ebbinghaus Adaptive Decay & Promotion)、三阶段后台遗忘流水线(Forgetting Pipeline)、系统级 TTL 保留策略(retention 命名空间) 以及 即时隐私删除与防重学墓碑(Explicit DELETE) 组成的全生命周期遗忘治理体系。
在 Agentbase 企业智能中台(组织 ID:69c6d1aa00062e6bb60)的标杆项目 企业智能客服与知识中台(项目 ID:enterprise-ai-hub-210,基于 OceanBase Shared V2 存储模式)中,运维与架构团队通过遗忘 Pipeline 自动淘汰 user_lina_002 在日常工单中的一次性临时排查草稿,同时将 user_zhangwei_001 反复高频召回的集群排障参数从 working 自动晋升至 long_term,并通过单用户 Dry-Run 预览工具在策略上线前零风险验证每条记忆的保留、晋升与归档计划。
核心概念与架构
Agentbase Memory 的遗忘治理架构将“基于认知热度的自适应衰减晋升”、“基于合规日历的硬过期(Hard TTL)”与“基于用户意愿的主动删除(Explicit Delete)”清晰解耦,如下图所示:
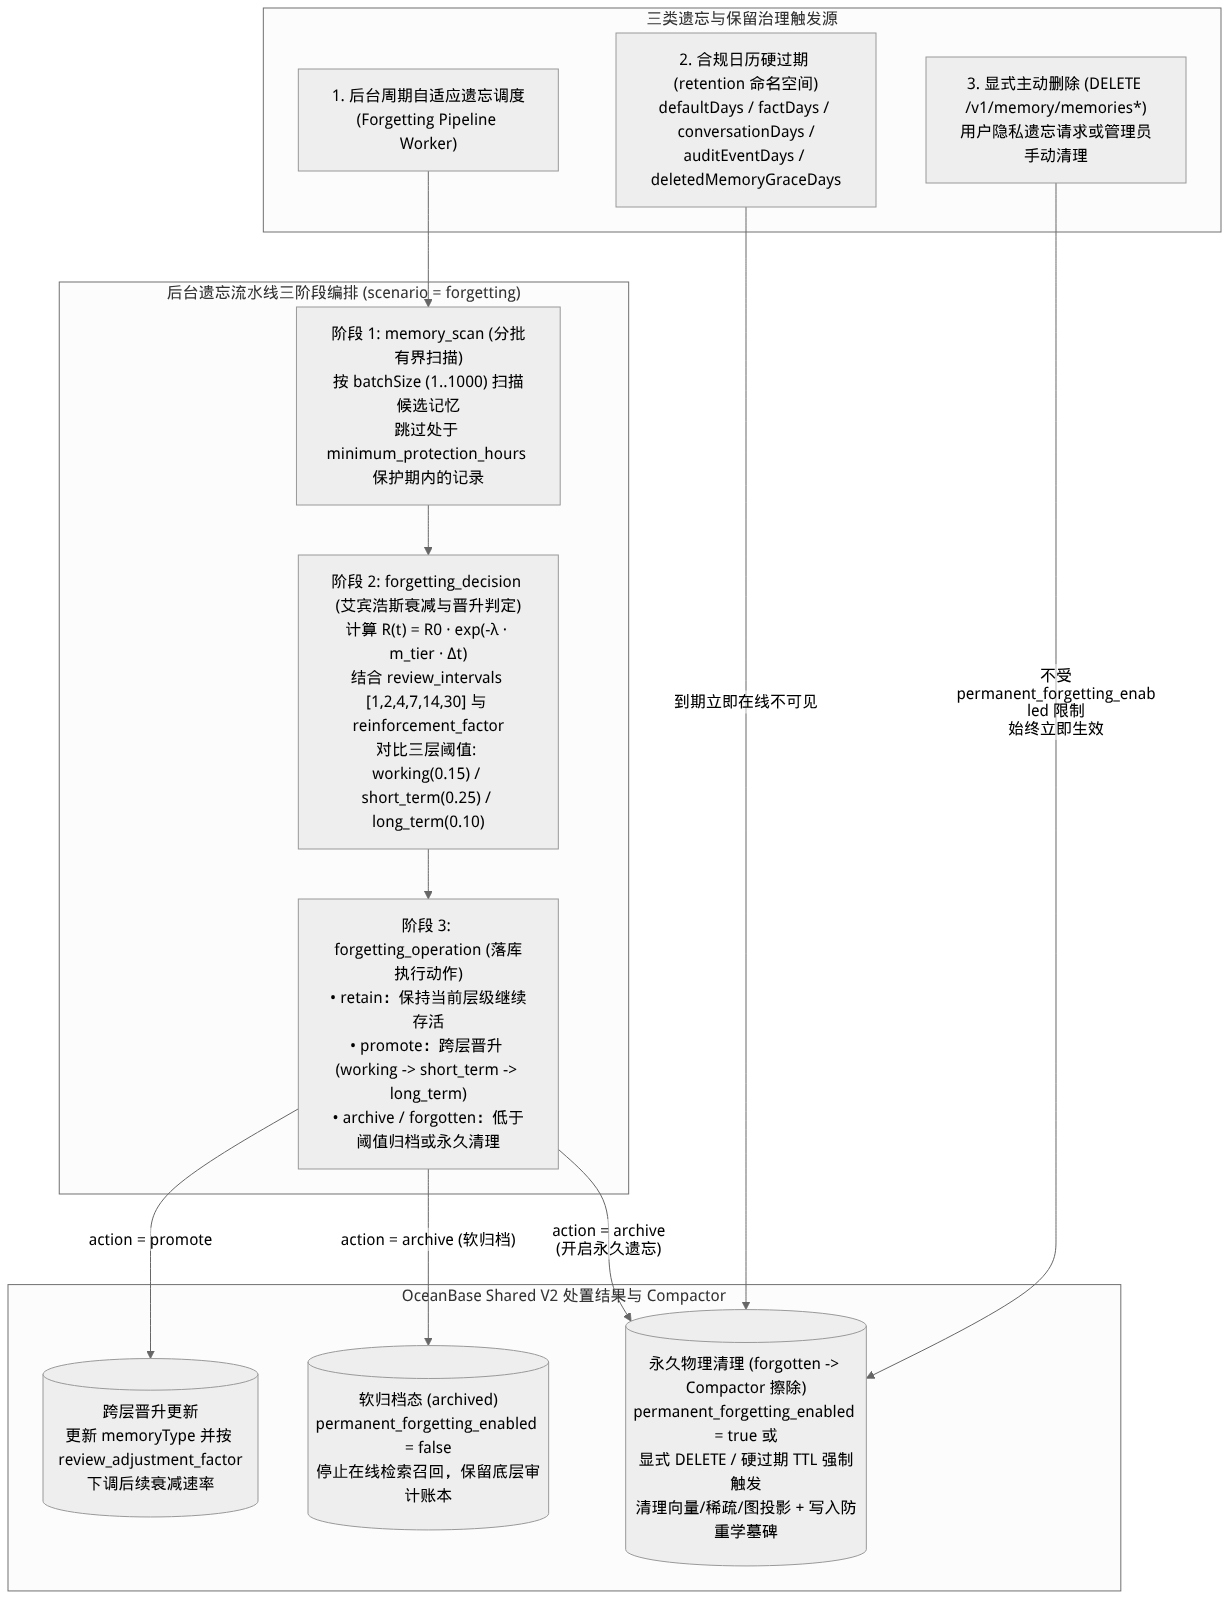
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
1. 艾宾浩斯自适应遗忘数学模型与跨层晋升机制
后台遗忘流水线不依赖不可控的大模型主观猜测,而是采用确定性的艾宾浩斯指数衰减与间隔复习(Spaced Repetition)数学模型评估每一条记忆的实时保留率(Retention Score):
(1)核心保留率衰减公式
在不发生召回强化的自然流逝状态下,一条记忆在距上次强化时间间隔 $\Delta t$ 时的保留率 $R(t)$ 计算公式为:
$$R(t) = R_0 \cdot e^{-\lambda \cdot m_{\text{tier}} \cdot \Delta t}$$
其中各数学参数的工程映射与默认取值如下:
| 数学符号 | 配置参数名 | 默认值 / 取值范围 | 物理意义与调优作用 |
|---|---|---|---|
| $R_0$ | initial_retention | 1.0(范围 0.1 ~ 1.0) | 记忆刚创建或刚完成一次强化的初始保留率基准值。 |
| $\lambda$ | decay_rate | 0.05(范围 0.001 ~ 1.0) | 全局基准时间衰减常数。$\lambda$ 越大,所有层级的记忆整体遗忘速度越快。 |
| $m_{\text{tier}}$ | decay_rate_multipliers | - working: 2.0- short_term: 1.0- long_term: 0.3 | 三层时效记忆的专属衰减速率乘数: - 工作记忆( working)以 2 倍速率快速衰减;- 短期记忆( short_term)按 1 倍标准速率衰减;- 长期记忆( long_term)按 0.3 倍慢速衰减,长期稳固留存。 |
| $T_{\text{protect}}$ | minimum_protection_hours | 24 小时(可在 policy.forgetting 中调至 168 小时) | 新记忆最短保护窗口:记忆写入后的前 $T_{\text{protect}}$ 小时内处于免衰减保护期,后台遗忘扫描不会将其淘汰归档,防止刚写入的重要信息在尚未被下一轮会话消费前就被过早衰减。 |
(2)间隔复习强化与跨层自动晋升(Spaced Repetition & Tier Promotion)
人类记忆之所以能从瞬时工作记忆转化为终身长期记忆,关键在于遵循特定时间间隔的重复提取(Recall)。Agentbase Memory 将这一机制编码为确定性状态转移:
间隔复习窗口(
review_intervals):默认配置为[1, 2, 4, 7, 14, 30](单位:天)。召回强化因子(
reinforcement_factor)与衰减阻尼调整(review_adjustment_factor): 当某条记忆在在线搜索(search)、统一召回(recall)或正向知识反馈(feedback)中被有效命中并跨越当前复习间隔节点时:其当前保留率通过
reinforcement_factor(默认1.35)获得显著回升(上限截断于1.0);其后续等效衰减斜率乘以
review_adjustment_factor(默认0.85),意味着被成功复习的次数越多,遗忘曲线越平缓;自动跨层晋升(
working -> short_term -> long_term):当处于working层级的临时记忆在复习周期内达到晋升频次门槛,遗忘 Pipeline 的决策节点会输出action: "promote",将其自动晋升为short_term(衰减乘数从2.0降至1.0);同理,持续高价值的short_term记忆会自动晋升为long_term(衰减乘数降至0.3)。
(3)三层独立遗忘阈值(Forgetting Thresholds)
不同层级的记忆承担不同的上下文角色,因此适用独立的淘汰阈值:
working_threshold(默认0.15):工作记忆由于衰减极快($m_{\text{working}}=2.0$),一旦保留率跌破0.15且无近期复习命中,立即判定为已完成使命的临时草稿并执行归档;short_term_threshold(默认0.25):短期记忆要求较高的近期活跃度,若在跨天周期内未被再次提及且保留率低于0.25,则退出活跃短期上下文;long_term_threshold(默认0.10):长期记忆享受最低的淘汰门槛(0.10)与最慢的衰减速度($m_{\text{long_term}}=0.3$),确保核心架构事实与个人偏好持久可用。
2. 后台遗忘流水线(Forgetting Pipeline)三阶段编排
在 记忆 → 配置 → 遗忘 Pipeline 中,每条遗忘流水线(scenario="forgetting")固定由以下三个确定性阶段按序编排:
| 阶段序号 | 节点标识 (step) | 是否可关闭 | 详细执行逻辑与核心配置项 |
|---|---|---|---|
| 阶段 1 | memory_scan(扫描记忆) | 必选 | 按后台 Worker 调度周期分批拉取项目内的候选记忆记录。通过 batchSize(取值范围 1~1000,默认 200)严格限制单次扫描批次大小,保障高并发生产库(OceanBase Shared V2)在线读写零抖动。 |
| 阶段 2 | forgetting_decision(遗忘判断) | 可开关 | 对扫描出的每条记忆综合计算:是否已过 minimum_protection_hours 保护期、当前艾宾浩斯保留率 $R(t)$、累计复习阶段、人工负向反馈以及是否触达硬过期时间,输出单条决策动作:retain(保留)、promote(跨层晋升)、review(标记待复习)或 archive / expire(归档/淘汰)。 |
| 阶段 3 | forgetting_operation(执行遗忘) | 必选 | 在正式后台运行中批量落库执行阶段 2 的决策;而在控制台 运行样例(Dry-run) 验证模式下,该节点自动切换为只读模拟态(dryRun: true),仅汇总输出预计动作清单而绝不修改任何数据库记录。 |
功能入口与权限矩阵
控制台入口位于:项目 enterprise-ai-hub-210 → 记忆(Memory) → 配置 → 遗忘 Pipeline / 基础配置(路由:/console/project-{region}-enterprise-ai-hub-210/memory?tab=configuration),显式删除入口位于 记忆 → 记忆 页签。
| 功能场景 | 控制台 UI 入口 | REST API 端点 | Server SDK 方法 (agentbase-node-sdk@2.10.0) | 所需 RBAC / API Key Scope | 关联模块与影响范围 |
|---|---|---|---|---|---|
| 配置与发布遗忘 Pipeline | 记忆 → 配置 → 遗忘 Pipeline | GET/POST /v1/memory/pipelines、PATCH /v1/memory/pipelines/{id}、POST .../publish | 控制面 HTTP API | Console 管理员或 projects.write | 控制后台自适应衰减、复习晋升与扫描批次 |
| 单用户 Dry-Run 遗忘计划预览 | 遗忘 Pipeline → 运行样例 | POST /v1/memory/pipelines/{pipelineId}/validate | 控制面 HTTP API | projects.write | 只读扫描指定 userId 记忆并返回 retain/promote/archive 预览 |
配置全局 policy.forgetting 参数 | 记忆 → 配置 → 基础配置 (policy) | GET/PUT /v1/projects/{projectId}/memory/config/policy | 控制面 HTTP API | projects.read / projects.write | 管理 permanent_forgetting_enabled 与默认衰减阈值 |
配置合规保留天数 (retention) | 记忆 → 配置 → 基础配置 (retention) | GET/PUT /v1/projects/{projectId}/memory/config/retention | 控制面 HTTP API | projects.read / projects.write | 管理记忆、审计日志、终态任务与幂等回执的 TTL 天数 |
| 显式单条/按用户批量删除记忆 | 记忆 → 记忆 列表行尾 删除 | DELETE /v1/memory/memories/{memoryId}、DELETE /v1/memory/memories | memory.delete / memory.deleteMany | memories.delete | 立即生效,触发 Compactor 清理索引并使关联的 L2/L3 上下文进入隔离/重建 |
功能详解与操作指南
步骤一:在控制台配置遗忘 Pipeline 与艾宾浩斯衰减参数
登录 Agentbase 控制台,进入组织
Agentbase 企业智能中台(69c6d1aa00062e6bb60)下的项目企业智能客服与知识中台(enterprise-ai-hub-210),在左侧导航栏单击 记忆(Memory) 并切换至 配置 页签。在左侧或顶部场景栏中选择 遗忘 Pipeline(
forgetting)。若首次定制,单击 从默认新建 Pipeline 创建一份可编辑草稿。依次展开三个阶段节点并核对/调整生产参数:
节点 1:
memory_scan(扫描记忆):将单批扫描上限batchSize设置为200(范围1~1000);节点 2:
forgetting_decision(遗忘判断):保持节点开启(
enabled: true);核对初始保留率
initial_retention: 1.0、基准衰减率decay_rate: 0.05;核对三层衰减乘数
decay_rate_multipliers:working: 2.0、short_term: 1.0、long_term: 0.3;核对三层遗忘阈值:
working_threshold: 0.15、short_term_threshold: 0.25、long_term_threshold: 0.10;设置新记忆最短保护期
minimum_protection_hours(默认24小时;对于高优生产项目可设为168小时即 7 天);核对间隔复习数组
review_intervals: [1, 2, 4, 7, 14, 30]、强化因子reinforcement_factor: 1.35与复习调整系数review_adjustment_factor: 0.85;按合规诉求设置
permanent_forgetting_enabled(默认false软归档;设为true时自适应衰减低于阈值的记忆将进入物理清理)。
单击顶部 保存草稿。
步骤二:执行单用户 Dry-Run 遗忘计划预览(POST /v1/memory/pipelines/{pipelineId}/validate)
在将新的衰减率或遗忘阈值发布上线前,管理员最关心的问题是:“如果应用这套参数,VIP 客户 user_zhangwei_001 的哪些记忆会被归档、哪些会被晋升、哪些会保留?”
在 遗忘 Pipeline 编辑器右侧的 运行样例(Dry-run) 区域,输入测试目标用户 ID
user_zhangwei_001。单击 运行样例。系统会实时只读扫描
user_zhangwei_001当前的可见记忆,按草稿中的艾宾浩斯参数计算每条记忆的 $R(t)$ 得分,并返回完整的预览报告(dryRun: true),全程对数据库零写入、零破坏。也可通过控制面 API 直接调用该 Dry-Run 预览接口:
export APPBASE_ENDPOINT="https://appbuild.oceanbase.com/v1"
export APPBASE_PROJECT_ID="enterprise-ai-hub-210"
export FORGETTING_PIPELINE_ID="pipe_forgetting_ent_210"

# 对 user_zhangwei_001 执行遗忘 Pipeline 单用户 Dry-Run 预览 (零数据库变更)
curl -fsS -X POST "${APPBASE_ENDPOINT}/memory/pipelines/${FORGETTING_PIPELINE_ID}/validate" \
  -H "Cookie: ${APPBASE_CONSOLE_SESSION}" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Mode: admin" \
  -H "Content-Type: application/json" \
  --data '{
    "userId": "user_zhangwei_001",
    "scope": "user"
  }' | jq .
典型 Dry-Run 预览响应结构如下(清晰列出扫描总数 scanned 及每条记忆预计执行的 retain / promote / archive 动作):
{
  "pipelineId": "pipe_forgetting_ent_210",
  "scenario": "forgetting",
  "dryRun": true,
  "scanned": 18,
  "summary": {
    "retain": 13,
    "promote": 3,
    "archive": 2
  },
  "actions": [
    {
      "memoryId": "mem_8f92a1c4b7e011ef",
      "userId": "user_zhangwei_001",
      "currentTier": "long_term",
      "retentionScore": 0.94,
      "threshold": 0.10,
      "action": "retain",
      "reason": "within_protection_or_above_long_term_threshold"
    },
    {
      "memoryId": "mem_3c71d9a0b81244ef",
      "userId": "user_zhangwei_001",
      "currentTier": "working",
      "targetTier": "short_term",
      "retentionScore": 0.88,
      "reviewStage": 2,
      "action": "promote",
      "reason": "spaced_repetition_reinforced_across_intervals"
    },
    {
      "memoryId": "mem_1a09e4f2c33188ab",
      "userId": "user_zhangwei_001",
      "currentTier": "working",
      "retentionScore": 0.09,
      "threshold": 0.15,
      "action": "archive",
      "reason": "retention_below_working_threshold"
    }
  ]
}
确认 Dry-Run 预览结果符合预期后,单击 发布 并勾选 设为该场景默认 Pipeline(
makeDefault: true)。
步骤三:区分软归档、permanent_forgetting_enabled、显式 DELETE 与 retention 命名空间
在生产运维中,务必准确区分以下三种遗忘与数据保留机制的行为边界:
1. 三种清理机制的行为边界对比表
| 对比维度 | 后台自适应衰减遗忘(policy.forgetting) | 系统级日历 TTL 保留策略(retention 命名空间) | 显式主动删除(DELETE /v1/memory/memories*) |
|---|---|---|---|
| 触发条件 | 记忆保留率 $R(t)$ 跌破对应层级阈值(如 working < 0.15) | 记录存活天数超过 retention 配置的日历天数上限(硬过期) | 业务服务端或控制台管理员显式调用 DELETE 接口 |
permanent_forgetting_enabled 的作用 | 直接受该开关控制: - false(默认):仅执行软归档(Archive),停止被在线搜索召回,但保留底层物理行供合规审计;- true:标记 forgotten 并交由后台 Compactor 永久擦除向量与主表数据。 | 不受该开关限制:一旦触达硬过期时间,在线读取立即不可见(Fail-closed),并在宽限期后由后台物理清理。 | 不受该开关限制:无论 permanent_forgetting_enabled 是 true 还是 false,显式 DELETE 始终立即生效并触发不可逆清理。 |
| 防重学墓碑保护 | 软归档记录支持通过后续治理恢复 | 硬过期清理后按新写入处理 | 自动记录内容哈希墓碑,拦截相同内容静默重学(除非显式传 reRemember: true) |
| 对同项目 Storage 原文件的影响 | 不删除 agent_multimedia_bucket 中的原始图片/PDF | 不删除 Storage 桶内原始文件 | 绝不级联删除 Storage 桶中的原始文件(需删除文件请调 Storage API) |
2. retention 命名空间参数配置与有界批量删除实战
在 记忆 → 配置 → 基础配置(/v1/projects/{projectId}/memory/config/retention)中,可按数据类型精细配置保留周期:
defaultDays(或通用记忆保留期memoryRetentionDays,默认180天):未命中细分种类的记忆默认保留天数;factDays(默认365天):提炼后的客观事实记忆(recordKind: "fact")保留天数;conversationDays(默认90天):原始对话类记忆(recordKind: "conversation")保留天数;auditEventDays(或auditRetentionDays,默认90天):GET /v1/memory/audits请求审计事件的保留天数;deletedMemoryGraceDays/terminalJobDays/idempotencyReceiptDays:已标记删除记忆的物理擦除宽限期、终态异步任务记录保留期(如14天)与幂等回执保留期(如7天)。
当某位客户发起隐私注销请求,需要立即清空其名下全部记忆时,使用 agentbase-node-sdk@2.10.0 循环执行有界批量删除(每次最多 500 条,检查 hasMore 直至清零):
// 使用官方服务端 SDK: agentbase-node-sdk@2.10.0 按用户执行合规全量遗忘清理
import { Client, Memory } from 'agentbase-node-sdk';

const client = new Client()
    .setEndpoint('https://appbuild.oceanbase.com/v1')
    .setProject('enterprise-ai-hub-210')
    .setKey(process.env.APPBASE_API_KEY);

const memory = new Memory(client);

async function purgeAllUserMemories(userId) {
    let hasMore = true;
    let totalDeleted = 0;

    while (hasMore) {
        const batchRes = await memory.deleteMany({
            userId,
            scope: 'user',
            limit: 200,
            reason: '履行用户隐私合规删除请求 (GDPR Right to be Forgotten)'
        });

        totalDeleted += batchRes.deleted || 0;
        if ((batchRes.failed || 0) > 0) {
            throw new Error(`批量遗忘存在失败项: failed=${batchRes.failed}`);
        }
        hasMore = Boolean(batchRes.hasMore);
    }

    console.log(`用户 ${userId} 记忆已全部清理完毕,累计永久遗忘 ${totalDeleted} 条记录。`);
}

await purgeAllUserMemories('user_lina_002');
常见问题与排障(FAQ)
1. 我已经将 permanent_forgetting_enabled 设置为 false,为什么调用 DELETE /v1/memory/memories/{memoryId} 后该记忆仍然被永久清理了?
原因分析:
permanent_forgetting_enabled仅用于控制后台遗忘 Pipeline 因艾宾浩斯保留率自然衰减低于阈值而触发的自动淘汰行为(设为false时采用软归档以防误伤低频但仍有参考价值的记忆)。而通过控制台删除按钮或DELETEAPI 发起的显式删除,代表明确的数据合规擦除指令,系统始终立即将其置为forgotten并交由 Compactor 清理全部向量、稀疏索引与图投影。解决措施:这是符合隐私法规的预期设计。如果希望仅暂停某条记忆的召回而不销毁它,请勿调用
DELETE,可通过调整元数据过滤条件或依赖后台软归档机制。
2. 用户主动删除了一条记忆后,为什么后续对话中再次提到完全相同的内容时,系统没有重新写入这条记忆?
原因分析:为防止智能体在用户明确要求“忘掉某条信息”后,又在后续会话轮次或重试请求中违背用户意愿静默“重新学会”同一条事实,Agentbase Memory 在显式删除时会记录该记忆内容的防重学墓碑指纹(Tombstone Fingerprint)。当后续请求仅更换了
Idempotency-Key但提交相同内容时,会被防重学守卫自动拦截。解决措施:如果用户事后改变主意,明确要求系统重新记住该信息,可在调用
POST /v1/memory/memories时显式传入布尔参数"reRemember": true以解除墓碑拦截。
3. 当底层 L1 记忆因到期或衰减被遗忘后,基于它构建的用户画像和 L2/L3 Dreaming 上下文会自动更新吗?
原因分析:
对于 L2/L3 分层上下文(Contexts):系统具备实时来源完整性守卫。一旦支撑某条 L2/L3 上下文的底层记忆被遗忘删除,该上下文的签名下钻令牌(
expansionToken)立即失效,且上下文状态会自动转为stale(过期)或quarantine(隔离),停止在线召回(Fail-closed);对于 用户画像(Profile):删除或遗忘单条底层记忆不会立即清空已生成的画像文本,但画像来源表会自动剔除已失效的记忆关联。
解决措施:在批量清理或遗忘错误记忆后,可前往 记忆 → 画像 单击 重建画像(
POST /v1/memory/memories/users/{userId}/profile/rebuild),并前往 记忆 → 上下文 对变为stale/quarantine的聚合单击 重建(POST /v1/memory/memories/contexts/{contextId}/rebuild),即可基于剩余存活的有效记忆重新生成干净的画像与高层上下文。