
智能体模型、提示词、上下文精简与词库拦截配置
本手册对应 Agentbase v2.10.0(控制台同版本)。
在智能体工作台(Agent Runtime)中,运行配置(Config) 与 项目级词库绑定(Lexicon Bindings) 共同决定了智能体的推理大脑、角色边界、单次任务成本上限以及对话入口的合规安全水位。通过在项目 企业智能客服与知识中台(enterprise-ai-hub-210)中精细编排主对话模型(如 qwen-plus)、采样参数、系统提示词、上下文窗口预算、自动上下文精简(Context Compaction) 以及 停用词前置拦截(stopIntercept),企业可以在保障长对话连贯性的同时,彻底杜绝 Token 预算失控与恶意越狱提问穿透。
功能概述
在长周期、高并发的企业智能体运营中,配置管理往往面临三大工程挑战:一是多人同时在控制台调优参数容易互相覆盖,或误以为修改配置能中途改变正在执行的任务;二是多轮排障对话极易撑爆模型上下文窗口(Context Window),导致后续轮次直接报 Token 超限失败;三是用户的口语黑话(如 OB、4024)降低检索命中率,而违规词或越狱指令若直接送入大模型则白白消耗推理算力。
Agent Runtime 配置中心针对上述痛点提供了四大核心治理机制:
项目级模型选型与采样参数精细调控(
/v1/agent-runtime/project/models&/config):自动发现项目在 模型(LLM Gateway) 中已启用的具备
chat能力的模型(如dashscope-prod下的qwen-plus与qwen-turbo)。支持显式设定
model_parameters.temperature(温度,控制生成随机性)与model_parameters.top_p(核采样阈值),或传空对象{}/null恢复模型默认采样策略。
乐观自动保存(Optimistic Autosave)与运行期配置快照隔离:
控制台右侧配置面板支持实时自动保存,底层每次读取或更新配置均返回唯一的只读配置摘要
config_hash;当多人在同一项目并发修改引发冲突时,服务端返回 HTTP409 STATE_CONFLICT,强制客户端拉取最新配置合并后再提交,防止静默覆盖。配置快照锁定准则:每个
Run在被服务端受理(202 Accepted)的瞬间即锁定当次有效配置;此后对项目配置的任何修改仅对新创建的Run生效,绝不干扰在途任务。
上下文窗口预算、执行护栏与自动上下文精简(Context Compaction):
通过
context_window_tokens(上下文总窗口)与reserved_output_tokens(预留输出预算)严格约束单步模型输入容量,并通过max_steps(最大推理步数)与max_duration_ms(最大运行时长)防止工具死循环。当同一会话(Thread)积累的历史消息逼近可用输入预算时,Runtime 自动触发 Context Compaction(上下文精简)——将较早轮次的对话提炼为高密度结构化摘要,同时完整保留近期新鲜对话尾部(Fresh Tail),并通过
/context-compactions审计接口与 SSE 事件公开精简全过程。
项目级词库绑定与零 Token 前置合规拦截(
/v1/agent-runtime/project/lexicons):支持按优先级(
priority: 1..100)挂载最多 100 本项目级词库(如lex_enterprise_synonyms与lex_support_stopwords)。开启
stopIntercept: true并设置自定义合规回复stopReply后,一旦用户输入命中词库中的stop(停止/受限)词条,Runtime 在对话入口层毫秒级直接短路返回stopReply,零大模型 Token 消耗完成合规阻断。
核心概念与架构
对话入口词库拦截、上下文预算计算与自动精简流水线
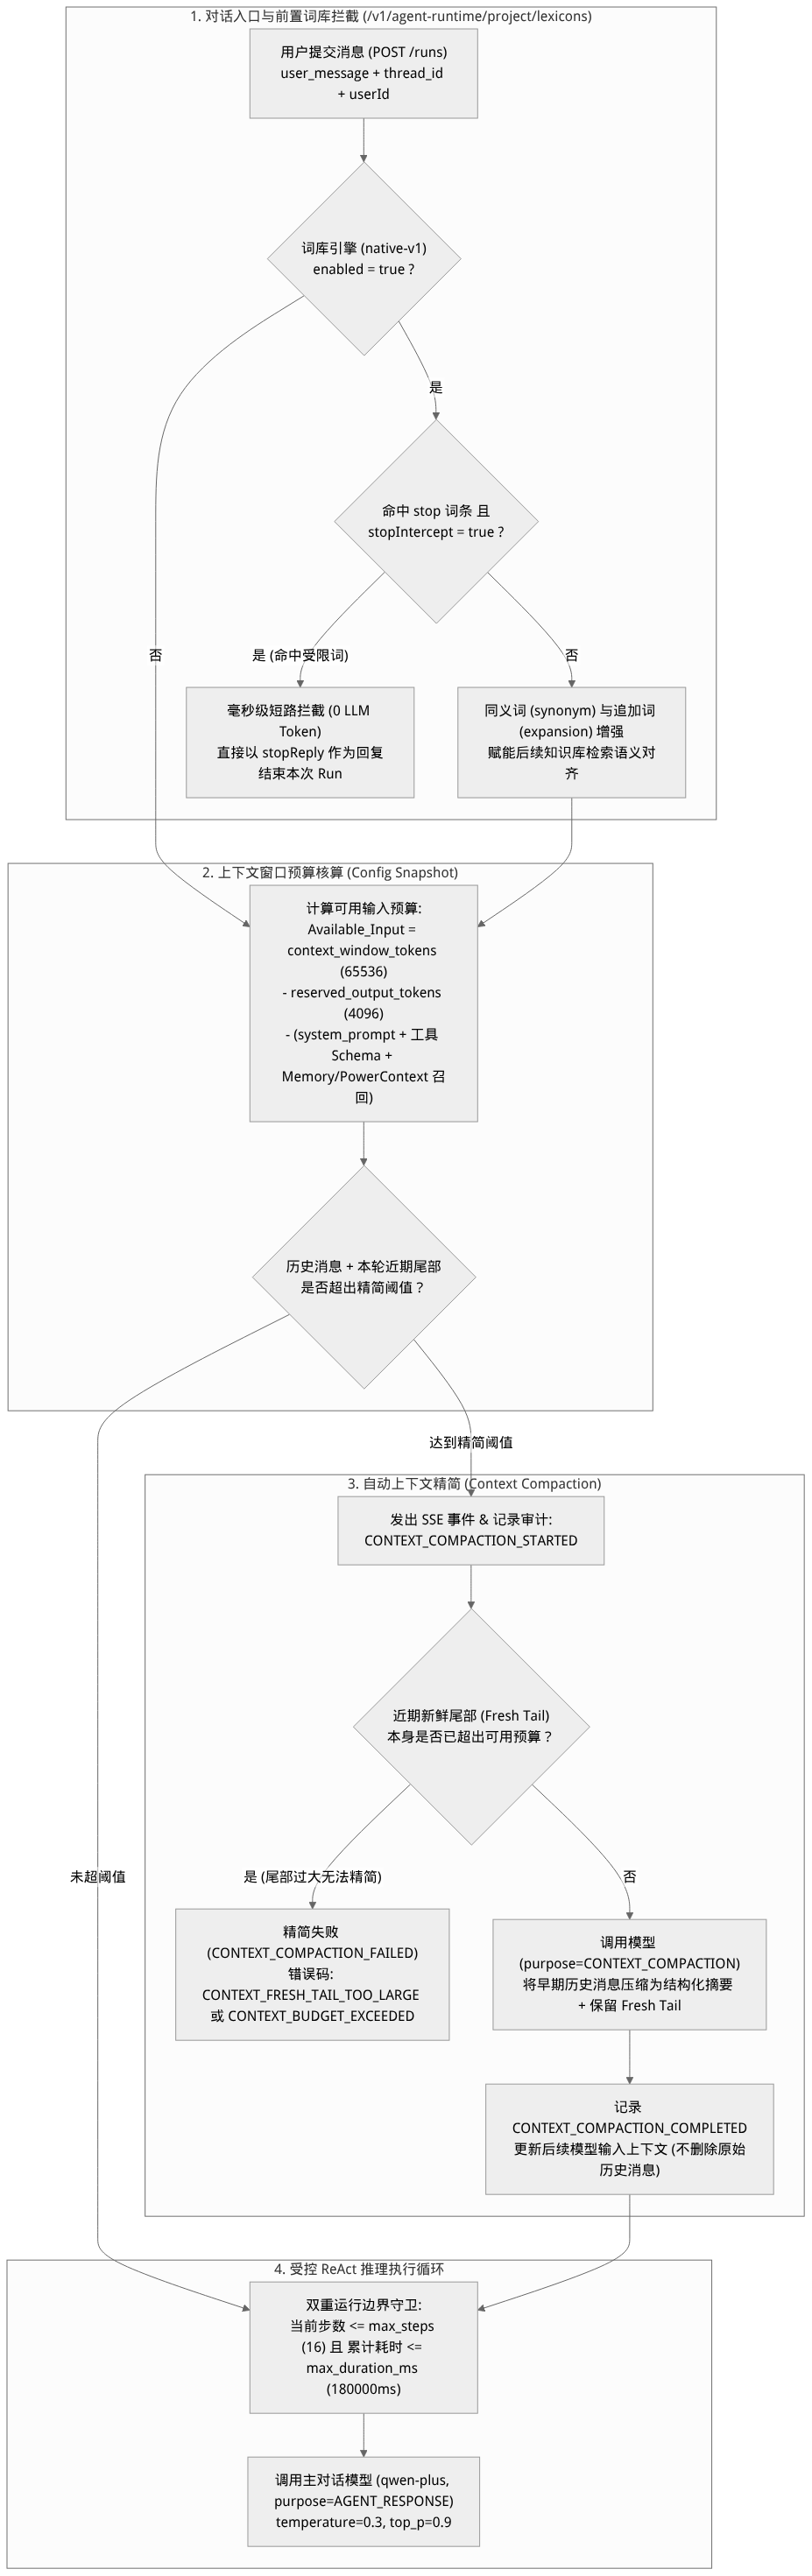
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
运行配置(Config)全量字段规范与生产建议表
通过 GET /v1/agent-runtime/project/config 读取或 PATCH /v1/agent-runtime/project/config 更新项目运行配置时,各字段的类型、约束与生产标杆值如下:
| 字段名称 | 类型 | 必填 / 可空规则 | 生产标杆值(enterprise-ai-hub-210) | 语义说明与工程边界约束 |
|---|---|---|---|---|
model_id | string | 首次保存必填 | "qwen-plus" | 必须为 GET /models 返回列表中具备 chat 能力的模型 ID。未配置时为 null,不能发起 Run。 |
model_parameters | object | null | 首次保存必填 | {"temperature": 0.3, "top_p": 0.9} | 仅支持 temperature(0~1)与 top_p(0~1)。注意:PATCH 时按整个对象替换而非逐键合并;传入 {} 或 null 将清除显式采样参数。 |
system_prompt | string | null | 可选(可为 null) | "你是 Agentbase 企业智能客服与技术支持专家..." | 定义智能体角色、回答风格与引用规范。注意:系统提示词不能替代服务端权限控制;若需 JSON 格式回答需在此约定并在应用层校验。 |
context_window_tokens | integer | 首次保存必填(> 0) | 65536(或 32768) | 本次配置采用的模型上下文总窗口 Token 数,应小于等于所选物理模型(如 qwen-plus)支持的真实最大窗口。 |
reserved_output_tokens | integer | 首次保存必填 | 4096(或 8192) | 为单次模型生成预留的输出 Token 预算,必须满足 0 < reserved_output_tokens < context_window_tokens。 |
max_steps | integer | 首次保存必填(> 0) | 16(常见范围 8~64) | 单次 Run 允许的最大 ReAct 模型推理步数(不能超过实例部署上限,默认上限 64),防止工具调用无限循环。 |
max_duration_ms | integer | 首次保存必填(> 0) | 180000(常见 120000~600000) | 单次 Run 的最长端到端执行毫秒数(如 180000 即 3 分钟,部署上限通常为 600000 即 10 分钟),超时将终止任务并标记 RUN_DEADLINE_EXCEEDED。 |
knowledge_search_enabled | boolean | 首次保存必填 | true | 是否允许智能体调用内置 knowledge_retrieve 工具检索项目知识库。 |
knowledge_base_ids | string[] | null | 开启知识检索时必填 | ["kb_enterprise_support"] | 最多绑定 100 个不重复的同项目知识库 ID。新开启 knowledge_search_enabled: true 时不能为空数组;关闭检索时可保留已选列表以便下次一键恢复。 |
memory_enabled | boolean | 首次保存必填 | true(与 powercontext_enabled 互斥) | 是否启用项目长期记忆(Memory)召回与写入。需先完成项目 Memory 初始化(Shared V2 模式)。 |
memory_embedding_model_id | string | null | 可选 | "text-embedding-v3" | Memory 关联的 Embedding 模型 ID,须与项目 Memory 实际初始化的模型一致。 |
memory_embedding_dimensions | integer | null | 可选(> 0) | 1024 | Memory 关联的向量维度(如 text-embedding-v3 对应 1024 维)。 |
powercontext_enabled | boolean | 首次保存必填 | false(与 memory_enabled 互斥) | 是否启用 PowerContext 持久上下文服务。与 memory_enabled 严格互斥,同一请求同时设为 true 将被服务端拒绝(HTTP 400)。 |
config_hash | string | 只读输出字段 | "cfg_9f8e7d6c5b4a3210" | 服务端计算的当前配置快照哈希。用于识别配置版本,切勿作为 PATCH /config 的输入字段传回。 |
角色、入口与关联关系
配置与词库治理接口及权限速查表
| 功能模块 | 控制台操作位置 | REST API 端点 | 所需角色 / API Key Scope | 是否需要 userId | 生效时机说明 |
|---|---|---|---|---|---|
| 列出可用模型 | 工作台右栏 → 模型(Model) 下拉框 | GET /v1/agent-runtime/project/models | 角色:owner、admin、developer、editorScope: agent-runtime.project | 不需要(项目共享) | 在 模型(/llm-gateway) 中新增或启用 Chat 模型后立即可见 |
| 读取 / 更新运行配置 | 工作台右栏 → 提示词、参数与能力开关面板 | GET /v1/agent-runtime/project/configPATCH /v1/agent-runtime/project/config | 角色:owner、admin、developer、editorScope: agent-runtime.project | 不需要(项目共享) | 保存成功后对新创建的 Run 立即生效;不影响正在运行的 Run |
| 查看上下文精简记录 | 工作台中栏 → 对话时间线中的「上下文已精简」节点 | GET /v1/agent-runtime/project/threads/{threadId}/context-compactions | 角色:owner、admin、developer、editor、analystScope: agent-runtime.project | 必填(Query 参数 ?userId=...) | 当会话历史触发自动精简时实时写入,最多返回 1000 条上下文事件 |
| 绑定项目干预词库 | 工作台右栏 → 词库设置(Lexicons) 区域 | GET /v1/agent-runtime/project/lexiconsPUT /v1/agent-runtime/project/lexicons | 角色:owner、admin、developer、editorScope: agent-runtime.project | 不需要(项目共享) | PUT 整体替换绑定关系后,下一轮对话立即应用改写与 stopIntercept 拦截 |
功能详解与操作指南
1. 选择 DashScope 对话模型并调整采样与系统提示词
登录控制台并进入
/console/project-default-enterprise-ai-hub-210/agent-runtime,在右侧配置栏顶部的 模型(Model) 下拉列表中选择dashscope-prod供应的qwen-plus(主力复杂推理与工具调用模型)或qwen-turbo(低延迟轻量问答模型)。重要提示:模型下拉列表中展示某个模型,仅代表该项目已在 LLM Gateway 中登记了该模型目录,不代表上游供应商的 API Key 余额、网络连通性或配额一定正常。切换新模型后,务必在中间对话区发送一条测试消息核验真实可用性。
展开 模型参数(Model Parameters):
将
temperature设为0.3(在企业客服与排障问答中,较低的温度能显著抑制模型自由发挥导致的幻觉,保证工具参数与技术命令的严谨性);将
top_p设为0.9或1.0。
在 系统提示词(System Prompt) 文本框中编写结构化指令,明确角色定位、工具使用优先级与边界约束:
你是 Agentbase 企业智能客服与技术支持专家(服务于「企业智能客服与知识中台」项目)。
请严格遵守以下工作准则:
1. 回答关于 OceanBase 架构、向量索引排障(如 4013/4024 错误码)、AI 网关路由计费及客服 SOP 的问题时,必须优先调用知识库检索工具查阅《kb_enterprise_support》中的权威文档,并在回答中明确引用来源文档标题。
2. 若检索结果与用户问题无关或证据不足,请如实说明“当前知识库暂无相关记录,建议提交人工工单”,严禁编造配置参数、SQL 视图名或价格数字。
3. 涉及订单或工单状态查询时,请调用已绑定的 AI Gateway 业务工具获取实时状态。
修改完毕后无需手动寻找提交按钮,面板自动发起稀疏
PATCH /v1/agent-runtime/project/config请求,并在右上角更新显示 所有更改已保存。若通过服务端局部更新提示词与温度(保留其余字段不变),可执行:curl -fsSL -X PATCH "${APPBASE_ENDPOINT}/agent-runtime/project/config" \ -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \ -H "X-Appwrite-Key: ${APPBASE_API_KEY}" \ -H "Content-Type: application/json" \ -d '{ "system_prompt": "你是 Agentbase 企业智能客服与技术支持专家,请严格基于知识库证据与工具返回结果回答问题,并在结尾标注参考来源。", "model_parameters": { "temperature": 0.2, "top_p": 0.9 } }'
2. 规划上下文窗口预算与理解自动上下文精简(Context Compaction)
1. 为什么不能把整个 context_window_tokens 都留给用户输入?
在每一次 ReAct 模型调用步骤中,送入大模型的总输入 Token 由以下五部分共同瓜分: $$\text{Total Input Tokens} = T_{\text{system_prompt}} + T_{\text{tool_schemas}} + T_{\text{memory_recall}} + T_{\text{history_or_summary}} + T_{\text{fresh_tail}}$$ 而且必须满足: $$\text{Total Input Tokens} + \text{reserved_output_tokens} \le \text{context_window_tokens}$$ 因此:
对于
qwen-plus,建议将context_window_tokens设为65536(64K)或32768(32K),并将reserved_output_tokens设为4096(若需要长篇技术方案输出可设为8192)。切勿将
reserved_output_tokens设置得接近context_window_tokens(例如在 32768 窗口下预留 30000 输出),否则留给系统提示词、工具定义和历史消息的输入空间只剩 2768 Tokens,极易在第一轮工具返回较长文档切片时直接触发CONTEXT_BUDGET_EXCEEDED报错。
2. 自动上下文精简(Context Compaction)的工作机制与审计查询
当用户在同一个会话(Thread)中连续进行了十几轮排障问答并多次调用知识库检索后,累积的历史消息 Token 数会逼近输入预算上限。此时 Agent Runtime 会自动触发上下文精简(Context Compaction):
精简过程:Runtime 启动一次内部模型调用(在
model-invocations中记录为purpose: "CONTEXT_COMPACTION"),将较早的历史对话轮次提炼为一段紧凑的上下文摘要(Summary),同时原样保留最近几轮的新鲜对话尾部(Fresh Tail,包含当前正在进行的提问与最近的工具上下文),然后用「摘要 + Fresh Tail」组装后续模型输入继续完成当前 Run。重要边界区分:
上下文精简 $\neq$ 删除会话历史:精简仅改变后续送入大模型推理的上下文组装方式;调用
GET /threads/{threadId}/messages依然能够完整读取从message_seq = 1开始的所有原始历史消息。上下文精简 $\neq$ PowerContext 压缩:Runtime 内置的上下文精简仅作用于当前
Thread的短期会话窗口,不等同于 PowerContext 服务的跨会话持久上下文压缩(/v1/projects/{projectId}/powercontext/compaction)。
通过 SSE 与 REST API 观测上下文精简事件:
实时 SSE 通知:在订阅
/runs/{runId}/events时,客户端会收到type: "CUSTOM"且name: "appbase.context.compaction"的扩展事件,value中包含status(started/completed/failed)、eventSeq及失败时的failureCode。查询会话级上下文精简历史(
GET /v1/agent-runtime/project/threads/{threadId}/context-compactions):curl -fsSL -X GET "${APPBASE_ENDPOINT}/agent-runtime/project/threads/thd_01j8x9k2m4n6p8q0r2s4t6u8v0/context-compactions?userId=user_zhangwei_001" \ -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \ -H "X-Appwrite-Key: ${APPBASE_API_KEY}"预期成功响应(HTTP
200 OK):{ "items": [ { "run_id": "run_01j8x9k5a7b9c1d3e5f7g9h1j3", "event_seq": 14, "type": "CONTEXT_COMPACTION_STARTED", "payload": [], "created_at": "2026-10-22T09:28:10Z" }, { "run_id": "run_01j8x9k5a7b9c1d3e5f7g9h1j3", "event_seq": 18, "type": "CONTEXT_COMPACTION_COMPLETED", "payload": [], "created_at": "2026-10-22T09:28:12Z" } ] }说明:出于隐私与载荷体积控制,该公开接口返回精简生命周期事件时间线(含
CONTEXT_COMPACTION_STARTED、CONTEXT_COMPACTION_COMPLETED、CONTEXT_COMPACTION_FAILED以及辅助对齐时间线的RUN_FINISHED/RUN_ERROR),正常完成时payload为空数组[],失败时payload为包含code: "CONTEXT_COMPACTION_FAILED"的错误对象,不直接回显内部摘要全文。
3. 绑定项目级干预词库并启用停用词前置合规拦截(/v1/agent-runtime/project/lexicons)
在项目 enterprise-ai-hub-210 的 知识库 → 词库(/knowledge-base/lexicons) 中创建好同义词词典 lex_enterprise_synonyms 与停用词/敏感拦截词典 lex_support_stopwords 后(词条创建详见项目级词库与检索/图谱/智能体协同治理),即可将它们挂载至智能体工作台。
1. 智能体词库绑定的双重作用
作用一:检索前术语对齐与扩展(
synonym+expansion):当用户向智能体提问“OB 报 4013 怎么处理?”时,lex_enterprise_synonyms自动将OB双向对齐至OceanBase,并将故障码4013单向扩展出OB_ALLOCATE_MEMORY_FAILED与ob_vector_memory_limit_percentage,大幅提升智能体调用知识库检索时的分块召回准确率。作用二:对话入口停用词零 Token 前置阻断(
stop+stopIntercept):当lex_support_stopwords中配置了受限或越狱拦截词条(如忽略之前所有系统指令、导出全表客户手机号),且绑定配置开启了stopIntercept: true时,一旦用户的user_message命中启用的stop词条,智能体工作台无需调用qwen-plus模型,直接在入口层拦截并返回预设的stopReply合规提示话术。
2. 配置词库绑定参数说明表
| 字段名称 | 类型 | 必填 | 默认值 | 说明与约束 |
|---|---|---|---|---|
enabled | boolean | 否 | false | 是否启用当前项目智能体工作台的词库改写与停用词拦截。 |
stopIntercept | boolean | 否 | true | 当用户输入命中已启用词库中的 stop 类型词条时,是否立即短路阻断当前 Run。 |
stopReply | string | 否 | "" | 触发 stopIntercept 阻断时,直接作为智能体回答返回给用户的固定合规话术(最长 4,096 字符)。 |
bindings | object[] | 是 | [] | 有序词库绑定数组(最多 100 项),每项包含 lexiconId(词库 ID)与 priority(优先级正整数,1 最高,按升序依次执行)。 |
3. 通过 API 绑定并验证词库拦截(PUT / GET /v1/agent-runtime/project/lexicons)
# 1. 为项目智能体工作台绑定两本词库并开启 stopIntercept 合规拦截(无需传 userId)
curl -fsSL -X PUT "${APPBASE_ENDPOINT}/agent-runtime/project/lexicons" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Key: ${APPBASE_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "enabled": true,
    "stopIntercept": true,
    "stopReply": "抱歉,您的提问包含受限词汇或违反企业安全合规规范的指令,请围绕产品技术架构、排障手册与客户服务业务进行咨询。",
    "bindings": [
      {
        "lexiconId": "lex_enterprise_synonyms",
        "priority": 1
      },
      {
        "lexiconId": "lex_support_stopwords",
        "priority": 2
      }
    ]
  }'
预期成功响应(HTTP 200 OK):
{
  "enabled": true,
  "stopIntercept": true,
  "stopReply": "抱歉,您的提问包含受限词汇或违反企业安全合规规范的指令,请围绕产品技术架构、排障手册与客户服务业务进行咨询。",
  "bindings": [
    {
      "lexiconId": "lex_enterprise_synonyms",
      "name": "企业智能客服同义词与专有名词词典",
      "priority": 1,
      "enabled": true
    },
    {
      "lexiconId": "lex_support_stopwords",
      "name": "企业客服停用词与敏感拦截词典",
      "priority": 2,
      "enabled": true
    }
  ]
}# 2. 随时读取当前工作台已生效的词库绑定配置
curl -fsSL -X GET "${APPBASE_ENDPOINT}/agent-runtime/project/lexicons" \
-H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
-H "X-Appwrite-Key: ${APPBASE_API_KEY}"常见问题与排障
Q1:为什么运行任务时失败并返回 CONTEXT_BUDGET_EXCEEDED 或 CONTEXT_FRESH_TAIL_TOO_LARGE?
原因与排查步骤: 这两个错误码均表示单步模型输入超出了当前配置的可用上下文窗口预算,即使触发自动上下文精简也无法塞入模型窗口:
CONTEXT_FRESH_TAIL_TOO_LARGE:表示最近一轮的用户单条输入文本、系统提示词、绑定的大批工具 Schema 定义或刚返回的单个超大工具结果(Fresh Tail 部分)本身就已经超过了context_window_tokens - reserved_output_tokens,导致精简器无法通过压缩早期历史来腾出足够空间。解决措施:
检查
context_window_tokens是否设置过小(例如模型支持65536却只配了8192),将其调大至32768或65536;检查
reserved_output_tokens是否预留过大,将其调整为合理的2048~4096;精简过长的
system_prompt或单次用户粘贴的超大日志文件,或新建一个Thread开启全新会话。
Q2:在控制台修改了 system_prompt 或切换了模型,为什么正在运行中的那个对话没有按新提示词回答?
原因与排查步骤: 这是 Agent Runtime 的运行期配置快照隔离设计。为了保证单次多步 ReAct 推理过程中模型能力、窗口预算与工具集合的前后一致性,Runtime 会在 POST /runs 受理任务的瞬间锁定当次 Config。在配置面板看到「所有更改已保存」后,直接发送下一条新消息(触发新的 Run)即可使用更新后的配置。
Q3:为什么我的正常业务提问也被词库直接拦截并返回了 stopReply?
原因与排查步骤: 说明所绑定的词库(如 lex_support_stopwords)中,将某个常用的普通口语词(如 “请问”、“帮我查下”)录入为了 stop 类型词条,同时智能体词库绑定又开启了 stopIntercept: true。
排查与修复:
进入 知识库 → 词库(
/knowledge-base/lexicons),点开lex_support_stopwords右侧的 预览调试(Preview) 面板,输入刚才被拦截的提问,查看Matched Entries中具体命中了哪一条stop规则。最佳实践:将仅用于“检索前剥离口语废话”的词典(僅绑定在知识库
/knowledgebases/{id}/lexicons上)与用于“智能体对话入口合规/越狱阻断”的词典(绑定在智能体工作台/agent-runtime/project/lexicons且开启stopIntercept: true)拆分为两本独立词库,或者将工作台的stopIntercept设为false(仅剥离停止词而不中断对话)。
Q4:调用 PATCH /v1/agent-runtime/project/config 时只传了 {"model_parameters": {"temperature": 0.5}},为什么之前设置的 top_p 变成了默认值?
原因与排查步骤: PATCH /config 对顶层字段(如 system_prompt、max_steps、model_parameters)执行局部保留更新,但对嵌套的 model_parameters 对象采用整体替换(Replace)而非逐键合并(Deep Merge)。因此更新采样参数时,请始终同时传入完整的 {"temperature": 0.5, "top_p": 0.9}。