
指标监控与分析报表
功能概述
指标监控与分析报表(Metrics & Analytical Reports,控制台入口包括 智能体运维 → 指标;报表入口是否显示取决于部署配置)是 Agentbase 面向技术负责人、AI 架构师与运维团队提供的生产运营度量与 ROI 决策看板。在大模型应用规模化上线后,团队需要实时掌握系统的吞吐表现与财务健康度,回答三个核心问题:“花了多少 Token 与成本?”、“首字延迟(TTFT)与端到端延迟(P50/P95/P99)快不快?” 以及 “各智能体的回答质量与 Bad Case 归因分布如何?”
在 Agentbase 企业智能中台(69c6d1aa00062e6bb60)的标杆项目 企业智能客服与知识中台(enterprise-ai-hub-210)中,系统基于已采集的 Trace、Observation 与 Score 实时派生全维指标与三大专题分析报表(/v1/observability/reports/{overview|agents|quality}):
轨迹派生指标(Metrics):可按可用数据查看调用量、Token 消耗、延迟和成本等指标;Observations 视图支持
memoryOnly过滤 Memory 相关观测数据。可用指标取决于实际采集与部署配置;三大高阶分析报表(Reports,
v2.10.0):通过 Overview(全局总览)、Agents(智能体排行与 ROI) 与 Quality(质量分档与 Bad Case 归因) 三个页签,提供近 24 小时 / 7 天 / 30 天及自定义窗口(≤30 天)的快照与上一周期环比(Delta),支持按wasteReason(Token 浪费原因)、cache.status(缓存命中)和badCaseCategory(坏例归因)深度剖析优化空间。
核心概念与架构
Agentbase 的指标与报表引擎直接构建于底层分析型轨迹与评分存储之上,采用服务端 Bundle 合并查询与二阶段 Top-N 时序聚合架构,单页仅需一次 HTTP 请求即可完成多维指标渲染。
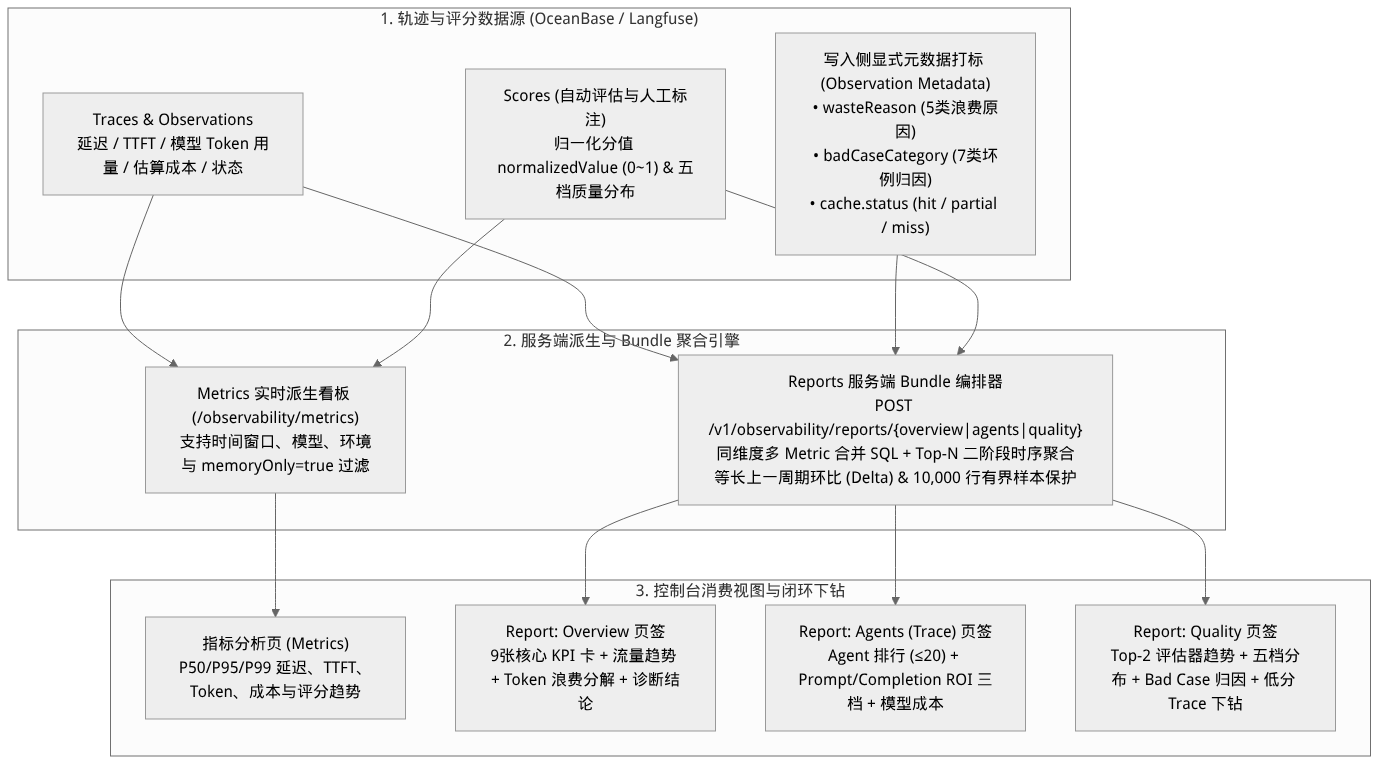
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
核心度量指标与计算口径表
| 指标分类 | 指标名称 | 计算口径与统计规则 |
|---|---|---|
| 吞吐与活跃度 | Trace 总量 / Observation 总量 / 活跃用户数 | 选定时间窗口内去重统计的端到端请求数、内部节点数及非空 userId(如 user_zhangwei_001)去重计数。 |
| Token 消耗 | Input (Prompt) / Output (Completion) / Total Tokens | 汇总所有 GENERATION 与 EMBEDDING 节点的真实供应商上报 Token。cached(缓存命中 Token)与 reasoning(思维链 Token)映射为互斥子桶,不重复累加进总计费 Token;缓存直接短路避免的调用记为 avoided call(新增消耗为 0)。 |
| 延迟分位值 | 端到端延迟与 TTFT(P50 / P95 / P99) | - 端到端延迟:Trace 或 Generation 从 startTime 到 endTime 的总耗时在窗口内的第 50、95、99 百分位值;- 首字延迟(TTFT, Time To First Token):流式大模型调用从发起请求到收到首个生成 Token( completionStartTime)的耗时分位值。 |
| 成本估算 | 模型总成本估算 / 单会话成本(Cost per Session) | 基于各 GENERATION 节点匹配的模型单价表(如 qwen-plus、qwen-vl-max)计算的估算金额(仅供研发运营方向性参考,实际财务结算以平台 限额与计量账单 为准)。 |
| 错误率与质量 | 错误率 / 综合质量分 / 评测覆盖率 | - 错误率:状态为 ERROR 的 Trace/Observation 占比(网关层严格区分 5xx 服务端故障、429 限流与普通 4xx 业务拒绝,不将普通 4xx 混入服务故障率);- 综合质量分:窗口内所有可归一化数值评分( normalizedValue)的算术均值(保留两位小数);- 评测覆盖率:已关联至少一条评估 Score 的 Trace 占总 Trace 数的百分比。 |
角色、入口与关联关系
控制台入口与 REST API 权限矩阵
指标监控页(Metrics):位于左侧导航栏 智能体运维(Observability / AgentOps) → 指标(Metrics)(路由:
/console/project-{region}-enterprise-ai-hub-210/observability/metrics)。分析报表页(Reports):入口和页面取决于部署的可见性配置。若报表被隐藏,直达链接也会重定向;需要使用时请确认部署配置和权限。
| 接口 / 页面 | HTTP 方法与路径 | 所需 API Key Scopes(用户会话/JWT 角色默认包含) |
|---|---|---|
| Metrics 指标查询 | /v1/observability/metrics(及控制台聚合查询) | observability.metrics.read |
| Overview 全局总览报表 | POST /v1/observability/reports/overview | observability.metrics.read |
| Agents 智能体排行报表 | POST /v1/observability/reports/agents | observability.metrics.read + observability.traces.read + observability.users.read + observability.sessions.read |
| Quality 质量与归因报表 | POST /v1/observability/reports/quality | observability.metrics.read + observability.traces.read + observability.scores.read |
功能详解与操作指南
1. 查看指标监控页(Metrics)与 memoryOnly 专属过滤
登录 Agentbase 控制台,进入项目
企业智能客服与知识中台(enterprise-ai-hub-210),单击左侧 智能体运维 → 指标(Metrics)。
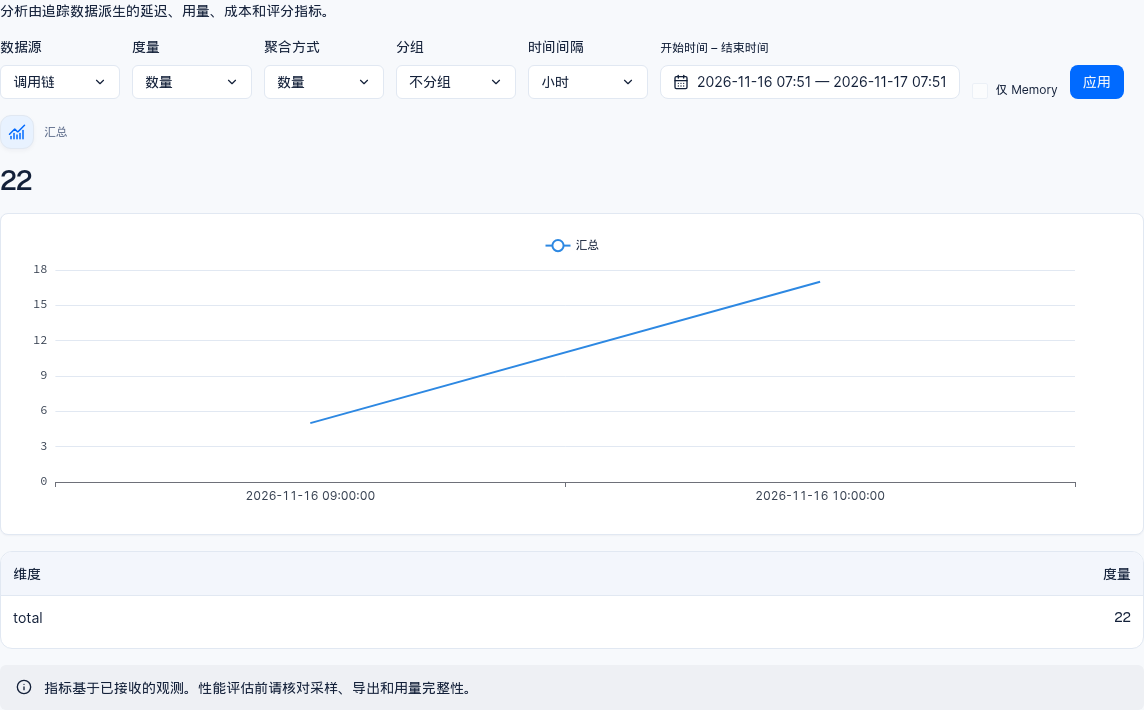
图:2.12.0 测试项目中的指标页面;具体内容因项目而异。
关键筛选与分析操作:
时间范围与环境筛选:选择统计时间段与目标环境(如
production);memoryOnly过滤:在 Observations 视图开启该选项,控制台查询会增加service=memory过滤条件,用于分析符合条件的观测数据。Traces 和 Scores 视图不提供此筛选,不能据此认为评分也已按 Memory 过滤;按模型拆分用量与成本:在模型明细表中对比
qwen-plus、qwen-turbo、text-embedding-v3、qwen3.7-text-rerank与qwen-vl-max的调用次数、Prompt/Completion Token 占比与估算成本。
2. 使用三大分析报表(/v1/observability/reports)洞察全局与 ROI
在报表页面可用时,或通过获授权的接口调用 POST /v1/observability/reports/{overview|agents|quality} 时,查询共享统一的时间范围契约:
预设时间窗口(
range):支持"24h"(近 24 小时)、"7d"(近 7 天,默认)、"30d"(近 30 天);自定义时间窗口(
from+to):支持成对传入 ISO-8601 起止时间,最大跨度不得超过 30 个自然日(30 × 24h),且必须满足from < to(非法窗口直接返回 400 参数错误,不静默降级为空数据);自动等长环比(Delta):系统自动计算紧邻的前一个等长周期(
previousFrom~previousTo)的环比涨跌;跨度≤ 24h时趋势图按小时(hour)聚合,否则按天(day)聚合。
(1)Overview(全局总览页签)
顶部 9 张核心 KPI 卡(含环比 Delta):
Traces 总数、活跃用户数、Tokens 总量、成本(估算)、P95 延迟、错误率、综合质量分、评测覆盖率、单会话成本。趋势与分解面板:
流量趋势:按调用量排名前五的 Agent 分组展示 Trace 数量时序折线;
延迟与质量双轴趋势:左轴展示 P95 延迟(ms),右轴对照展示综合质量分(
0~1);Token 浪费分解(按
wasteReason)、Top 5 Agents / Top 5 Models、归一化五档质量分布(Excellent / Good / Average / Poor / Very Poor);自然语言诊断结论:规则引擎根据阈值自动生成可读诊断提示(如指出本周重试浪费占比或 P95 延迟超标情况)。
(2)Agents(智能体排行与 ROI 页签,Console 页签展示为 Trace)
Agent 排行表(Top 20):列出调用量最高的 20 个 Agent,展示调用量、P95 延迟、平均质量分、低分占比、健康状态徽标(
正常/预警/异常)及诊断提示(如Prompt 偏重、较慢)。单击 Agent 名称可直接带过滤条件跳转至 Trace 列表。Prompt / Completion Token ROI 三档分析:按输入 Prompt Token 与输出 Completion Token 的比值,将 Agent 自动划分为 高效(High ROI)、均衡(Balanced)、低效(Low ROI) 三档,快速识别系统提示词或检索上下文注入过重但有效输出极短的 Agent。
步骤(工具调用)与模型成本明细、Top 活跃用户 / 会话 / 最近 Trace 列表(最近 Trace 列表实时附带单条 Trace 的真实
latencyMs与observationCount)。
(3)Quality(质量趋势与 Bad Case 归因页签)
质量 KPI 与 Top-2 评估器趋势:展示综合质量分、命中次数最多的前两个评估器(Top 2 Evaluators)的平均分趋势及 P95 延迟。
Bad Case 归因面板(按
badCaseCategory)、低分 Trace 列表(落在poor/very-poor档,支持一键下钻详情) 以及 评估器覆盖率对比。10,000 行有界样本保护机制: 为保障大流量项目下的查询响应速度,Quality 低分列表与 Agents 最近 Trace 列表在同一窗口内最多读取按时间倒序的最新 10,000 行记录。当窗口内候选评分超过 10,000 条时,接口返回
lowScoresLimited: true、insightsLimited: true、facetsLimited: true(Overview 对应返回scoreInsightsLimited: true),控制台会自动显示 “结果为有界样本” 提示并隐藏样本当前均分与全窗口上期均分的跨口径环比,引导用户缩小时间窗口查看完整全量明细。
3. 写入侧显式元数据打标规范(wasteReason、badCaseCategory、cache)
报表中的 Token 浪费分解、缓存命中率 与 Bad Case 归因 面板严格基于写入侧在 Observation.metadata 中显式打标的字段聚合(未打标的正常数据不会混入“未知浪费”桶):
| 元数据字段路径 | 允许的标准枚举值 | 枚举语义与改进方向指导 |
|---|---|---|
metadata.wasteReason | retry、truncation、cache_miss_repeat、context_overflow、user_abort | 分别标识因报错重试、输出长度截断重跑、相同前缀缓存未命中、上下文超限丢弃及用户中途取消导致的无效 Token 消耗。缺失该字段代表正常有效消耗。 |
metadata.badCaseCategory | grounding_missing、hallucination、instruction_violation、tool_failure、query_understanding、safety_refusal、latency_timeout | 七个互斥的坏例归因桶:如 grounding_missing 指向优化知识库召回,tool_failure 指向修复工具 Schema 或下游接口。 |
metadata.cache.status | hit、partial、miss | 调用方上报的缓存状态;字段是否存在及其含义取决于具体数据来源。 |
4. 调用分析报表 Bundle API 示例
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
  : "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the target API endpoint including /v1}"
  APPBASE_ENDPOINT="${APPBASE_ENDPOINT%/}"
  : "${APPBASE_PROJECT_ID:?Set APPBASE_PROJECT_ID for the target environment}"
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY for the target environment}"

  # 1. 查询近 7 天 (7d) 的 Overview 全局总览报表
  builtin printf 'X-Appwrite-Key: %s\n' "${APPBASE_API_KEY:?Set APPBASE_API_KEY}" | curl --disable --header @- -fsS -X POST "${APPBASE_ENDPOINT}/observability/reports/overview" \
    -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
    -H "Content-Type: application/json" \
    --data '{
      "range": "7d"
    }' | jq .

  # 2. 使用自定义时间窗口 (from/to, 跨度 <= 30 天) 查询 Quality 质量与 Bad Case 归因报表
  builtin printf 'X-Appwrite-Key: %s\n' "${APPBASE_API_KEY:?Set APPBASE_API_KEY}" | curl --disable --header @- -fsS -X POST "${APPBASE_ENDPOINT}/observability/reports/quality" \
    -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
    -H "Content-Type: application/json" \
    --data '{
      "from": "2026-10-01T00:00:00.000Z",
      "to": "2026-10-22T23:59:59.999Z"
    }' | jq .
)
查询指标
在项目侧栏 Observability / AgentOps → Metrics 打开指标页。
选择数据视图、指标、聚合方式、分组维度、时间粒度和起止时间,再点击 应用。默认查询最近 24 小时,时间粒度默认为 Hour;可选粒度为 Minute、Hour、Day、Week。
查看汇总值、时间序列图和维度拆分表。选择分组后,可比较不同维度的变化;需要查看某条 Trace 的输入输出或具体阶段时,回到轨迹检查明细。
可选指标和分组取决于数据视图:
| 数据视图 | 指标 | 可选分组 |
|---|---|---|
| Traces | 数量、延迟、Token 用量、成本 | 不分组、Trace 名称、Environment |
| Observations | 数量、延迟、Token 用量、成本 | 不分组、模型、Trace 名称、Environment、阶段、用途、结果、用量完整性 |
| Scores | 数量、评分 | 不分组、评分名称、Trace 名称、Environment |
聚合选项会按所选指标调整:数量使用 Count;延迟支持 Count、Average、P50、P95;Token 用量和成本支持 Sum、Average;评分支持 Count、Average。请先选数据视图和指标,再选择页面提供的聚合选项。
Memory only 仅在 Observations 视图中可用,用于筛选 Memory 相关 Observation。部分控制台版本在 Traces 与 Scores 视图中也显示该选项,但处于禁用状态;它不表示评分也已按 Memory 过滤。
没有指标数据时
若图表显示 暂无指标数据,先检查起止时间是否覆盖数据产生时段,再确认数据视图、指标和分组是否匹配;使用 Memory only 时,也确认查询目标是 Observations。更改条件后重新点击 应用。页面的刷新按钮会重新请求当前指标查询。
若调整条件后仍无数据,核对当前项目是否已写入对应类型的 Trace、Observation 或 Score,并检查 Trace 的时间和用量记录。空结果只代表当前查询未返回数据,不能据此得出“无调用”“零成本”或“质量为零”的结论。
常见问题与排障
1. 为什么在报表(Reports)页面中,总调用量与 Token 都有数据,但“Token 浪费”或“Bad Case 归因”面板显示为空?
原因分析:这并非报表查询故障。
Token 浪费、缓存命中与Bad Case 归因依赖写入侧在Observation.metadata中显式写入wasteReason、cache.status和badCaseCategory字段。如果当前项目的上报链路尚未注入这三个元数据标签,系统不会把未打标的正常调用强行归入“未分类浪费”,而是展示空面板并提示尚未建立打标覆盖。解决措施:参考上文“写入侧显式元数据打标规范”,在应用或网关上报
generation-create事件时按规范补充metadata.wasteReason、metadata.cache与metadata.badCaseCategory字段,新写入的数据即可实时进入分解面板。
2. 为什么自定义报表时间范围时点击“应用”报错或被禁用?
原因分析:分析报表(Reports)对自定义时间窗口(
from/to)实施三层一致校验(Console 前端、PHP 网关与底层分析引擎):① 自定义时间跨度严禁超过 30 个自然日(30 × 24h);② 开始时间from必须严格早于结束时间to(不允许起止相等或倒序)。解决措施:请将单次查询的自定义起止时间跨度控制在 30 天以内;若需对比更早的历史周期,可分多个 30 天窗口分别拉取快照。
3. Metrics 与 Reports 中显示的模型成本(Cost)与组织账单中的实际扣费完全一致吗?
原因分析:Metrics 和 Reports 中的成本数值是基于 Trace 中
GENERATION节点记录的模型名称和 Token 数量乘以参考单价得出的实时估算值,旨在帮助研发团队直观对比不同 Agent 或模型选型的相对成本效率(ROI)。而实际计费还会受到上游供应商阶梯折扣、包月资源包抵扣或未采样 Trace 的影响。解决措施:请将可观测看板中的成本作为工程优化与 ROI 评估参考;财务对账与配额核对请前往项目的 限额、配额与用量计量 页面查看权威计量聚合。