
评测数据集管理与基准测试
功能概述
评测数据集(Evaluation Datasets,控制台入口为 智能体运维 → 数据集)用于整理智能体回归测试用例和参考答案,辅助比较模型、提示词或检索配置调整前后的结果。可根据业务需要记录输入(input)和参考输出(expectedOutput)。
下文使用虚构项目 enterprise-ai-hub-210 和数据集 enterprise-support-golden-v1 说明操作;请替换为自己的项目、数据集和测试用例。
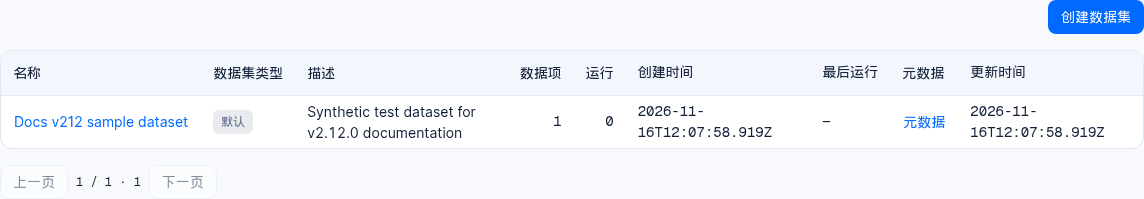
图:测试项目中包含一条合成数据的数据集;实际内容取决于项目数据和当前权限。
核心概念与架构
数据集引擎通过将静态测试条目(Dataset Items)与动态执行轨迹(Traces / Observations)绑定为不可变的运行记录(Dataset Runs),并与自动化评估器(Evaluations)无缝联动,构建可重复对比的基准评测流水线。
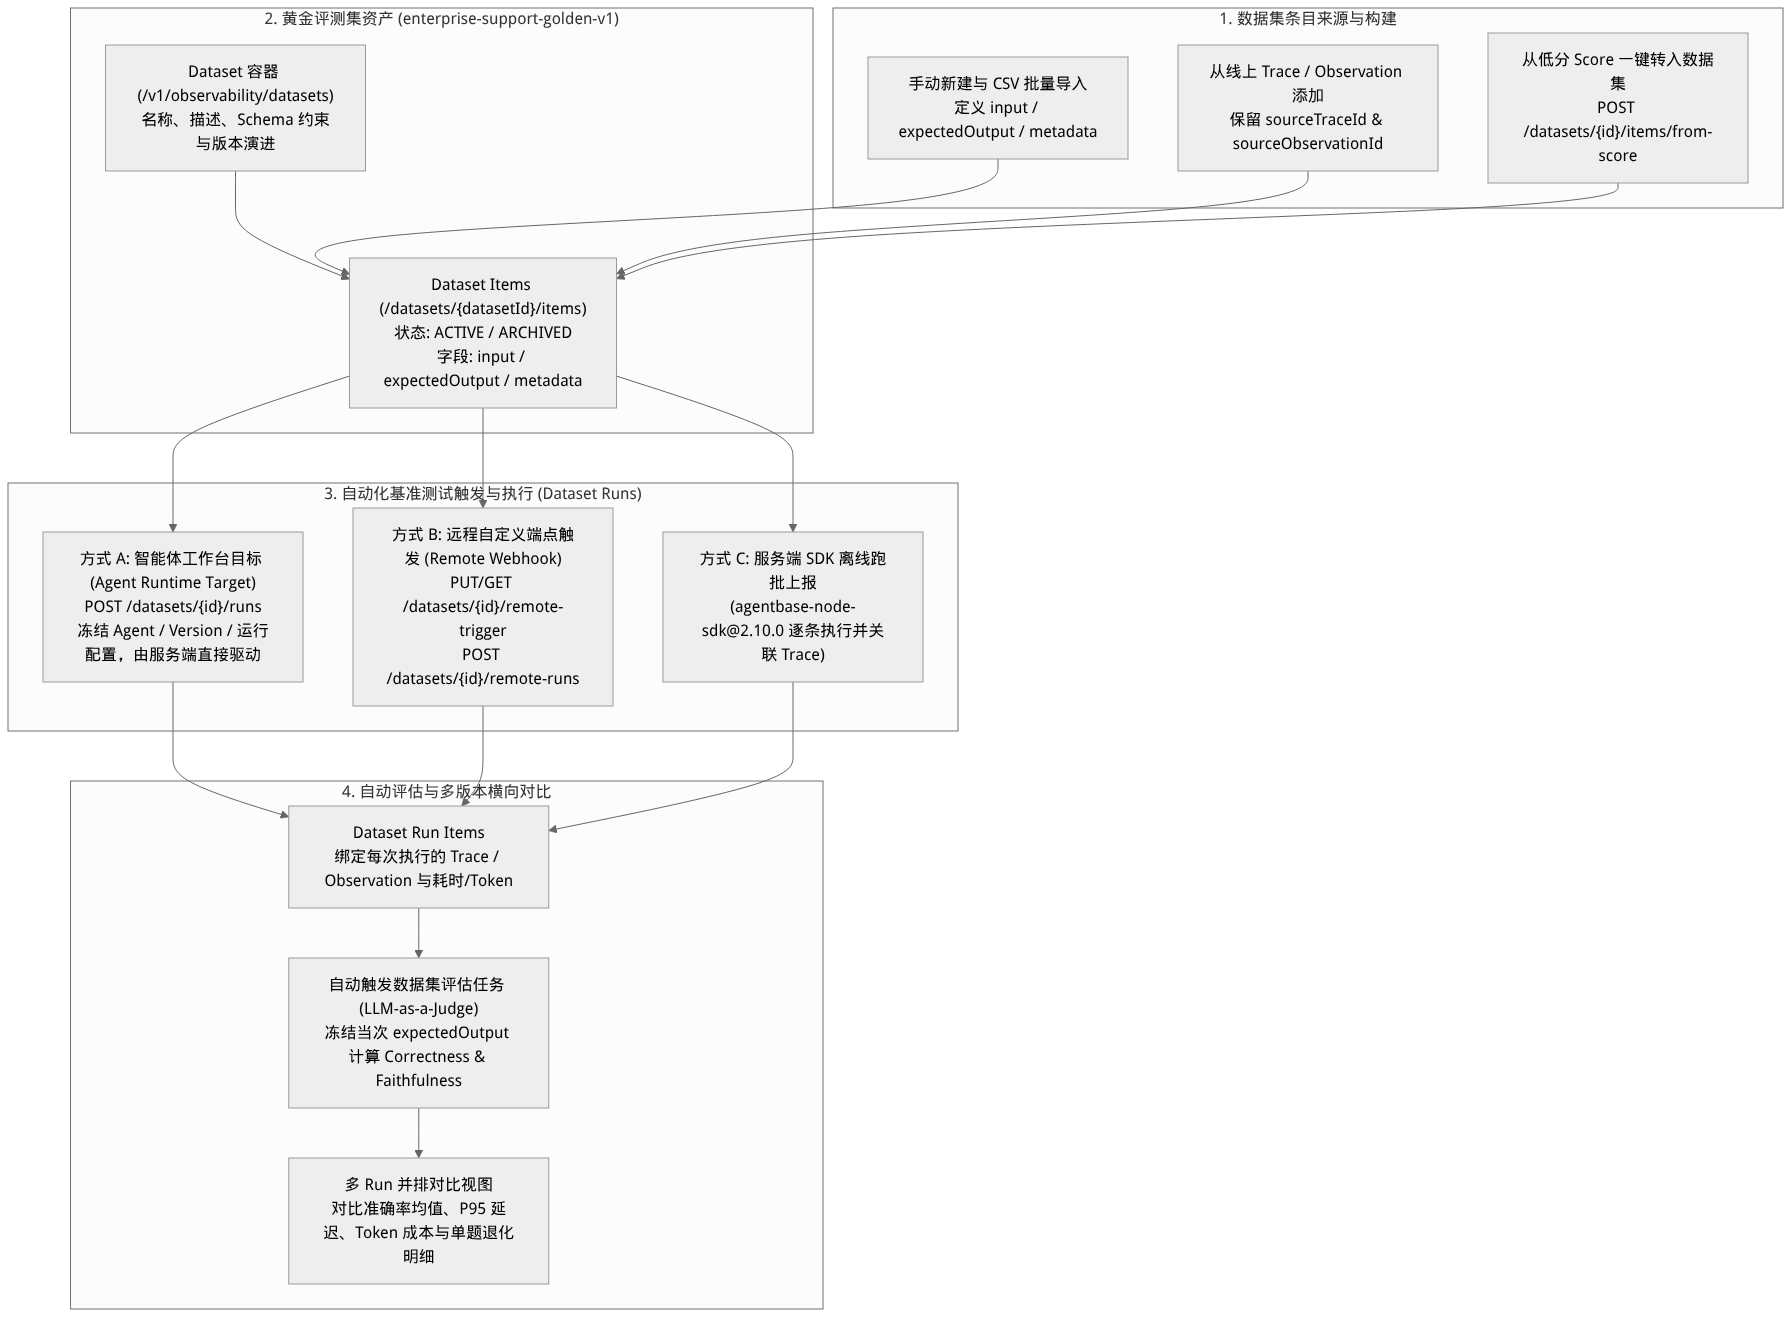
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
数据集核心实体与字段定义表
| 核心实体 | 关键字段 | 类型与约束 | 业务含义与评测作用 |
|---|---|---|---|
| Dataset(数据集) | namedescriptionmetadatainputSchemaexpectedOutputSchema | string(必填,项目内唯一,如 enterprise-support-golden-v1)string / object可选 JSON Schema | 组织同类评测用例的逻辑容器。支持可选配置 inputSchema 与 expectedOutputSchema 对新增条目执行结构化 JSON Schema 校验。 |
| Dataset Item(数据集条目) | idinputexpectedOutputmetadatasourceTraceIdsourceObservationIdstatus | input:必填(JSON 或文本)expectedOutput:可选标准答案status:ACTIVE(默认)或 ARCHIVED | 单道基准测试题。当 status 设为 ARCHIVED 时,该条目保留历史关联记录但不再参与后续新建的基准运行(Dataset Run)。 |
| Dataset Run(数据集运行) | runId / namedescriptionmetadata | 绑定特定测试配置快照(如 qwen-plus-v1 vs qwen-turbo-v1) | 针对同一数据集发起的一次完整回归测试批次。当以 Agent Runtime 为目标时,自动冻结当时的 Agent 版本、模型参数与知识库配置。 |
| Dataset Run Item(运行明细项) | datasetItemIdtraceIdobservationId | 关联单道题目与当次实际生成的 Trace / Observation | 将静态题目(含 expectedOutput)与当次动态推理结果(output、延迟、Token、成本)及自动评估产出的 Score 精确铆接。 |
角色、入口与关联关系
控制台入口与 REST API 权限矩阵
控制台入口位于:项目 → 智能体运维 → 数据集(路由:/console/project-{region}-{projectId}/observability/datasets)。
| 操作功能 | 控制台入口 | REST API 端点 | 所需权限 Scope |
|---|---|---|---|
| 查询与创建数据集 | 数据集列表页 → 创建数据集 | GET/POST /v1/observability/datasets、GET .../:datasetId | observability.datasets.read / write |
| 管理数据集条目与 CSV 导入 | 数据集详情 → Items 页签 / 导入 CSV | GET/POST /v1/observability/datasets/:datasetId/items、PATCH/DELETE .../:itemId | observability.datasets.read / write |
| 从低分 Score 批量转入数据集 | 评分列表/详情 → 添加到数据集 | POST /v1/observability/datasets/items/from-score/preview、POST /v1/observability/datasets/:datasetId/items/from-score | observability.datasets.write |
| 触发数据集运行(含 Agent Workbench 目标) | 数据集详情 → Runs → 新建运行 | GET/POST /v1/observability/datasets/:datasetId/runs、GET .../runs/:runId/items | GET:observability.datasets.read写入: observability.datasets.write |
| 配置与触发远程自定义端点运行 | 数据集详情 → 远程运行配置(Remote Trigger) | GET/PUT/DELETE /v1/observability/datasets/:datasetId/remote-trigger、POST .../remote-runs | GET:observability.datasets.read写入: observability.datasets.write |
上述数据集接口要求有效的用户身份(例如已登录用户会话或用户 JWT);仅配置 API Key scope 不代表满足身份检查。若先在控制台浏览评分,还需具备评分读取权限。
与其他模块的协同关系
与链路追踪(Traces)和评分(Scores)的双向回流: 在线上运维发现典型 Bad Case(如某次工单问答出现幻觉或检索遗漏)时,运维人员可直接在该 Trace、Observation 或低分 Score 页面单击 添加到数据集,一键将线上真实输入(
input)、模型输出及sourceTraceId/sourceObservationId沉淀进enterprise-support-golden-v1,防止同类问题在后续迭代中复发。与评估(Evaluations)及根因分析(RCA)的签名冻结联动: 只有绑定了数据集标准答案(
expectedOutput)的运行,才能启用 RAG 四阶段评测中的 答案准确性(Accuracy / Correctness) 评估。评估执行时,系统会使用独立域 HMAC 签名将当次问题、参考答案(expectedOutput)、Trace 与 RAG 检索指纹冻结在datasetEvidence中——后续即使有人修改了数据集条目的当前标准答案,历史评分的根因分析(RCA)依然严格核验当次冻结快照,不会产生错误归因。
功能详解与操作指南
1. 创建黄金数据集 enterprise-support-golden-v1 并录入条目
登录 Agentbase 控制台,进入项目
企业智能客服与知识中台(enterprise-ai-hub-210),打开 智能体运维 → 数据集(Datasets)。单击右上角 创建数据集,填写名称
enterprise-support-golden-v1与描述"企业智能客服与技术支持黄金基准集(覆盖 OceanBase 排障、AI 网关限流与 SOP 问答)",单击保存。录入数据集条目的三种方式:
方式一:手动创建或 CSV 批量导入:在数据集详情页单击 新建条目 或 导入 CSV,将包含
input(用户工单问题)、expectedOutput(标准排障步骤与答案)和metadata(如{"ticketCategory": "oceanbase-vector", "difficulty": "hard"})的表格批量导入;方式二:从线上 Trace / Observation 转化:在 智能体运维 → 链路(Traces) 详情页选中某条典型链路或
GENERATION节点,单击 添加到数据集,选择enterprise-support-golden-v1,经人工润色修正expectedOutput后保存,系统自动记录sourceTraceId与sourceObservationId;方式三:从低分 Score 批量转化(
from-score):在评分页筛选出低分记录,先调用/items/from-score/preview预览去重情况,再调用/items/from-score批量转入数据集。
下面的接口示例使用具有项目访问权限的用户短期 JWT;该 JWT 可由已登录客户端签发。示例不绑定来源链路;如需关联,请提供同一项目中真实存在且彼此匹配的 Trace 和 Observation ID。
先创建数据集。确认 HTTP 状态为 2xx 后,从响应中取得数据集 ID,再设置 DATASET_ID 并单独执行添加条目。通过安全方式在当前 Shell 设置短期 APPBASE_USER_JWT,不要将令牌写入命令历史。
(
  set +x
  set -o pipefail
  : "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT}" "${APPBASE_PROJECT_ID:?Set APPBASE_PROJECT_ID}" "${APPBASE_USER_JWT:?Set APPBASE_USER_JWT}"
  builtin printf 'X-Appwrite-JWT: %s\n' "$APPBASE_USER_JWT" | curl --disable --header @- -fsS -i -X POST "${APPBASE_ENDPOINT%/}/observability/datasets" \
    -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
    -H "Content-Type: application/json" \
    --data '{
    "dataset": {
      "name": "enterprise-support-golden-v1",
      "description": "企业智能客服与知识中台黄金评测基准集 (v2.10.0)",
      "metadata": {
        "owner": "enterprise-ai-hub-team",
        "knowledgeBaseId": "kb_enterprise_support"
      }
    }
  }'
)
确认创建成功后添加条目:
(
  set +x
  set -o pipefail
  : "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT}" "${APPBASE_PROJECT_ID:?Set APPBASE_PROJECT_ID}" "${APPBASE_USER_JWT:?Set APPBASE_USER_JWT}"
  : "${DATASET_ID:?Set DATASET_ID from the successful create response}"
  builtin printf 'X-Appwrite-JWT: %s\n' "$APPBASE_USER_JWT" | curl --disable --header @- -fsS -i -X POST "${APPBASE_ENDPOINT%/}/observability/datasets/${DATASET_ID}/items" \
    -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
    -H "Content-Type: application/json" \
    --data '{
    "item": {
      "input": {
        "question": "OceanBase Shared V2 项目在构建 1024 维 HNSW 向量索引时报错 -4013 (OB_ALLOCATE_MEMORY_FAILED),应该如何排查和修复?",
        "userId": "user_zhangwei_001"
      },
      "expectedOutput": {
        "answer": "请结合当前数据库版本、错误日志与资源指标定位原因,并依据对应版本的官方文档评估处理方案。"
      },
      "metadata": {
        "ticketId": "TK-20261022-001",
        "domain": "oceanbase-vector-index",
        "sla": "P0"
      }
    }
  }'
)
2. 触发自动化基准测试(Agent Runtime Workbench vs 自定义远程端点 vs SDK)
当数据集 enterprise-support-golden-v1 准备就绪后,可以选择适合的运行类型;下表列出部分接入方式。
新版控制台的运行类型还包括提示词、智能体、记忆和 RAG;记忆与 RAG 选项是否可用取决于数据集类型。提示词、记忆和 RAG 模式使用数据集运行接口,智能体目标使用远程运行接口。
| 运行模式 | 触发入口 / 接口 | 执行原理与核心优势 | 适用场景 |
|---|---|---|---|
| 模式 A:智能体工作台目标 | 控制台 数据集 → 新建运行 → 智能体,选择项目工作台 | 控制台先保存该数据集的远程触发器,再提交 POST /v1/observability/datasets/:datasetId/remote-runs;运行结果以实际状态和明细为准。 | 对项目工作台发起数据集评测。 |
| 模式 B:自定义远程端点(Remote Webhook) | 控制台 配置远程触发器(PUT .../remote-trigger)并单击 触发远程运行(POST .../remote-runs) | 配置远程地址和可选的非秘密参数后,平台将数据集条目发送给端点;普通 Webhook 不支持在此配置认证头,端点需自行上报运行条目,成功响应不会自动登记结果或关联 Trace。 | 业务智能体部署在自建微服务或 Functions 函数中,希望由控制台一键触发回归测试。 |
| 模式 C:服务端 SDK 编程式跑批 | 使用 agentbase-node-sdk@2.12.0 在 CI/CD 流水线中拉取条目、调用模型并上报关联结果 | 在本地或 CI 脚本中完全自主控制并发度、前置数据准备与多步编排,通过 POST /v1/observability/datasets/:datasetId/runs 记录对比批次。 | 集成到 Git 提交或每日定时构建(Nightly Build)的自动化质量门禁。 |
选择智能体目标会更新该数据集现有的远程触发器配置;如果选择 AI Gateway 的 HTTP 智能体,控制台还可能创建用于该目标的网关密钥。提交前检查现有配置与权限。运行受理不代表评测完成,应在运行明细中检查最终状态。
3. 在 Runs 视图横向对比多版本表现与下钻单题退化
进入数据集
enterprise-support-golden-v1的 Runs(运行记录) 页签。勾选两次或多次不同的运行批次(例如
benchmark-qwen-turbo-baseline与benchmark-qwen-plus-graphrag-v210),进入并排对比视图:全局聚合指标对比:直观对比各批次在正确性(Correctness)、忠实度(Faithfulness)、上下文相关性(Context Relevance)等评估器上的平均得分、P50/P95 响应延迟、平均 Token 消耗与单次运行总成本估算;
逐题(Item-by-Item)下钻对比:表格逐行展示同一道
datasetItem在不同 Run 中的实际输出(Output)、得分差异与状态。对于得分下降的退化用例,单击关联的 Trace 链接即可直接进入 Trace 详情与根因分析 定位原因。
入口与创建
在项目侧栏打开 Observability / AgentOps,进入 Assets / Data → Datasets。如果看不到该分区,请先确认当前实例已启用可观测能力,详见可观测总览。
单击 Create dataset,填写名称;描述和元数据可选。
选择用例类型:Default、Good 或 Bad。需要填写元数据时使用 JSON 对象格式。
保存后会进入数据集详情页,可在 Items 中维护测试用例,在 Runs 中查看运行记录,在 报表 中比较运行结果。
添加测试用例
每条用例都需要输入和预期输出。可以手工创建,也可以导入 CSV;编辑用例时还可关联已有 Trace,并按需选择其中的 Observation,便于从实际请求整理回归样本。
从 CSV 导入
选择 导入 CSV 上传带表头的 UTF-8 .csv 文件后,先检查列映射和预览,再开始导入。至少需要把一列映射为 输入,一列映射为 Expected output;其余列可映射为 Metadata 或忽略。常见表头会自动匹配,仍应在预览中确认:
| CSV 表头示例 | 默认映射 |
|---|---|
input、question、query、prompt | Input |
expected_output、ground_truth、reference_answer | Expected output |
metadata、meta | Metadata |
| 其他列 | 忽略 |
例如,下面的两列 CSV 可以直接满足必需映射:
input,expected_output
"如何重置密码?","在登录页选择忘记密码,并按页面提示完成操作。"
单个文件最大 10 MiB,最多 1,000 条数据行、100 列。空文件、空表头、重复表头、格式错误或超出限制时,先修正 CSV 再重新上传。若个别数据行写入失败,导入结果会保留成功/失败数量和失败行号及原因;重试前先筛出失败行,整份文件重新导入可能造成已成功记录重复。不要仅凭“导入完成”判断所有记录均已成功。
从 Trace 整理用例
在新增或编辑条目的来源选择器中搜索并选择 Trace;如果需要定位具体步骤,再选择该 Trace 中的 Observation。保存后,条目保留来源关联,可从用例继续回到相应轨迹检查上下文。若更换 Trace,需重新确认 Observation 选择。
运行与查看结果
在数据集详情页创建 Run,填写运行名称并选择执行方式:
| 执行方式 | 运行前检查 |
|---|---|
| Prompt | 先选择评估模板、Prompt/版本和 LLM 连接,再填写模型及模型参数 JSON;页面会提示缺少的必需配置。 |
| Agent | 选择项目 Draft Agent 或 AI Gateway 上的外部 Agent 目标;如果列表为空,先确认项目中已有可用目标。 |
运行后在 Runs 查看状态和记录。打开单条运行详情,可逐项对照输入、预期输出、实际输出和评分;页面也会展示可用的 Trace、延迟、成本及失败信息。报表 可按不同 Run 对比平均延迟、平均成本和评分。运行或评分仍在处理中、评分为空、或某条用例失败时,先查看对应状态、错误和 Trace;空评分不代表评分为零,也不代表用例通过。
数据集运行依赖当前项目可用的 Prompt、模型连接或 Agent 执行目标,以及配置的评估器。评估配置和结果解释见评估与评分;指标来源和轨迹派生信号见指标分析。
检验知识库问答时,保持问题和参考答案固定,选择能产生真实检索证据的 Agent,再组合查询质量、上下文相关性、回答忠实性和答案准确性模板。完整步骤与提交异常处理见用数据集评估 RAG 回答。实际回答不能代替参考答案,缺失评分不能作为通过依据。
常见问题与排障
1. 为什么在数据集评估中选择“答案准确性(Accuracy / Correctness)”模板时,部分条目没有产出评分?
原因分析:答案准确性(Correctness)评估强依赖数据集条目中存在非空的有效参考标准答案(
expectedOutput)。如果某条 Dataset Item 在创建或从 Trace 导入时只填写了input,而expectedOutput为空或缺失,评估引擎会拒绝向 Judge 模型提交空标准答案,从而跳过该条目的准确性打分。解决措施:在数据集 Items 页签中检查未产出分数的条目,补充完善的
expectedOutput标准答案后,重新触发一次 Dataset Run。
2. 修改了某道题目的 expectedOutput 标准答案后,之前已经跑完的历史 Dataset Run 的评分和根因分析会自动改变吗?
原因分析:不能假设所有数据集评估都保存了完整的
input和expectedOutput签名快照。满足受管 RAG 评估绑定且目标为数据集时,系统会冻结签名的datasetEvidence,其中包含问题和证据指纹;仅答案准确性阶段包含提取后的参考答案及其指纹。其他评估的历史证据和重分析行为应以实际运行记录为准。解决措施:保留原始条目与历史 Run 的相关记录;修正标准答案后,新建 Dataset Run 获取新的结果,并核对所用评估类型和实际证据。
3. 如何暂时屏蔽数据集中某些不再适用的旧题目,但保留它们在历史 Run 中的对比记录?
原因分析:如果直接物理删除(
DELETE)某条 Dataset Item,会导致历史 Run 中缺少该题目的题干对照。解决措施:不要直接删除该条目,而是编辑该条目(
PATCH /v1/observability/datasets/:datasetId/items/:itemId)将其状态从ACTIVE切换为ARCHIVED(已归档)。归档后的条目不会进入后续新触发的基准测试运行,但在历史 Run 详情页中依然完整保留可查。
相关文档
Memory / RAG 运行与集合根因
数据集运行可选择 Memory 或 RAG。RAG 必须选择知识库的 READY 版本,固定该版本检索并生成回答,不支持仅检索;Memory 显式开启生成回答时真实调用来源 Observation 的模型,关闭时只检索,省略时为快照。两者不接受统一执行模型设置。快照不执行、不产生调用费用,也不接受 idempotencyKey;真实执行进入队列,创建运行专属 Trace 后查看结果。Memory 指定其他用户需要团队 owner,不能凭界面选项绕过权限。
在 已创建的数据集 → 集合根因 中点击新建分析,选择一次运行并查看该运行的 Trace 比较。运行 Tab 可打开最近一次分析;相同集合已有完成结果时,重跑需确认并新增历史,详情加载失败时只重试读取。分析要求 2–100 条不同 Trace、最多 500 条评分,并至少两条 Trace 已有可用根因分析;只读权限除 scores.read 与 traces.read 外还需 datasets.read。
从分析洞察添加样本时必须是同类型、同一可信应用来源,并同时检查既有样本。无法确认或混合来源会拒绝导入。详情区区分 Trace 覆盖、实际使用评分数及失败/不可读结果;高于阈值而没有自动分析的评分不能写成当前故障,旧历史也不会自动补跑。