
知识库总览
知识库 是 Agentbase 面向企业非结构化与半结构化知识资产打造的全链路检索增强生成(RAG)引擎。通过控制台左侧导航栏的 知识库 入口,企业可将 Markdown、PDF、Office 文档、Excel 表格及语雀(Yuque)外部空间数据统一摄取入库,结合 词库(Lexicon) 同义词与停用词治理、多路混合检索(searchMode=hybrid)、语义重排、高级派生索引(GraphRAG、RAPTOR、LLM Wiki)以及不可变版本管理,为 智能体工作台(Agent Runtime) 与业务应用提供高准确率、可溯源的企业知识底座。
功能概述与核心场景
在企业智能客服与技术支持场景(如项目 企业智能客服与知识中台,ID:enterprise-ai-hub-210)中,传统单路向量检索往往面临专有名词漏召回、跨章节全局问题难以汇总、知识更新引发线上抖动等挑战。Agentbase 知识库提供端到端闭环能力:
多模态富文档异步摄取与精准分块:
支持本地批量上传、Storage 存储桶(如
kb_enterprise_docs)文件绑定及语雀(Yuque)数据源增量同步。内置
text、vlm(视觉大模型解析)、mineru(复杂 PDF 版面/公式/表格还原)三类文档解析器,以及general、title、smart、regex、faq五类分块策略。文档摄取采用异步任务机制:触发摄取接口返回 HTTP
202状态码,可分别查询摄取任务与文档详情;确认两者状态均为ready,且文档的activeGeneration与任务的generation一致后再检索。
项目级词库(Lexicon)协同治理:
支持创建同义词、扩展词与停止词词库,分别绑定到知识库和智能体。启用知识库绑定可用于查询改写;停止词拦截需在智能体侧启用绑定并配置拦截策略,直接知识库检索不会拦截停止词。
多路混合检索与韧性重排:
支持
hybrid(混合检索)、vector(向量检索)与fulltext(全文检索)三种searchMode,可通过vectorWeight精细调节向量与全文得分融合比例。可选启用重排;显式
rerankModel或rerankProviderRef调用失败时返回错误,均未指定的自动重排失败可回退并返回reranked: false。单库allowDegraded控制增强索引的可降级错误;answer=true使用检索证据合成答案,读者仍需核对来源。
三大高级派生索引(GraphRAG / RAPTOR / Wiki):
基于已就绪(
ready)的文档分块自动构建实体关系知识图谱(GraphRAG)、层次化递归聚类摘要树(RAPTOR)以及结构化百科页面(Wiki,如自动编译生成 10 篇技术支持百科页面)。
不可变版本发布与智能体工作台联动:
支持草稿工作副本(Draft)、就绪门禁校验(Readiness Gate)、封存(Seal)、发布(Publish)与一键回滚(Rollback),并在 智能体工作台(Agent Runtime) 中直接挂载知识库与词库开展多轮交互问答。
核心概念与架构
核心概念与术语说明表
| 核心概念 | 关键字段 / 接口标识 | 详细说明 |
|---|---|---|
| 知识库实例 | knowledgeBaseId | 知识文档、分块、向量索引、派生图谱与版本快照的顶层容器(如 kb_enterprise_support)。创建时绑定向量模型(text-embedding-v3,1024 维)。 |
| 异步摄取作业 | ingestionId / HTTP 202 | 发起摄取或触发重建后生成的异步摄取流水线记录。摄取接口返回 202 Accepted,后台经历解析、分块、图片理解与向量化,最终将文档状态置为 ready。 |
| 文档定位标识 | documentTag / subProductId | v2.10.0 引入的精准过滤元数据。documentTag 支持自由格式和结构化定位值,以及多个标签的分段筛选;可用于文档列表、检索与 Wiki 冲突列表。 |
| 词库(Lexicon) | lexiconId | 项目级词汇治理组件,支持同义词(synonym)、扩展词(expansion)与停用词(stop)。可同时绑定至知识库与智能体工作台。 |
| 检索模式 | searchMode | 支持 hybrid(默认,向量 + 全文混合检索)、vector(纯语义向量检索)与 fulltext(关键词全文检索)。 |
| 混合向量权重 | vectorWeight | 在 searchMode=hybrid 下控制向量相似度得分与全文 BM25 得分的加权比例(取值范围 0.0~1.0,如 0.7 表示 70% 向量权重 + 30% 全文权重)。 |
| 增强检索降级 | allowDegraded | 单库默认 true;GraphRAG / RAPTOR / Wiki 遇到可降级错误时保留普通结果,并通过 capabilities / degradedCapabilities 记录。设为 false 时相关错误向调用方返回。 |
| 派生知识索引 | graphrag / raptor / wiki | 在基础 Chunk 向量索引之上构建的三类高阶索引能力,分别解决多跳实体关系推理、跨文档宏观总结与结构化百科沉淀问题。 |
功能入口与权限矩阵
十子模块导航、REST API 与权限矩阵总表
| 子模块名称 | 手册专章链接 | 前端控制台路由路径 | 核心 REST API 端点 | Server SDK 方法(Node.js / Python) | 所需 RBAC 角色 / API Key Scope | 跨模块依赖关系 |
|---|---|---|---|---|---|---|
| 知识库总览与实例管理 | overview.md | /console/project-default-enterprise-ai-hub-210/knowledge-base | GET/POST /v1/knowledgebases | knowledgeBase.list() / create() | owner、admin、developer(只读成员仅查看)Scope: knowledgebases.read / write | 需要项目中可用的向量模型;具体模型和维度以实际配置为准 |
| 文档与异步摄取管理 | documents.md | /console/.../kb-kb_enterprise_support | POST /v1/knowledgebases/{kbId}/documentsGET .../documents/{docId}/ingestions/{ingestionId} | knowledgeBase.createDocument()getIngestion() | owner、admin、developerScope:GET knowledgebases.read;POST knowledgebases.write | 可使用知识库默认存储桶或指定有权访问的存储桶,并按需选择解析器 |
| 外部数据源与语雀同步 | datasources.md | /console/.../kb-kb_enterprise_support/datasources | POST .../yuque/personal-datasourcesPOST .../datasources/{id}/syncs | 个人数据源使用控制台或用户会话;团队同步见 SDK 参考 | 个人数据源需当前用户会话或 JWT;knowledgebases.write | 同步后自动触发摄取并标记派生索引为 stale (data_source_sync) |
| 高级知识索引构建治理 | indexing.md | /console/.../kb-kb_enterprise_support/indexes | GET .../index-capabilitiesPATCH .../index-capabilities/{cap}POST .../index-operations | knowledgeBase.updateIndexCapability()createIndexOperation() | owner、admin、developerScope:GET knowledgebases.read;PATCH/POST knowledgebases.write | 所需模型和构建条件以具体索引类型为准,参见索引构建指南 |
| 知识图谱可视化与社区报告 | graph.md | /console/.../kb-kb_enterprise_support/graph | GET .../graphGET .../graph/entities/{id}/neighborsGET .../graph/community-reports | knowledgeBase.getGraph()getGraphEntityNeighbors()listGraphCommunityReports() | owner、admin、developer、memberScope: knowledgebases.read | 依赖 GraphRAG 构建就绪;赋能 useKnowledgeGraph: true 多跳检索 |
| 知识库 Wiki 编译与治理 | wiki.md | /console/.../kb-kb_enterprise_support/wiki | GET/POST .../wiki/pagesGET .../wiki/conflictsPOST .../wiki/pages/{slug}/export-to-memory | knowledgeBase.listWikiPages()resolveWikiConflict()createWikiPageMemoryExport() | owner、admin、developerScope:GET knowledgebases.read;POST knowledgebases.write | 联动 版本管理(Versions) 封存门禁与 记忆(Memory) 导出 |
| 混合检索与问答调试 | search.md | /console/.../kb-kb_enterprise_support/search | POST /v1/knowledgebases/{kbId}/searchPOST /v1/knowledgebases/search | createSearch() / create_search()createMultiSearch() / create_multi_search() | owner、admin、developer、memberScope: knowledgebases.read | 按实际检索配置使用可选重排与回答生成能力 |
| 不可变版本管理与回滚 | versions.md | /console/.../kb-kb_enterprise_support/versions | POST .../version-adoptionsPOST .../versions/{id}/sealPOST .../publish & rollback | knowledgeBase.createVersion()sealVersion()publishVersion() | owner、admin(及授权发布人员)Scope: knowledgebases.write | 完整物化工作副本,隔离草稿(DRAFT)与线上激活版本(Current) |
| 项目级词库与多端绑定 | lexicons.md | /console/.../knowledge-base/lexicons/console/.../kb-kb_enterprise_support/lexicons | GET/POST /v1/lexiconsPUT .../{kbId}/lexicons | lexicons.create()lexicons.updateKnowledgeBaseBindings() | owner、admin、developerScope:GET lexicons.read;POST/PUT lexicons.write,还需目标知识库与词库的相应资源权限 | native-v1 分词器同时赋能检索改写、GraphRAG 消歧与智能体 stopIntercept |
| 知识库设置与多模态 VLM | settings.md | /console/.../kb-kb_enterprise_support/settings | PATCH /v1/knowledgebases/{kbId}POST /v1/knowledgebases/{kbId}/reindex | knowledgeBase.update()reindex() | owner、admin、developer(删除仅限 owner/admin)Scope: knowledgebases.write | 可配置图片理解(并发 1..8)与摄取追踪;启用图片理解需可用的视觉模型 |
与智能体工作台(Agent Runtime)的深度集成
在控制台左侧导航栏进入 智能体工作台(Agent Runtime),可通过项目级运行时配置(PATCH /v1/agent-runtime/project/config)将主对话模型设为 qwen-plus,直接挂载知识库 kb_enterprise_support 并绑定项目级词库 lex_enterprise_synonyms 与 lex_support_stopwords,立即在工作台对话窗口中验证带知识引用角标的企业客服问答。
功能详解与操作指南
步骤 1:创建知识库(示例)
在左侧导航栏点击 知识库,点击右上角 创建知识库 按钮。
按实际模型和文件填写表单。下表是配置示例,知识库 ID 由控制台生成,模型和维度需以实际可用配置为准:
| 配置项 | 字段名 | 标杆配置值 | 说明与约束 |
|---|---|---|---|
| 知识库名称 | name | 企业智能客服与技术支持知识库 | 展示名称;控制台自动生成知识库 ID |
| 描述 | description | 沉淀架构白皮书、客服 SOP、OceanBase 向量排障与 AI 网关规范 | 选填,说明知识库覆盖领域 |
| 向量模型 | embeddingModel | text-embedding-v3(来自 dashscope-prod) | 必选且创建后不可变更;系统自动探测模型可用性 |
| 向量维度 | embeddingDimension | 1024 | 与 text-embedding-v3 输出维度严格一致,存储在 OceanBase Shared V2 向量表中 |
| 文档解析器 | documentParser | vlm(默认,需配置视觉模型);适用时可选 text 或 mineru | 控制原始文件到结构化 Markdown 文本的提取方式 |
| 分块策略 | chunkingParser | title / smart | 推荐技术文档使用按标题层级或智能语义分块 |
| 分块大小与重叠率 | chunkTokenNum / overlapPercent | 512 Tokens / 10% | 兼顾上下文完整性与向量聚焦度 |
| 图片理解 | imageUnderstanding | 开启,模型选 qwen-vl-max,并发度 4 | 自动对文档内的架构图与截图生成文字描述并合入分块索引 |
步骤 2:摄取核心文档并轮询 202 异步摄取状态至 ready
进入实际创建的知识库的文档页,上传有权使用的文件。下文 ID、文件和返回结果仅为示例,请替换为实际值。
通过
POST /v1/knowledgebases/{knowledgeBaseId}/documents创建文档记录时返回 HTTP201;调用POST /v1/knowledgebases/{knowledgeBaseId}/documents/{documentId}/ingestions发起摄取时返回 HTTP202和摄取任务信息。控制台可在上传后自动发起摄取。客户端或自动化脚本分别查询摄取作业和文档详情;摄取详情接口不返回文档状态。以下是接口路径,不是命令:
GET /v1/knowledgebases/{knowledgeBaseId}/documents/{documentId}/ingestions/{ingestionId}

GET /v1/knowledgebases/{knowledgeBaseId}/documents/{documentId}
将下列占位值替换为实际值,使用具有 knowledgebases.read 权限的项目密钥。若检查版本化知识库中的草稿,请在两个地址中附加该草稿的 versionId 查询参数。
(
  set +x
  set -e -o pipefail
APPBASE_ENDPOINT="https://your-agentbase.example.com/v1"
APPBASE_PROJECT_ID="your-project-id"
APPBASE_KB_ID="your-knowledge-base-id"
APPBASE_DOCUMENT_ID="your-document-id"
APPBASE_INGESTION_ID="your-ingestion-id"
read -r -s -p 'API key: ' APPBASE_API_KEY
printf '\n'
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | \
  curl --disable --header @- -fsS -i -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
    "${APPBASE_ENDPOINT}/knowledgebases/${APPBASE_KB_ID}/documents/${APPBASE_DOCUMENT_ID}/ingestions/${APPBASE_INGESTION_ID}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | \
  curl --disable --header @- -fsS -i -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
    "${APPBASE_ENDPOINT}/knowledgebases/${APPBASE_KB_ID}/documents/${APPBASE_DOCUMENT_ID}"
unset APPBASE_API_KEY
)也可以在控制台知识库的文档列表打开相应文档,查看文档状态和摄取记录;要通过 API 核对活跃代数,请另行调用文档详情接口。
分别确认摄取作业和文档状态均为
ready,并核对文档的activeGeneration与该作业的generation一致,再检索新代内容。向量维度以知识库实际配置为准。
步骤 3:绑定词库(Lexicon)并启用高级索引(GraphRAG / RAPTOR / Wiki)
绑定项目级词库:
在项目 词库(Lexicons) 中创建同义词词典
lex_enterprise_synonyms(例如将OB向量报错4013、向量内存不足映射至标准术语OB_ALLOCATE_MEMORY_FAILED)和停用词词典lex_support_stopwords。调用
PUT /v1/knowledgebases/kb_enterprise_support/lexicons或在知识库设置页勾选绑定这两个词库。
启用并构建派生索引:
切换到知识库 知识索引(Indexes) 页签,依次开启 GraphRAG、RAPTOR 与 LLM Wiki 三项索引能力开关,并点击 构建(Build)。
构建完成后,Graph 页签可浏览实体关系图谱,Wiki 页签自动编译生成包含首页总览(
kb-index)在内的 10 篇结构化百科页面。
步骤 4:执行混合检索(searchMode=hybrid)与关联智能体工作台
在 检索测试(Search) 页签核对召回与来源;以下 API 示例另开启答案合成,并指定重排模型。示例模型名须替换为项目实际配置,显式模型失败不会被 allowDegraded 忽略:
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
: "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the target API endpoint including /v1}"
APPBASE_ENDPOINT="${APPBASE_ENDPOINT%/}"
: "${APPBASE_PROJECT_ID:?Set APPBASE_PROJECT_ID for the target environment}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X POST "${APPBASE_ENDPOINT}/knowledgebases/kb_enterprise_support/search" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "query": "OceanBase 向量索引构建报 4013 内存不足时如何排障?工单升级 SOP 是什么?",
    "searchMode": "hybrid",
    "vectorWeight": 0.7,
    "similarityThreshold": 0.35,
    "limit": 5,
    "rerank": true,
    "rerankModel": "qwen3.7-text-rerank",
    "recallLimit": 20,
    "allowDegraded": true,
    "answer": true
  }'
)
随后,在 智能体工作台(Agent Runtime) 中保存项目级配置(/v1/agent-runtime/project/config),将 kb_enterprise_support 与词库 lex_enterprise_synonyms、lex_support_stopwords 挂载至 qwen-plus 智能体,即可在对话面板直接获得融合了排障指南与客服 SOP 的精准解答。
知识库设置与词库管理
在知识库设置页可调整文档处理与检索默认配置,检查词库绑定和文档重建提示。操作步骤及删除存储桶等注意事项见知识库设置。
词库可管理同义词、扩展词和停用词,绑定时需要显式启用。创建、预览、导入和绑定步骤见词库管理;覆盖导入会替换已有词条,应先试运行并确认影响。
首次完成一次检索
建议按“准备模型 → 创建知识库 → 摄取文档 → 检索验证 → 核对来源”的顺序走完一条路径。下图只表达已核验的操作关系,不还原 Console 页面,也不是运行截图:
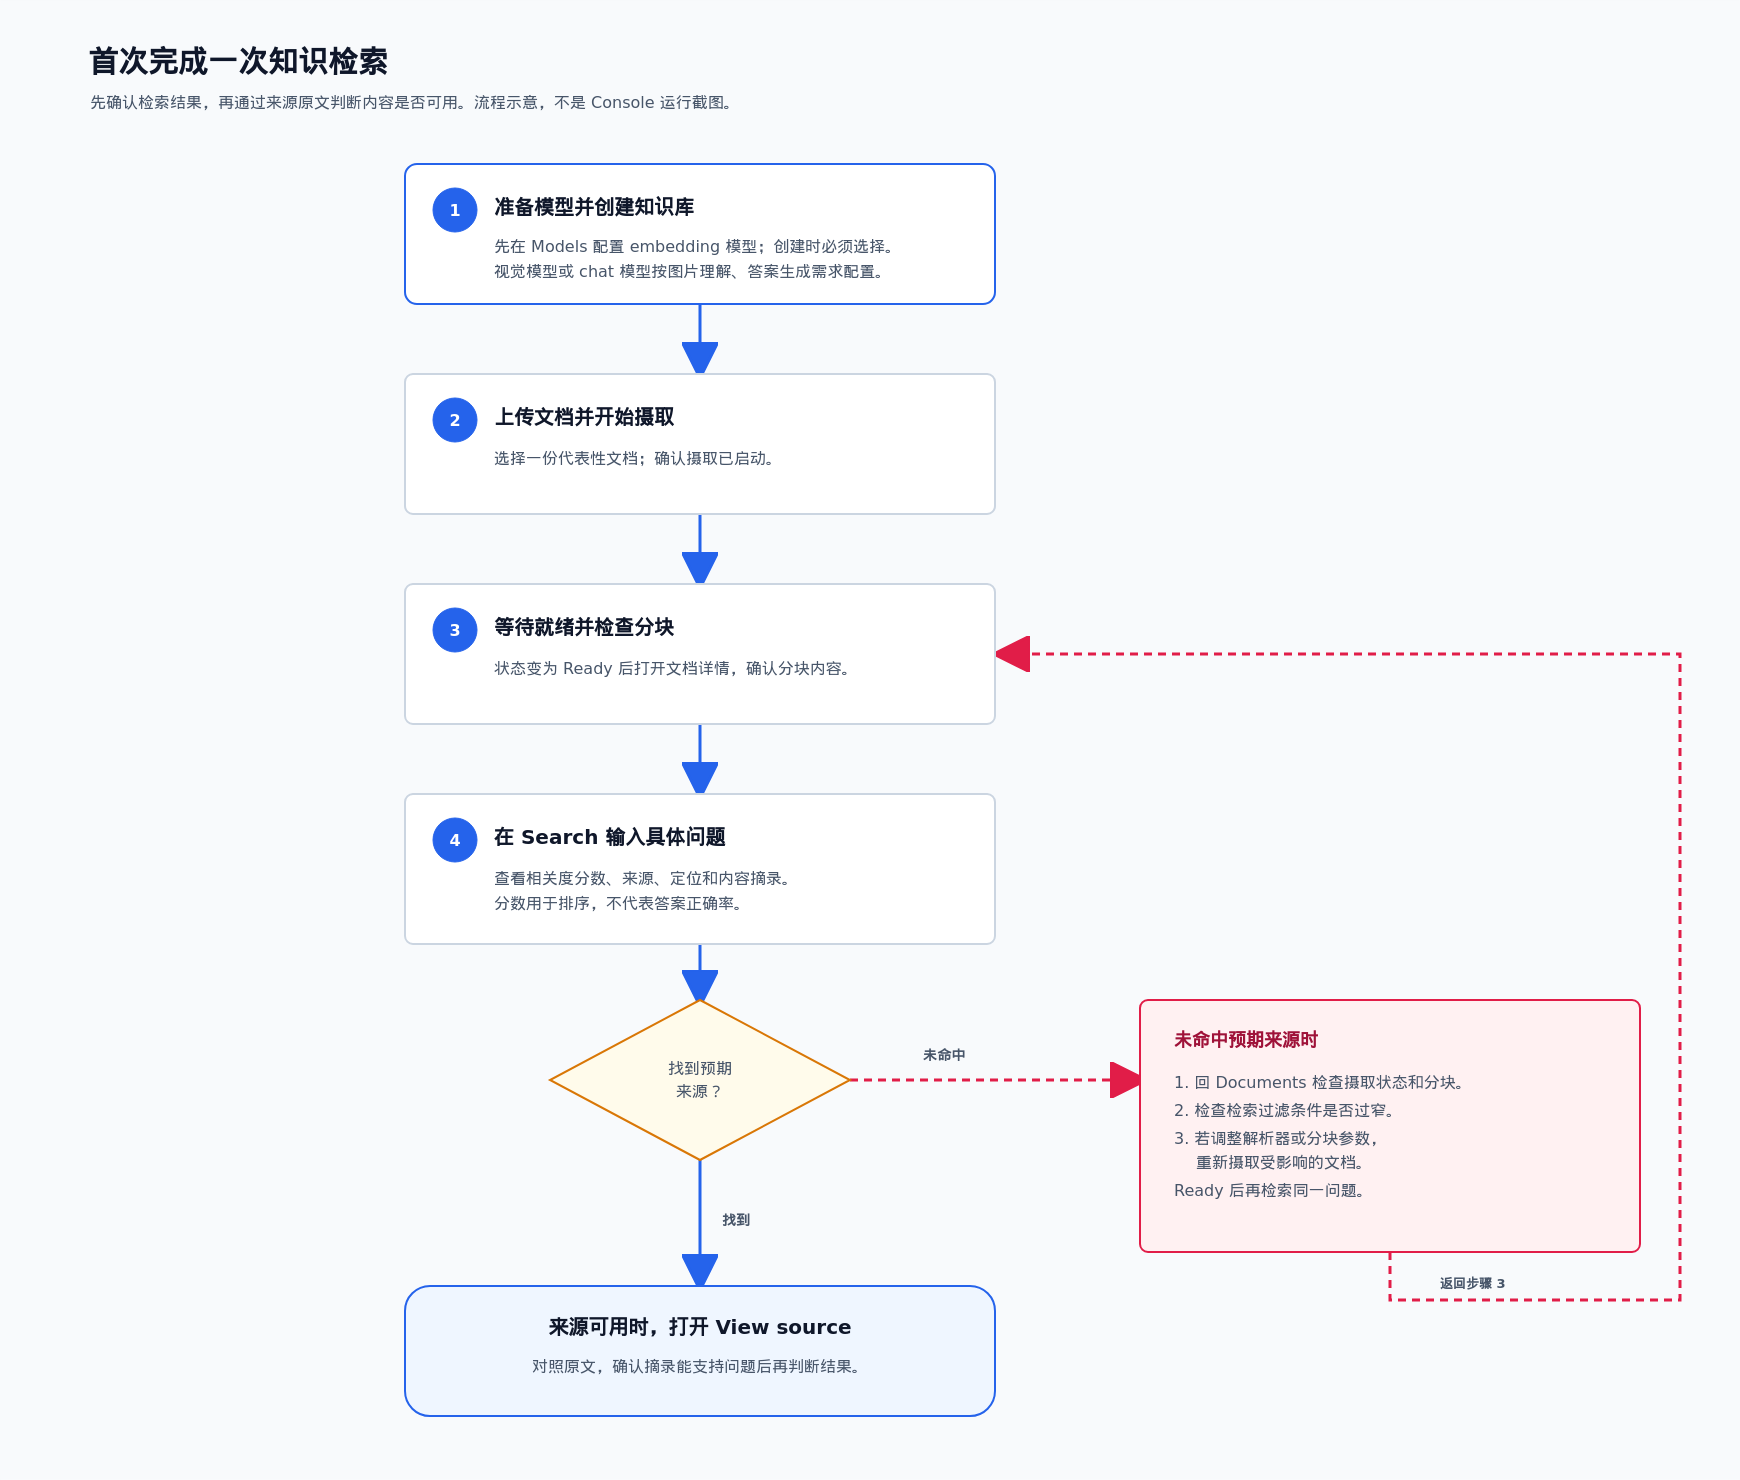
创建知识库前,至少要有一个具备 embedding 能力的模型;只有需要图片理解时才额外配置视觉模型。若要让检索请求生成答案,还需按部署能力配置对应的 chat 模型。模型服务和可选解析能力都受项目配置及部署能力约束,见模型与 AI 网关。
如果结果缺少预期内容,先确认文档已完成摄取,并检查解析和分块结果;修改解析器或分块参数后,需要重新摄取受影响的文档。检索结果的分数用于排序,不代替对来源原文的核对。
创建知识库
列表页点击创建知识库。下图为测试项目的示例配置;实际使用时请选择项目中可用的模型和解析器。
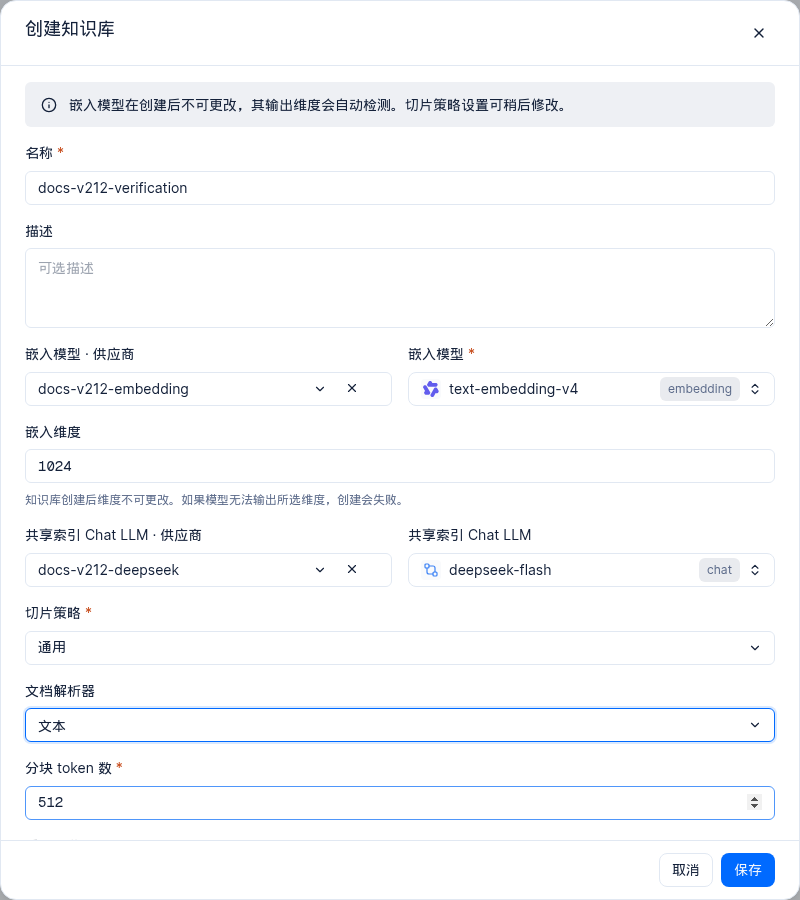
图:2.12.0 测试环境的创建表单。
主要字段:
| 字段 | 规则 |
|---|---|
| Name / Description | 名称必填;描述可选 |
| 向量模型 | 必填。可从所选供应商的模型中选择;没有可选模型时可输入模型名称。提交时服务端仍会检查模型是否可用 |
| 向量维度 | 可选。控制台按模型维度元数据校验;无元数据时使用预设候选维度。服务端会探测模型,不匹配则创建失败 |
| Image understanding | 开关 + 模型 + 提示词 + 最大并发(需项目已配置视觉模型 Provider) |
| Chunking parser | general / title / smart / regex / faq,及分块参数:chunkTokenNum(默认 512)、overlapPercent(默认 10)、titleLevel(默认 3)、minChunkTokens(默认 128)、delimiter、regexPattern |
创建后可在知识库设置中配置摄取追踪(tracingEnabled);该功能依赖平台管理员开启全局开关。解析配置及追踪只影响之后的摄取;历史文档需要重新摄取。
使用边界
图片理解要求项目级视觉模型 Provider;embedding 输入超限会显式失败。
模型与 embedding 调用使用项目在 Models 页配置的 Provider(见模型与 AI 网关)。
检索结果在 Observability 中的证据链与评估见可观测。
常见问题与排障(FAQ)
Q1:摄取接口返回 HTTP 202 后,为什么立即检索不到文档内容?
原因分析: HTTP
202表示摄取任务已成功入队并开始异步处理(经历文件读取 -> 解析器转换 -> 分块切分 -> 多模态图片解读 -> Embedding 向量化入库)。任务尚未完成时,文档可能还在处理中,不能假定内容已可检索。解决措施: 分别查询摄取任务详情和文档详情(见上文步骤 2)。确认两者状态均为
ready、文档activeGeneration与任务generation一致,再执行检索。
Q2:启用 Rerank 后,上游限流是否会让检索失败?
取决于是否显式选择重排模型或 Provider。传入 rerankModel 或 rerankProviderRef 时,调用异常会返回给调用方;应修复模型配置、限流或服务故障。两者均未指定的自动重排采用尽力执行方式,失败可回退原排序,返回 reranked: false,此时不要把结果当作已精排。
allowDegraded 单独控制增强检索的可降级错误,不能用于忽略显式重排模型失败。单库响应的 capabilities 与 degradedCapabilities 描述增强能力状态;按业务是否接受基础结果选择该开关。
Q3:调整分块或图片理解后,旧文档会自动更新吗?
配置变更与重新处理文档是不同步骤。检查设置页的重建提示;如需应用新配置,按知识库设置和文档与摄取检查目标、提交处理并等待任务完成。
Q4:词库(Lexicon)绑定在知识库上和绑定在智能体工作台上有什么区别?
原因分析: 知识库级词库绑定与智能体工作台级词库绑定处于不同的执行切面,分别服务于「RAG 召回与图谱消歧」与「对话入口合规阻断」。
解决措施:
绑定在知识库上(
/v1/knowledgebases/{kbId}/lexicons):对发往该知识库/search的查询按配置执行同义词改写(synonym)和追加词扩展(expansion);直接搜索不使用词库中的停止词(stop)清洗查询。在知识索引启用相应词库能力时,词库也可用于 GraphRAG 实体归一化(详见项目级词库治理)。绑定在智能体工作台上(
/v1/agent-runtime/project/lexicons):不仅对工作台发起的 RAG 检索生效,还支持在对话入口层执行停用词/敏感词前置拦截(stopIntercept: true)并直接返回预设拦截回复(stopReply),无需消耗大模型推理 Token。