
GraphRAG、RAPTOR 与高级知识索引构建治理
知识索引在基础检索之外,提供 GraphRAG 图谱、RAPTOR 摘要和 Wiki 页面。可在知识库的知识索引页配置、构建并查看状态;模型与功能是否可用取决于部署。
功能概述与核心场景
知识索引为已有文档和分块生成可按需使用的派生结果:GraphRAG 用于探索实体与关系,RAPTOR 用于构建多层摘要,Wiki 用于组织可阅读的知识页面。选择能力前,请确认部署支持情况、模型配置和来源文档状态;生成结果仍需结合原文核验。
核心概念与架构
GraphRAG 构建流程
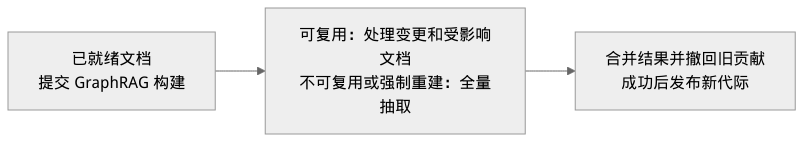
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
一、GraphRAG 图谱
GraphRAG 从文档分块中抽取实体与关系,并可按配置进行实体消歧和社区分析。图谱适合探索跨文档关联;结果仍需结合原文核实。
| 配置字段 | 说明 |
|---|---|
enabled | 是否启用该能力,默认 false。 |
entityTypes | 实体类型;未指定时使用系统默认类型。 |
method | 抽取方式:light 或 general,默认 light。 |
resolution / community | 是否启用实体消歧 / 社区分析,默认均为 false。 |
lexiconEnabled | 构建图谱时是否使用已绑定词库,默认 false。 |
maxEntitiesPerUnit | 可选,每个抽取单元的实体预算,JSON 整数 1–128。 |
language | 输出语言:auto、zh、en 或 ja,默认 auto。 |
二、RAPTOR 摘要索引
RAPTOR 对分块进行聚类和摘要,形成多层语义摘要结果。实际摘要及向量使用已配置的模型,不固定为某个厂商或维度。
| 配置字段 | 说明 |
|---|---|
enabled | 是否启用该能力,默认 false。 |
scope | document 按文档构建,knowledgeBase 按知识库构建;默认 document。 |
prompt | 摘要提示词。 |
maxToken | 摘要长度上限,默认 256,范围 1–2048。 |
maxCluster | 聚类数上限,默认 64,范围 1–1024。 |
threshold | 聚类阈值,默认 0.1,范围 0–1。 |
language | 输出语言:auto、zh、en 或 ja。 |
三、Wiki 编译
Wiki 可根据配置的来源生成页面。自动编译开启且选择等待图谱时,可能出现 await_graphrag;应先检查 GraphRAG 和 Wiki 的任务状态。页面数量与耗时取决于实际来源和配置,不是固定值。相关的自动编译选项包括 autoCompileOnDocumentUpdate、autoCompileSources 和 autoCompileWaitForGraphRag;Wiki 构建并发选项为 wikiPageMaxConcurrent。
四、双轴状态机、陈旧原因(staleReason)与 ModelCapacity 容量治理
1. 能力状态与结果代际
能力响应分别给出 available、configured 和 enabled,表示部署是否提供该能力、是否已保存配置以及是否启用;state 描述当前索引状态。activeResultGeneration 是当前已发布结果的代际标识,并非可直接加一的整数。构建作业有独立状态;提交成功只表示已受理,应继续查询作业结果。
2. 常见陈旧原因(staleReason)
| 原因 | 含义 |
|---|---|
document_generation_changed | 文档摄取代数发生变化 |
document_deleted | 文档被删除 |
document_enabled_changed | 文档启用状态发生变化 |
document_metadata_changed | 文档元数据发生变化 |
chunk_changed | 分块发生变化 |
indexing_model_changed | 索引使用的模型发生变化 |
document_processing_config_changed | 文档处理配置发生变化 |
capability_config_changed | 索引能力配置发生变化 |
出现 stale 时,先核对变更范围和当前能力状态,再根据实际情况发起构建并等待任务完成;旧结果能否用于当前请求取决于具体检索路径和状态,不能保证所有检索一定成功。
3. 模型调用容量
索引服务在同一进程内分别限制对话模型和向量模型的并发调用,多个能力和作业共享对应容量。实际吞吐还受模型服务与部署配置影响;该限制不等于对在线检索延迟或模型配额的保证。
功能入口与权限矩阵
| 控制台入口 / 功能模块 | 前端路由路径 | 对应 REST API 端点 | Server SDK 方法(Node.js / Python) | 所需 RBAC 角色 / API Key Scope | 跨模块依赖关系 |
|---|---|---|---|---|---|
| 知识库 → 知识索引总览页 | /console/project-default-enterprise-ai-hub-210/knowledge-base/kb-kb_enterprise_support/indexes | GET /v1/knowledgebases/{kbId}/index-capabilities | knowledgeBase.listIndexCapabilities() / list_index_capabilities() | 角色:owner、admin、developer、member(只读)Scope: knowledgebases.read | 具体能力和构建前置以当前环境为准 |
| 配置 GraphRAG / RAPTOR / Wiki 能力参数 | /console/.../kb-kb_enterprise_support/indexes(点击对应卡片「配置 Configure」) | PATCH /v1/knowledgebases/{kbId}/index-capabilities/{capability} | knowledgeBase.updateIndexCapability() | 角色:owner、admin、developerScope: knowledgebases.write | 按所选能力配置可用模型;启用 lexiconEnabled 时检查词库绑定 |
| 派发增量构建、修复或全量重建作业 | /console/.../kb-kb_enterprise_support/indexes(点击「构建 Build」或「重建 Rebuild」) | POST /v1/knowledgebases/{kbId}/index-operationsGET /v1/knowledgebases/{kbId}/index-operations | knowledgeBase.createIndexOperation()knowledgeBase.listIndexOperations() | 角色:owner、admin、developerScope:GET knowledgebases.read;POST knowledgebases.write | 与版本管理(Versions)就绪门禁联动 |
| 取消正在运行的索引作业 | 最近任务列表行操作「取消(Cancel)」 | POST /v1/knowledgebases/{kbId}/index-operations/{operationId}/cancel | knowledgeBase.cancelIndexOperation() | 角色:owner、admin、developerScope: knowledgebases.write | 仅对 queued 或 running 状态的作业生效 |
| 清空指定派生索引数据 | 能力卡片更多菜单「清空索引数据(Clear)」 | POST /v1/knowledgebases/{kbId}/index-capabilities/{capability}/clear | knowledgeBase.clearIndexCapability() | 角色:owner、adminScope: knowledgebases.write | 请求体须提供 confirmation 和 idempotencyKey;仅清理派生索引,不删原始文档与基础分块 |
功能详解与操作指南
步骤 1:配置索引能力
进入项目和目标知识库,打开知识索引页面。能力是否可用取决于部署和项目配置。
根据需要选择 GraphRAG、RAPTOR 或 Wiki,打开对应配置,启用能力并填写所需选项。构建前按能力配置可用的模型;若使用词库增强,先检查知识库的词库绑定。
保存后检查配置与能力状态,再提交构建。语言、模型和文档数量应按实际环境选择,页面不会预置本文中的示例数据。
步骤 2:构建索引并查看作业
在知识索引页面选择需要构建的能力并提交构建,然后查看对应作业状态。REST 接口使用 kind 指定 build 或 repair;返回 202 仅表示请求已受理。
GraphRAG 普通构建可在满足条件时复用上次成功构建的结果;无可用种子或配置发生不兼容变化时会回退为全量处理。删除或修改共享内容也可能导致其他相关文档重新抽取,因此耗时和模型消耗以实际任务为准。若需强制重新抽取,可在本次 GraphRAG 作业的 config.forceRebuild 设置为 true;这与用于取消其他活动作业的 force 不同。
步骤 3:通过 REST API 完整操控三大索引能力与作业生命周期
以下写入示例适用于已启用版本管理的知识库:将 <DRAFT_VERSION_ID> 替换为目标草稿版本 ID。未启用版本管理时,请求应省略 versionId。下方配置示例适用于新配置:PATCH 会替换完整 config,修改已有配置时先读取并合并需要保留的字段。清理操作会移除所选能力的派生结果,请确认目标后再执行。
查询知识库三大高级索引能力的当前状态、代际号与陈旧原因 (GET /index-capabilities)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X GET "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-capabilities?versionId=<DRAFT_VERSION_ID>" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @-
)
示例:配置 GraphRAG(PATCH 替换完整 config)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X PATCH "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-capabilities/graphrag" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "versionId": "<DRAFT_VERSION_ID>",
    "config": {
      "enabled": true,
      "language": "zh"
    }
  }'
)
示例:配置 RAPTOR(PATCH 替换完整 config)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X PATCH "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-capabilities/raptor" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "versionId": "<DRAFT_VERSION_ID>",
    "config": {
      "enabled": true,
      "language": "zh"
    }
  }'
)
示例:配置 Wiki(PATCH 替换完整 config)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X PATCH "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-capabilities/wiki" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "versionId": "<DRAFT_VERSION_ID>",
    "config": {
      "enabled": true,
      "language": "zh"
    }
  }'
)
提交 GraphRAG 构建作业 (POST /index-operations)
每次新的独立构建都要生成新的唯一 idempotencyKey 并替换示例占位符;只有重试同一次请求时才复用原键。复用旧键可能返回已有作业,而不会重新构建;提交后请查询该作业直至终态。
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X POST "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-operations" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "versionId": "<DRAFT_VERSION_ID>",
    "capability": "graphrag",
    "kind": "build",
    "config": {"forceRebuild": false},
    "idempotencyKey": "<NEW_BUILD_OPERATION_KEY>"
  }'
)
取消正在排队或运行中的构建作业 (POST /index-operations/{operationId}/cancel)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X POST "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-operations/iop_7c6b5a4d3e2f1098/cancel" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{"versionId":"<DRAFT_VERSION_ID>"}'
)
清理 RAPTOR 派生索引(操作前确认目标)。仅在确认目标与影响后单独执行。每次新的独立清理使用新的唯一
idempotencyKey;只有重试同一次请求时复用原键,否则可能返回旧的清理作业。提交后请查询该作业直至终态。
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X POST "https://<your-endpoint>/v1/knowledgebases/<KNOWLEDGE_BASE_ID>/index-capabilities/raptor/clear" \
  -H "X-Appwrite-Project: <YOUR_PROJECT_ID>" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "versionId": "<DRAFT_VERSION_ID>",
    "confirmation": "clear:raptor",
    "idempotencyKey": "<NEW_CLEAR_OPERATION_KEY>"
  }'
)
常见问题与排障(FAQ)
Q1:文档更新后索引为什么显示 stale?
文档、分块、模型或能力配置变化可能使已发布的索引结果过期。先查看 staleReason 与任务状态,再构建相应能力;不要把文档摄取成功当成索引构建成功,也不要假定旧结果一定适用于所有检索路径。
Q2:Wiki 为什么等待 GraphRAG?
当 Wiki 的配置依赖 GraphRAG,而图谱结果尚未就绪时,可能出现 await_graphrag。检查所需来源、GraphRAG 任务和 Wiki 任务状态,按实际错误排查;完成时间取决于具体任务与环境。
Q3:修改词库后如何更新图谱?
构建时启用 lexiconEnabled 的图谱会使用当时的词库配置。修改词库不会自动改写已有结果;需要更新时,重新构建 GraphRAG 并核对新结果。
Q4:清空派生索引会删除源文档吗?
清理操作针对指定能力的派生索引,不是删除源文档或基础分块。操作前请确认目标能力与环境;REST 请求需要 confirmation(例如 clear:raptor)及 idempotencyKey。清理后的高级索引需要重新构建。
相关文档
场景目录与增强任务
从项目侧栏进入 知识库 → 场景库,用分类树组织企业智能客服中的退款、发货、账户等场景;每条场景保存名称、完整分类路径与定义。可以创建分类和场景,或先解析 Excel/CSV,再预览列映射、目录树、冲突及待导入条目,确认无误后执行导入。解析和预览不等同保存成功;提交后回到分类树核对场景数量、名称与定义。操作需要场景读取/写入权限,知识库绑定还须具备对应库的管理权限。
在 GraphRAG 的场景模式中选择场景目录或分页选择场景,再发起构建。系统使用场景名称、完整分类路径和定义建立实体,从关联文档补充描述并抽取关系。补充实体描述提示词与原描述摘要提示词用途不同,已有图谱需要重新构建才体现新设置。先检查分类绑定的知识库,再检查构建终态与实体来源,不能仅凭选择成功认定图谱已更新。Wiki 支持按场景目录聚合。
文档完成切片后,可对已保存分块重新执行关键词、问题和元数据增强;清除增强只针对增强结果。全库与指定文档范围分别选择,临时配置只影响本次任务,不覆盖知识库设置。仅补齐缺失结果可减少重复模型调用;查看任务进度、失败明细后再决定重试,取消不会抹去已经完成的工作。