
文档与摄取管理
文档与摄取(Documents & Ingestion) 是知识库(如 kb_enterprise_support)将原始非结构化文件转化为高质量可检索分块(Chunks)与向量的核心生产车间。通过知识库详情页的 文档(Documents) 页签,用户可以批量上传或绑定存储桶文件、灵活配置文档解析器(text / vlm / mineru)与按文件格式选择分块策略(general / title / smart / regex / faq / sheet)、管理层级分类标签与精确定位标识(documentTag、subProductId)、跟踪异步摄取任务及文档状态,并对生成的分块进行在线审阅、编辑与图片理解结果核验。
摄取任务与文档是不同对象:创建摄取返回 HTTP 202 表示已受理。轮询任务状态 queued、running、ready、failed、cancelling 或 cancelled;文档可处于 processing,成功后还需确认文档为 ready,且文档的 activeGeneration 与该任务的 generation 一致。
功能概述与核心场景
高质量的 RAG 问答效果取决于“解析准不准、分块合不合理、标签细不细”。Agentbase 在文档与摄取模块提供了精细化的全生命周期控制能力:
双模式文件接入与批量上传:
控制台批量直传:文件选择器支持单批次最多上传 50 个文件,自动将原始文件持久化至知识库专属存储桶(如
kb_enterprise_docs)并创建文档记录,默认上传后立即触发异步摄取。Storage 文件 ID 绑定:支持通过 API 直接引用已上传至项目存储桶(Storage)的
fileId创建文档并启动摄取,避免重复传输大文件。
三类多模态文档解析器(Document Parsers):
支持针对纯文本/Markdown 的极速解析(
text)、针对复杂扫描件与架构图的视觉大模型解析(vlm,使用已配置的视觉模型),以及针对复杂双栏 PDF、跨页表格与数学公式的深度版面还原(mineru)。支持 Excel(
.xlsx/.xls)按工作表(Sheet)结构化切片,并可叠加 图片增强(Image Understanding) 自动提取内嵌图表的语义描述。
按格式选择分块策略(Chunking Parsers):
内置
general(通用定长滑窗)、title(按 Markdown/文档标题层级切分)、smart(语义边界智能切分)、regex(自定义正则表达式切分)、faq(问答对结构切分)与sheet(工作表切分)。可用策略取决于文件格式;支持按需调节chunkTokenNum、overlapPercent、titleLevel、minChunkTokens等参数。
文档标签与定位标识:
支持斜杠分隔的父子层级标签(如
技术支持/数据库/OceanBase),提供标签树目录视图与平铺列表视图。v2.10.0 新增定位标识
documentTag与subProductId:支持结构化定位值及自由格式标签,并可在文档列表、检索与 Wiki 冲突列表中按标签和子产品筛选。
分块级(Chunk-level)透明审阅与在线热修:
文档摄取变为
ready后,可在文档详情页逐个查看分块文本、Token 长度、关联图片理解摘要,并支持在线编辑修正分块文本或删除噪声分块,修改后自动重算对应向量。
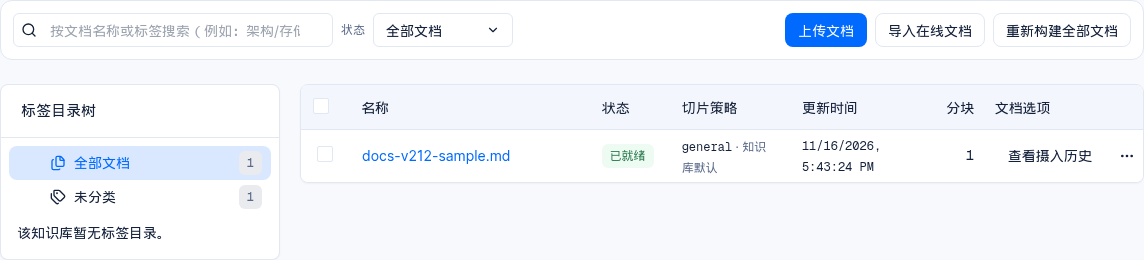
2.12.0 测试知识库中的合成文档已就绪;此示例尚未创建标签目录。
核心概念与架构
解析器与分块器核心概念表
| 组件维度 | 可选类型 | 适用文档场景与核心逻辑 |
|---|---|---|
文档解析器 (documentParser) | text | 适用于结构清晰的 .md、.txt、.docx、.html 及常规电子版文档,解析速度最快、零额外视觉模型开销。 |
文档解析器 (documentParser) | vlm | 调用项目已注册的视觉大模型(如 dashscope-prod 下的 qwen-vl-max)逐页识别复杂排版、扫描件、手写批注与架构流程图。 |
文档解析器 (documentParser) | mineru | 针对学术论文、技术白皮书与复杂财务报表 PDF,精准识别多栏排版、跨页表格与 LaTeX 公式并转换为结构化 Markdown。 |
分块解析器 (parserId) | general | 通用滑动窗口分块。按固定的 chunkTokenNum(默认 512)与 overlapPercent(默认 10%)切分,适用无明显标题结构的长文本。 |
分块解析器 (parserId) | title | 按文档指定标题层级(titleLevel,默认 3 即 ###)切分章节;片段可能补入当前标题,不保证包含完整父级标题路径。 |
分块解析器 (parserId) | smart | 综合段落边界、语义连贯性与最小分块阈值(minChunkTokens,默认 128)动态合并碎片段落、切分超长段落。 |
分块解析器 (parserId) | regex | 按用户指定的正则表达式(regexPattern)切分文档,适用于日志归档、特定格式法条或标准化条目文件。 |
分块解析器 (parserId) | faq | 逐行读取问答:每行第一列作为分块正文和问题,第二列存入 metadata.answer;请将每组问答放在同一行的两列中,相邻的问、答两行不会自动合并。 |
功能入口与权限矩阵
控制台入口、REST API、SDK 方法与权限矩阵
| 控制台入口 / 功能模块 | 前端路由路径 | 对应 REST API 端点 | Server SDK 方法(Node.js / Python) | 所需 RBAC 角色 / API Key Scope | 跨模块依赖关系 |
|---|---|---|---|---|---|
文档列表、目录树与 documentTag 筛选 | /console/project-default-enterprise-ai-hub-210/knowledge-base/kb-kb_enterprise_support | GET /v1/knowledgebases/{kbId}/documents | knowledgeBase.listDocuments() / list_documents() | 角色:owner、admin、developer、member(只读)Scope: knowledgebases.read | 目录视图使用 directoryPath / directoryUnclassified;列表另支持 documentTag、subProductId 过滤 |
| 批量上传文档 | /console/.../kb-kb_enterprise_support(点击「上传文档 Upload documents」) | POST /v1/knowledgebases/{kbId}/documents/batch | knowledgeBase.createDocumentsBatch() / create_documents_batch() | 角色:owner、admin、developerScope: knowledgebases.write | 先上传文件并批量创建文档记录,返回 HTTP 201;按需单独发起摄取 |
| 绑定单个存储桶文件 | 通过接口注册已有文件 | POST /v1/knowledgebases/{kbId}/documents | knowledgeBase.createDocument() / create_document() | 角色:owner、admin、developerScope: knowledgebases.write | 创建记录后按需单独发起摄取 |
| 查询异步摄取进度与触发重摄取 | 文档列表状态徽章与行操作「重新摄取(Re-ingest)」 | POST /v1/knowledgebases/{kbId}/documents/{docId}/ingestionsGET .../ingestions/{ingestionId} | knowledgeBase.createIngestion()knowledgeBase.getIngestion() | 角色:owner、admin、developerScope: knowledgebases.write / read | 使用知识库配置的可用向量模型,向量维度须匹配;使用 vlm 解析或图片理解时还需配置可用的视觉模型(详见 知识库设置) |
| 编辑文档标签与定位标识 | 文档行操作「编辑标签(Edit tags)」 | PATCH /v1/knowledgebases/{kbId}/documents/{docId} | knowledgeBase.updateDocument() | 角色:owner、admin、developerScope: knowledgebases.write | documentTag 联动 混合检索、知识图谱 与 Wiki 冲突工作台 |
| 分块(Chunks)透明审阅与在线热修 | /console/.../kb-kb_enterprise_support/doc-{docId} | GET /v1/knowledgebases/{kbId}/documents/{docId}/chunksPATCH .../chunks/{chunkId} | knowledgeBase.listChunks()knowledgeBase.updateChunk() | 角色:owner、admin、developer(只读成员仅查看)Scope:查询 knowledgebases.read;更新 knowledgebases.write | 编辑分块后自动重算向量,相关 高级知识索引 可能标记为 stale (chunk_changed) |
| 个人语雀 URL 导入 | 文档页「导入语雀 URL」 | POST /v1/knowledgebases/{kbId}/documents/yuque | knowledgeBase.createYuqueDocuments() | 需当前用户会话或 JWT、语雀 OAuth 授权及 knowledgebases.write 权限 | 详见 外部数据源接入与语雀增量同步 |
| 团队数据源同步 | 数据源 页签 | POST /v1/knowledgebases/{kbId}/datasources/{id}/syncs | knowledgeBase.createDataSourceSync() | Scope:knowledgebases.write | 需配置团队数据源及其凭据,详见 外部数据源接入与语雀增量同步 |
功能详解与操作指南
一、上传企业知识文档并配置分块参数
在标杆知识库 kb_enterprise_support 中,我们摄取了 4 篇核心生产文档。以下是具体操作步骤:
在知识库 文档(Documents) 页签点击右上角 上传文档(Upload documents)。
拖拽或选择本地文件(单次最多支持 50 个文件):
Agentbase企业架构白皮书.md智能客服SOP标准作业手册.mdOceanBase分布式事务与向量索引排障指南.mdAI网关模型路由与限流计费规范.md
在上传配置面板中设置解析与分块参数(可保持知识库默认值,也可针对当前批次单独定制):
| 参数名称 | 字段标识 | 推荐配置值 | 取值范围与说明 |
|---|---|---|---|
| 立即开始摄取 | 控制台开关 | 按需开启 | 先创建文档;开启时控制台再为每个文档单独创建摄取任务。文档创建与摄取受理分别返回 201 与 202。 |
| 文档解析器 | parserConfig.documentParser | 按文档类型选择 | 可选 text / vlm / mineru;vlm 需要可用视觉模型,mineru 需要可用的解析服务。 |
| 分块解析器 | parserId | 按文档类型选择 | 可选项随文件格式变化,包括 general / title / smart / regex / faq / sheet;smart 对纯表格文件可选择 sheet。 |
| 目标分块 Token 数 | parserConfig.chunkTokenNum | 例如 512 | 适用于 general / title / smart / regex;应符合向量模型输入限制。 |
| 分块重叠比例(%) | parserConfig.overlapPercent | 例如 10 | 适用于 general。 |
| 标题切分层级 | parserConfig.titleLevel | 例如 3 | 仅适用于 title。 |
| 最小分块 Token 数 | parserConfig.minChunkTokens | 按需设置 | 仅适用于 smart。 |
图片理解是独立设置,上传面板不提供该开关;如需使用,参见 知识库设置 并配置图片理解模型和提供商。
二、管理层级标签与定位标识(documentTag & subProductId)
控制台将自由格式的层级标签与结构化定位值写入同一个 documentTag 列表。旧的 metadata.tags 仍参与目录投影,但在编辑标签弹窗中只读;列表目录使用 directoryPath 或 directoryUnclassified 筛选。
1. 层级目录标签(Hierarchical Tags)
在文档列表中点击目标文档右侧的 编辑标签(Edit tags)。
输入以
/分隔的父子层级标签,例如:为
OceanBase分布式事务与向量索引排障指南.md添加标签:技术支持/数据库/OceanBase为
AI网关模型路由与限流计费规范.md添加标签:技术支持/AI平台/AI网关为
智能客服SOP标准作业手册.md添加标签:客服运营/标准作业/SOP
点击文档列表左上角的视图切换按钮,可在 目录树视图(Folder Tree View) 与 平铺列表视图(Flat View) 之间自由切换。
2. 文档定位标识(documentTag 与 subProductId)
自 v2.10.0 起,每篇文档均可绑定结构化的定位标识 documentTag 与子产品编码 subProductId:
标签格式:
documentTag可使用自由格式值,也可用逗号分隔多个非空标签。结构化定位值可写为{subProductId}_{sectionCode}_{fileKey};写入ob_12等省略末段的结构化值时,服务端会生成文件定位键。读取实际返回值后再用于精确定位。自动派生规则:创建或更新时,同时提交非空
documentTag并省略或清空subProductId,系统可从符合结构化格式的定位标识首段派生子产品编码;自由格式标签不保证产生该编码。清除与有效过滤值:更新时,传入
subProductId: ""且不同时提交非空documentTag,会删除独立字段;但读取与过滤仍可能回退到已有结构化定位标识中解析出的子产品编码。若要去掉这两处子产品关联,可同时清空subProductId与documentTag;这也会移除文档定位标识,应先确认调用方不再依赖该定位值。通过 API 更新文档定位标识并查询摄取状态示例:更新会替换
documentTag列表,请先读取并保留需要的值。版本化已启用时,写入须指定 DRAFTversionId;如另传metadata,它会替换现有业务元数据,先保留需要的业务字段。
将 APPBASE_ENDPOINT 设置为目标环境的 API 地址(包含 /v1),并确认项目与凭据属于该环境。 以下以已启用版本管理的知识库为例:将 <DRAFT_VERSION_ID> 替换为同一草稿版本 ID;未启用版本管理时,移除请求体及查询参数中的 versionId。
一次提交定位值和自由格式层级标签(会替换 documentTag 列表)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
: "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the target API endpoint including /v1}"
APPBASE_ENDPOINT="${APPBASE_ENDPOINT%/}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -X PATCH "${APPBASE_ENDPOINT}/knowledgebases/kb_enterprise_support/documents/doc_ob_troubleshooting" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{
    "versionId": "<DRAFT_VERSION_ID>",
    "documentTag": "ob_12_4a8b9c0d1e2f3a4b5c6d7e8f9a0b1c2d,技术支持/数据库/OceanBase,核心排障",
    "subProductId": "ob"
  }'
)
触发单文档重新摄取(返回 HTTP 202 Accepted 与摄取任务的
$id)
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
: "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the target API endpoint including /v1}"
APPBASE_ENDPOINT="${APPBASE_ENDPOINT%/}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -i -X POST "${APPBASE_ENDPOINT}/knowledgebases/kb_enterprise_support/documents/doc_ob_troubleshooting/ingestions" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  --header @- \
  -H "Content-Type: application/json" \
  -d '{"versionId":"<DRAFT_VERSION_ID>"}'
)
轮询摄取任务状态直至变为 ready
将下面的 <INGESTION_ID_FROM_RESPONSE> 替换为本次响应中的 $id,查询使用同一草稿版本;省略 versionId 时会读取当前版本,可能查不到草稿任务。状态为 failed 或 cancelled 时应停止等待并检查原因。
(
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
: "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the target API endpoint including /v1}"
APPBASE_ENDPOINT="${APPBASE_ENDPOINT%/}"
builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" | curl --disable -G "${APPBASE_ENDPOINT}/knowledgebases/kb_enterprise_support/documents/doc_ob_troubleshooting/ingestions/<INGESTION_ID_FROM_RESPONSE>" \
  --data-urlencode "versionId=<DRAFT_VERSION_ID>" \
  -H "X-Appwrite-Project: enterprise-ai-hub-210" \
  --header @-
)
三、审阅与编辑分块(Chunks)及整库重建(Reindex)
查看分块列表:在文档列表中确认目标文档状态为
ready后,点击文档名称进入 文档详情(Document Details) 页。检查与在线编辑分块:
页面按顺序展示切分出的全部 Chunk 卡片,每张卡片显示分块序号、Token 计数、章节路径与正文内容。
若开启了图片理解,含图分块下方会展示由已配置的视觉模型生成的 图片理解摘要(Image Caption / VLM Summary)。
点击任意分块卡片右上角的 编辑(Edit),可直接修正错别字、补充关键上下文或更新专有参数;保存正文后系统使用已配置的向量模型重新计算该分块的向量。
整库重建(Reindex):
当您在知识库设置中修改了全局默认分块策略(如将
chunkTokenNum从512改为800)后,回到 文档 页签顶部点击 整库重建(Reindex),系统将批量为库内全部文档派发异步重新摄取任务。
外部数据源与语雀同步
团队语雀数据源使用团队连接信息;个人语雀授权是独立的导入方式。配置步骤、权限和同步范围请参阅外部数据源与语雀文档。
发起同步后,在数据源的同步记录中查看任务状态。queued 表示排队中,running 表示处理中,ready 表示同步任务完成,failed 表示任务失败;同步结果中的 stats 可包含 created、updated、skipped、disabled 和 failed 计数。同步任务完成后,还需要检查各文档的摄取状态;只有文档处理就绪后才能验证检索结果。
上传与摄取文档
进入知识库 → 上传文档:文件选择器支持单批最多 50 个文件;文件上传到知识库专属存储后创建文档记录。默认上传后立即开始摄取,也可以关闭自动摄取。
等待文档状态变为 Ready,再打开文档详情查看分块。文档未就绪时先检查该文档的状态与处理结果,不要把尚未完成摄取的文档当作可检索内容。
需要调整解析器或分块参数时,先在该文档配置中修改,再对受影响文档重新摄取。配置变更不会回写到已摄取的旧文档。
Reindex 对知识库中的全部文档重新执行摄取与索引;只需更新少量文档时优先使用逐文档重新摄取。
URL / 外部数据源:通过 数据源 接入;当前内置的数据源类型为语雀(Yuque,含 OAuth 授权导入与 URL 导入),支持查看同步记录与管理数据源。
文档与分块管理
文档列表支持按名称或标签检索、删除文档和打开文档详情;详情页按分块(chunk)组织摄取内容。
层级标签和结构化定位值都可写入
documentTag列表;旧metadata.tags也参与目录投影,但在编辑标签弹窗中只读。目录使用directoryPath/directoryUnclassified查询。创建 / 更新文档可写定位字段;格式、派生和清除边界见本页“文档定位标识”小节。写入后可在文档列表与检索中按实际定位值过滤(见检索测试)。
分块支持编辑与删除;开启图片理解后,分块的图片理解结果可在文档详情中查看。
REST 接口支持用
enabled控制单个分块是否参与检索,禁用不会删除分块;重新启用还受文档、摄取代数和版本发布状态约束。当前文档仅核对接口行为,控制台入口与所用 SDK 参数以实际版本为准。摄取后可通过 REST 接口检查切片前的解析产物状态,并在产物就绪时读取解析后的 Markdown;历史文档可能需要重新摄取,过大或不支持的文档不能直接下载。
Excel 摄取:表格按工作表(sheet)切片解析;可配置图片增强(图片解读模型、提示词与并发度 1–8),提升含图表格与文档的摄取质量。
嵌入输入限制:嵌入模型的最大输入 Token 在 Models(LLM Gateway)的 Provider 表单「最大输入 Token」配置;超限的摄取输入会显式失败。
常见问题与排障(FAQ)
Q1:文档摄取状态变成 failed,报错提示 Embedding 输入超限,该如何排查与解决?
原因分析: 当单个分块的 Token 长度超过了知识库使用的向量模型所配置的
maxInputTokens时,摄取任务会显式失败以防止截断丢数。解决措施:
前往 模型(LLM Gateway)-> 模型提供商,检查该向量模型的最大输入 Token 配置,并遵循模型提供商的实际限制;
点击该失败文档右侧的 解析配置(Parser Config),将
chunkTokenNum调小(如512)或将分块器由regex改为smart/title,然后点击 重新摄取(Re-ingest)。
Q2:扫描版 PDF 或包含大量架构图的文档,使用 text 解析器提取不出文字怎么办?
原因分析:
text解析器仅提取文档内嵌的原生文本流,不会对光栅化图片或扫描页执行视觉 OCR 与拓扑理解。解决措施:
非纯文本文件通常默认使用
vlm,但文档或知识库的显式配置以及文件格式归一化可能改变实际解析器;先检查实际配置。使用
vlm时,配置可用视觉模型;使用mineru时,确认环境已配置可用的 MinerU 解析服务。调整解析器后重新摄取。图片理解是独立能力;如需使用,在 知识库设置中心 单独启用并配置其模型和提供商。
Q3:documentTag 的格式有什么校验要求?如果格式不合法会怎样?
原因分析:
documentTag接受自由格式标签或逗号分隔的多个非空标签;结构化定位值{subProductId}_{sectionCode}_{fileKey}可用于派生子产品等行为,末段是 32 位十六进制定位键。独立subProductId的非空值限 1–64 位字母或数字,不接受连字符、下划线或空格。解决措施: 避免在逗号分隔列表中提交空标签;写入后读取保存值并用于后续筛选。层级标签与定位值可共同保存在
documentTag中;旧metadata.tags在标签弹窗中只读。
Q4:Excel 表格上传后是如何被切分和向量化的?
原因分析: 表格数据具有强行列结构关联,若按普通纯文本滑动窗口切分会导致数据行脱离表头(Header)而丧失语义。
解决措施: Excel 文件(
.xlsx/.xls)由内置表格解析器按 工作表(Sheet) 进行结构化切片,自动在每个分块中保留表头(Header)与数据行的对应关系;若表格内嵌有业务截图且开启了图片理解,系统会按配置的并发度调用已配置的视觉模型生成图片说明并归入对应 Sheet 的分块中。