
记忆模型路由配置
功能概述与核心场景
记忆模型路由(Memory Model Routing,控制台页签为 模型)是 Agentbase Memory连接底层大模型与向量计算能力的枢纽,对应项目 Memory 配置中心的 provider 命名空间(/v1/projects/{projectId}/memory/config/provider)。Memory 并非单一模型调用,而是由稠密向量(Dense Embedding)、稀疏向量(Sparse Embedding)、对话生成(Chat LLM)、语义重排(Rerank)与多模态视觉(Vision LLM)五类异构模型协同驱动的复合智能引擎。
在 Agentbase 企业智能中台(69c6d1aa00062e6bb60)的示例项目 企业智能客服与知识中台(enterprise-ai-hub-210)中,Memory 模型路由统一挂载至项目的 DashScope 生产提供方 dashscope-prod(兼容端点 https://dashscope.aliyuncs.com/compatible-mode/v1):
使用
text-embedding-v3(1024 维) 构建高维稠密向量索引,并配合 DashScope 稀疏向量(Sparse) 实现专业术语(如 OceanBase 错误码-4013、工单号TK-20261022-001)的精准词项召回;使用
qwen-plus驱动事实抽取、冲突检测、画像归纳、Dreaming 上下文聚合以及经验/技能蒸馏,支持tool_call结构化输出模式;使用
qwen3.7-text-rerank对多路召回结果与新增记忆的冲突候选进行高精度语义重排;使用
qwen-vl-max独立承担 Storage(agent_multimedia_bucket)中架构图(PNG/JPEG/WebP)与排障手册(PDF)的视觉解析与以图搜忆转换。
核心概念与架构
Memory 服务本身不在业务表或异步 Job 快照中明文存储任何上游模型的 API Key。所有模型请求均以逻辑引用(providerRef: "project:dashscope-prod" + model)的形式发起,由 Agentbase 内部的 Models(LLM Gateway) 实时解析凭据、执行协议转换与可观测计量。
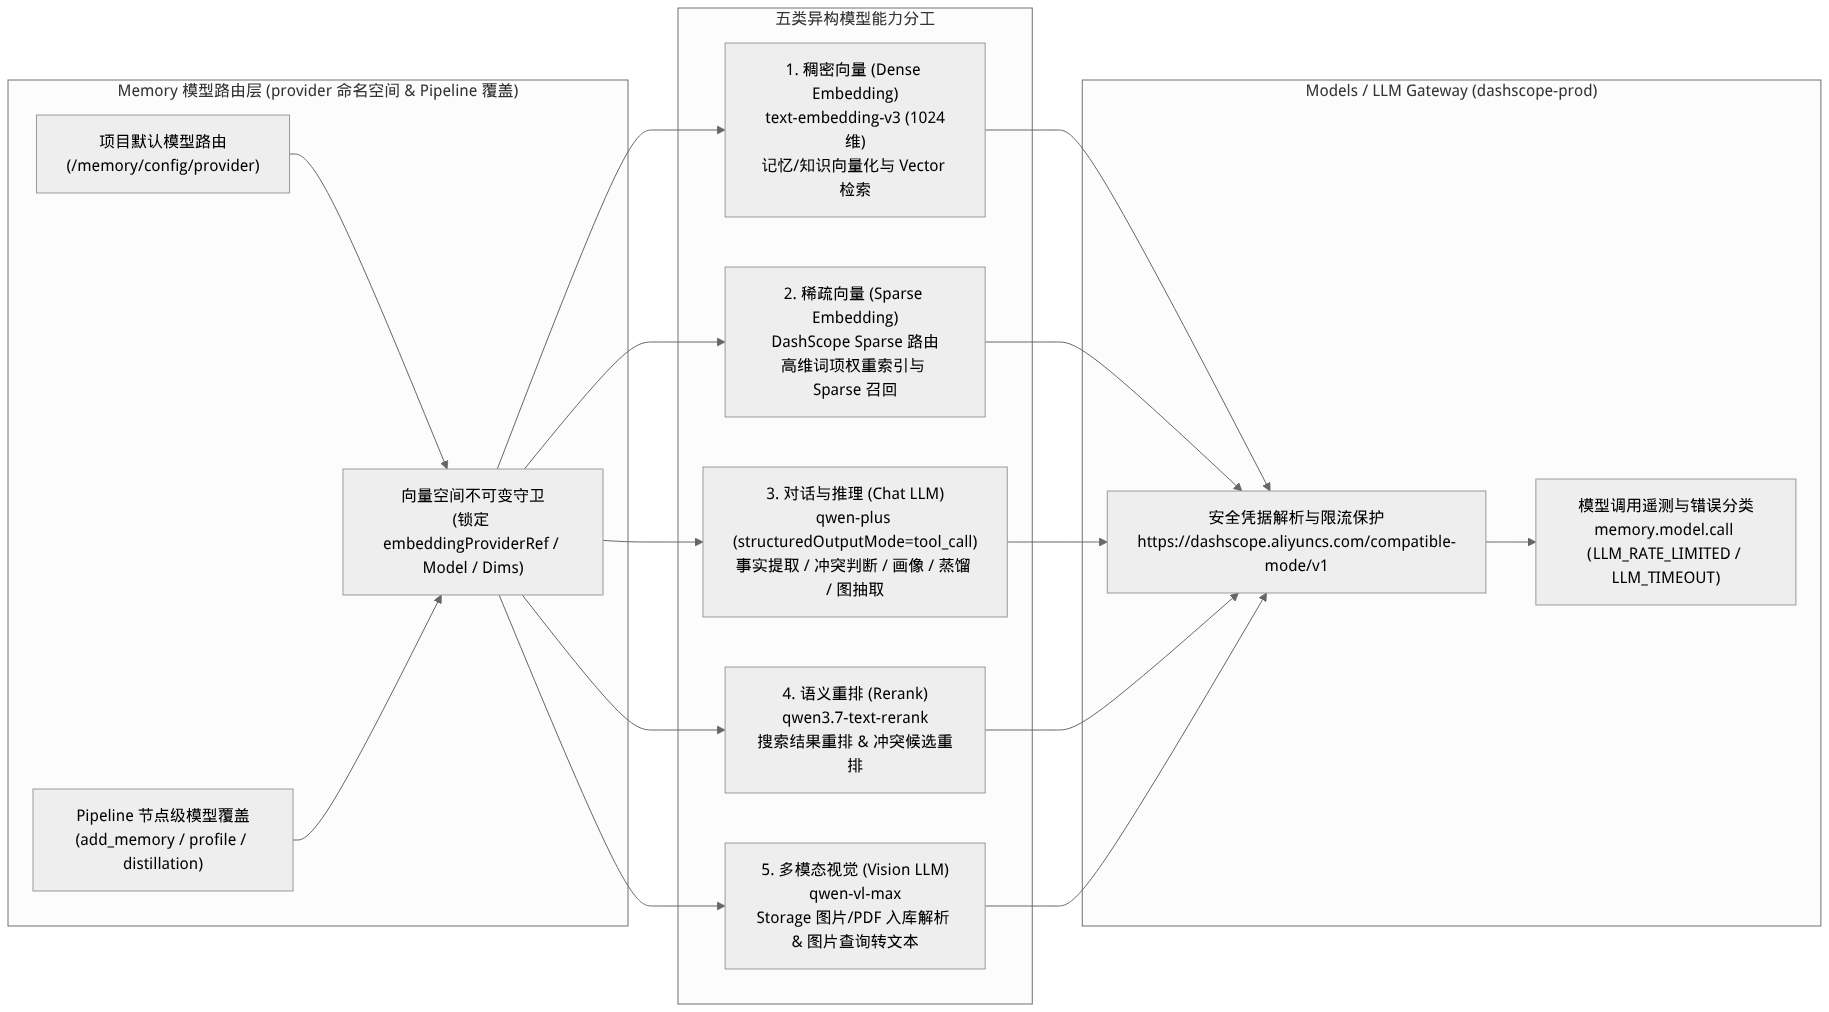
流程示意,不是运行截图;按箭头阅读步骤或状态之间的关系。
五类模型能力与职责对照表
| 模型能力类别 | provider 配置字段 | 示例项目配置值 (dashscope-prod) | 作用的业务阶段与降级/失败行为 |
|---|---|---|---|
| 稠密向量(Dense Embedding) | embeddingProviderRefembeddingModelembeddingDims | project:dashscope-prodtext-embedding-v31024 | 负责普通记忆、L2/L3 上下文、Experience 与 Skill 的向量化及 vector/hybrid 检索。项目初始化后这三个字段永久锁定。 |
| 稀疏向量(Sparse Embedding) | sparseEmbeddingEnabledsparseEmbeddingProviderRefsparseEmbeddingModel | trueproject:dashscope-prodtext-embedding-v3(Sparse 路由) | 负责生成稀疏词项权重向量,支撑 sparse 与 hybrid 检索路线。新启用向导默认开启;若提供方不支持稀疏向量可显式关闭。 |
| 对话与推理(Chat LLM) | llmProviderRefchatModelstructuredOutputMode | project:dashscope-prodqwen-plustool_call | 负责 infer=true 事实抽取、ADD/UPDATE/DELETE/NONE 冲突判断、Graph 实体边提取、查询改写、用户画像与经验蒸馏。支持 tool_call(推荐)与 legacy_json。 |
| 语义重排(Rerank) | rerankProviderRefrerankModel | project:dashscope-prodqwen3.7-text-rerank | 负责在检索阶段对多路融合候选重排(需同时开启 policy.rerankEnabled),以及在新增记忆冲突检测时重排相似记忆候选。重排异常时在响应 degraded.rerank 中标记降级。 |
| 多模态视觉(Vision LLM) | visionProviderRefvisionModel | project:dashscope-prodqwen-vl-max | 独立于文本 Chat 模型,专门用于解析 Storage 图片(PNG/JPEG/WebP)与 PDF 文档,或在图片搜索时将图片转为文本描述。必须成对配置,未配置时拒绝媒体输入。 |
功能入口与权限矩阵
控制台入口与管理权限
控制台入口位于:项目 enterprise-ai-hub-210 → 记忆(Memory) → 模型 页签(内部复用配置中心的 provider 命名空间视图)。
| 操作动作 | 入口位置 | 底层 REST API | 所需权限 | 关联关系 |
|---|---|---|---|---|
| 登记上游模型 Provider | 左侧导航栏 Models(模型网关) | /v1/llm-gateway/providers | projects.write | 为 Memory 提供可选的 project:<providerId> 目录 |
| 查看当前 Memory 模型路由 | 记忆 → 模型 页签 | GET /v1/projects/{projectId}/memory/config/provider | projects.read | 返回当前 configVersion、etag 与 editableValue 可编辑配置 |
| 更新默认模型路由 | 记忆 → 模型 → 保存配置 | PUT /v1/projects/{projectId}/memory/config/provider | projects.write | 须携带 expectedConfigVersion 乐观锁版本号 |
| 覆盖单条 Pipeline 模型路由 | 记忆 → 配置 → 各场景 Pipeline | PATCH /v1/memory/pipelines/{pipelineId} | projects.write | 未勾选覆盖时自动继承本页的 provider 默认路由 |
默认路由与自定义 Pipeline 路由的继承关系
继承与覆盖规则: 在 记忆 → 配置 的四类 Pipeline(新增记忆、画像、经验与技能、遗忘)中,各节点(如事实抽取、冲突判断、画像生成)可单独指定模型路由;若取消勾选节点级路由覆盖,则自动继承本页(
provider命名空间)配置的默认路由(取消勾选代表“继承默认”,而非“禁用该能力”)。共享模型路由快照: 当前项目的默认新增记忆 Pipeline 中配置的共享
embedding、rerank与vision路由,还会同时作用于在线记忆检索(search)、统一召回(recall)、图片查询解析以及后台补索引任务。异步任务在受理入队瞬间会冻结当时的模型路由快照(但不含明文密钥),确保重试期间行为一致。
功能详解与操作指南
1. 在控制台查看与调整 Memory 模型路由
登录 Agentbase 控制台,进入项目
企业智能客服与知识中台(enterprise-ai-hub-210)。在左侧模型中确认已添加所需提供商,且项目具有可用的向量模型;对话、稀疏向量、重排和视觉模型按实际功能需要配置。下列模型和提供商名称均为示例。
打开左侧 记忆(Memory) 并切换到 模型 页签。
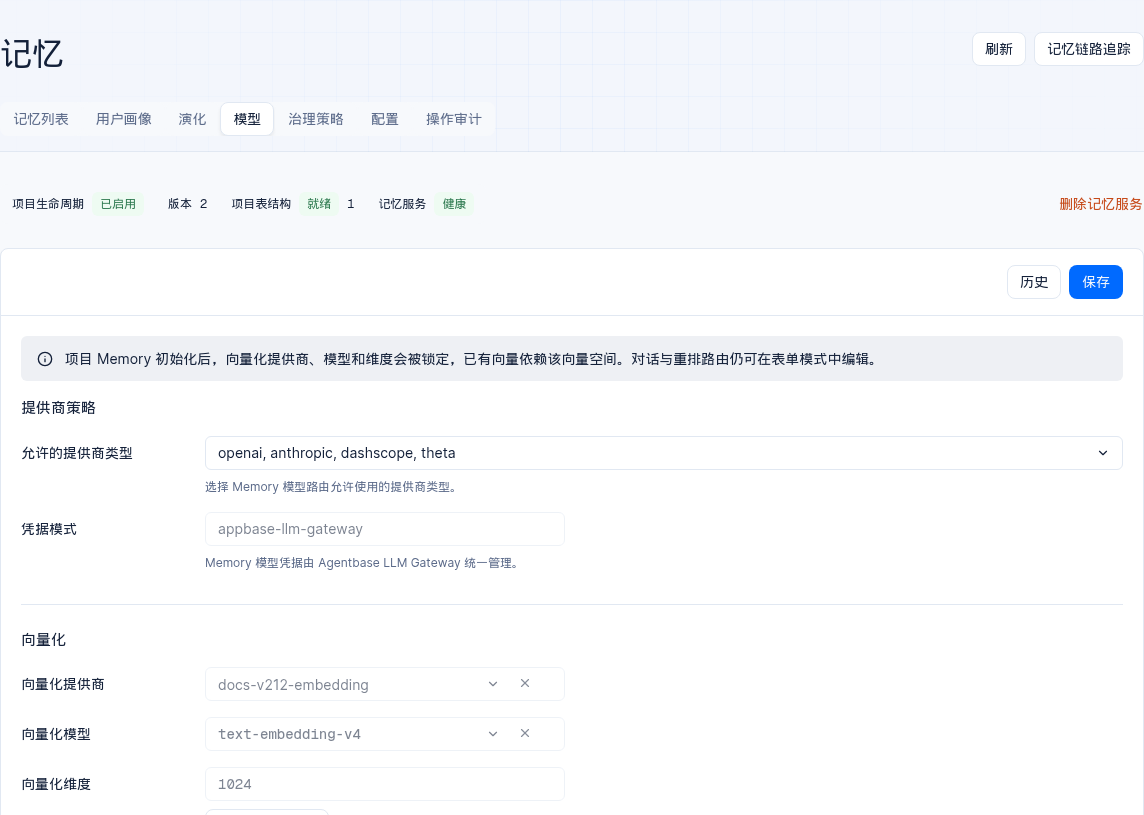
图:2.12.0 测试项目中的页面状态;具体内容取决于项目配置。
按业务需求配置或调整可编辑的模型路由字段:
Embedding 路由(只读锁定):页面显示
embeddingProviderRef(project:dashscope-prod)、embeddingModel(text-embedding-v3)与embeddingDims(1024)处于锁定状态,防止破坏 OceanBase 既有向量表空间。稀疏向量(Sparse Embedding):勾选开启并绑定
project:dashscope-prod的稀疏向量模型。Chat 模型路由:按需要选择可用提供方与对话模型,例如
project:dashscope-prod和qwen-plus。结构化输出模式(structuredOutputMode)须与模型能力匹配。Rerank 模型路由:选择提供方
project:dashscope-prod与模型qwen3.7-text-rerank。视觉模型路由(Vision LLM):成对选择
visionProviderRef(project:dashscope-prod)与visionModel(qwen-vl-max)。注意:只填其中一项无效,必须成对配置并保存后,项目才接受 Storage 图片/PDF 记忆写入。
填写变更原因(
reason)并单击 保存。
2. provider 配置命名空间完整参数规范
通过控制面 API 读写 /v1/projects/{projectId}/memory/config/provider 时,完整字段定义如下:
| 字段名 | 类型 | 初始化后可否修改 | 标杆配置示例 | 校验规则与详细说明 |
|---|---|---|---|---|
allowedProviders | string[] | 可修改 | ["openai", "dashscope", "anthropic", "theta"] | 允许项目 Memory 使用的上游提供方类型白名单。 |
credentialMode | string | 固定取值 | "appbase-llm-gateway" | 固定通过项目 LLM Gateway 解析凭据,禁止在请求中内联明文密钥。 |
embeddingProviderRef | string | 不可变(Immutable) | "project:dashscope-prod" | 稠密向量提供方引用。Memory 初始化后修改会触发 400/409 不可变守卫拦截。 |
embeddingModel | string | 不可变(Immutable) | "text-embedding-v3" | 稠密向量模型标识,初始化后永久锁定。 |
embeddingDims | integer | 不可变(Immutable) | 1024 | 向量物理列维度,必须与模型实际输出维度一致,初始化后永久锁定。 |
sparseEmbeddingEnabled | boolean | 可修改 | true | 是否开启稀疏向量索引与稀疏检索分支。 |
sparseEmbeddingProviderRef | string | 可修改 | "project:dashscope-prod" | 稀疏向量提供方引用(开启稀疏向量时必填)。 |
sparseEmbeddingModel | string | 可修改 | "text-embedding-v3" | 稀疏向量模型标识。 |
llmProviderRef | string | 可修改 | "project:dashscope-prod" | 默认对话与推理模型提供方引用。 |
chatModel | string | 可修改 | "qwen-plus" | 默认对话与推理模型名称。 |
structuredOutputMode | string | 可修改 | "tool_call" | 结构化输出协议,支持 "tool_call"(推荐,强制 Schema)与 "legacy_json"。 |
rerankProviderRef | string | 可修改 | "project:dashscope-prod" | 默认重排模型提供方引用。 |
rerankModel | string | 可修改 | "qwen3.7-text-rerank" | 默认重排模型名称。 |
visionProviderRef | string | 可修改 | "project:dashscope-prod" | 多模态视觉模型提供方引用,须与 visionModel 成对设置。 |
visionModel | string | 可修改 | "qwen-vl-max" | 多模态视觉模型名称,用于解析 Storage 图片与 PDF。 |
3. 通过控制面 API 查询与更新模型路由示例
更新项目配置属于控制面操作,需要 Console 管理员会话(或管理员 JWT + X-Appwrite-Mode: admin)。先读取实际的 editableValue、configVersion 和 schemaVersion,保留已有向量配置后再按需更新;示例中的视觉模型须在当前项目中可用:
(
  set +x
  set -e -o pipefail
  : "${APPBASE_CONSOLE_SESSION:?Set APPBASE_CONSOLE_SESSION}"
: "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the target API endpoint including /v1}"
APPBASE_ENDPOINT="${APPBASE_ENDPOINT%/}"
: "${APPBASE_PROJECT_ID:?Set APPBASE_PROJECT_ID for the target environment}"
: "${APPBASE_CONSOLE_SESSION:?Set APPBASE_CONSOLE_SESSION for the target environment}"

# 1. 读取当前配置及版本;保留现有向量模型字段
PROVIDER_RESP="$(builtin printf 'Cookie: %s\n' "$APPBASE_CONSOLE_SESSION" | curl --disable --header @- -fsS -w '\n%{http_code}' "${APPBASE_ENDPOINT}/projects/${APPBASE_PROJECT_ID}/memory/config/provider" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Mode: admin")"
case "${PROVIDER_RESP##*$'\n'}" in
  2??) PROVIDER_RESP="${PROVIDER_RESP%$'\n'*}" ;;
  *) builtin printf 'Configuration read returned a non-2xx response\n' >&2; exit 1 ;;
esac
CURRENT_VERSION="$(printf '%s' "${PROVIDER_RESP}" | jq -er '.configVersion')"
SCHEMA_VERSION="$(printf '%s' "${PROVIDER_RESP}" | jq -er '.schemaVersion')"
CURRENT_VALUE="$(printf '%s' "${PROVIDER_RESP}" | jq -ec '.editableValue | objects')"

# 2. 选择当前项目中可用的视觉模型并构造更新
: "${VISION_PROVIDER_REF:?Set a provider available in the project}"
: "${VISION_MODEL:?Set a vision model available in the project}"
UPDATE_BODY="$(jq -n --argjson version "${CURRENT_VERSION}" \
  --argjson schema "${SCHEMA_VERSION}" --argjson value "${CURRENT_VALUE}" \
  --arg provider "${VISION_PROVIDER_REF}" --arg model "${VISION_MODEL}" \
  '{expectedConfigVersion: $version, schemaVersion: $schema,
    reason: "Configure vision route",
    value: ($value | .visionProviderRef = $provider | .visionModel = $model)}')"

# 3. 提交完整可编辑配置,版本冲突时重新读取并检查
builtin printf 'Cookie: %s\n' "$APPBASE_CONSOLE_SESSION" | curl --disable --header @- -fsS -X PUT "${APPBASE_ENDPOINT}/projects/${APPBASE_PROJECT_ID}/memory/config/provider" \
  -H "X-Appwrite-Project: ${APPBASE_PROJECT_ID}" \
  -H "X-Appwrite-Mode: admin" \
  -H "Content-Type: application/json" \
  --data "${UPDATE_BODY}" | jq .
)
常见问题与排障(FAQ)
1. 为什么项目启用 Memory 后,不能在“模型”页签中直接修改 Embedding 模型或向量维度?
原因分析:OceanBase 中的项目记忆向量表在初始化时已按
embeddingDims(如1024)创建了定长物理向量列与 HNSW 索引,且存量记忆的向量数据均位于原模型(如text-embedding-v3)的语义空间内。即使两个不同模型的输出维度恰好相同(例如均为 1024 维),它们的向量空间也互不兼容,直接混用会导致余弦相似度计算完全失真。因此MemoryConfigAction中的IMMUTABLE_EMBEDDING_FIELDS守卫在初始化后严格锁定embeddingProviderRef、embeddingModel和embeddingDims。解决措施:若因业务演进确需更换底层 Embedding 模型或维度,请先导出备份当前项目的记忆数据,然后永久删除当前项目 Memory 实例并重新初始化,再将历史记忆重新导入以重建全量向量索引。
2. 在模型页签配置了 qwen3.7-text-rerank 重排模型,为什么搜索结果响应中仍没有触发 Rerank?
原因分析:在 模型(
provider) 页签配置rerankProviderRef和rerankModel只是登记了可用的重排模型路由;搜索链路是否默认启用重排,还受 配置 → 基础配置(policy命名空间) 中的policy.rerankEnabled布尔开关控制(默认为false)。解决措施:前往 记忆 → 配置 → 基础配置,将 搜索重排开关(
policy.rerankEnabled) 开启并保存。注意区分:新增记忆 Pipeline 中的rerankEnabled仅控制写入阶段的“冲突候选重排”,不代替在线搜索的重排开关。
3. 异步写入或蒸馏任务报错 LLM_RATE_LIMITED、LLM_INVALID_JSON 或 LLM_REQUEST_REJECTED 时如何处理?
原因分析:
LLM_RATE_LIMITED(对应 Gateway HTTP 429)与LLM_TIMEOUT/LLM_PROVIDER_UNAVAILABLE属于可重试暂态错误(retryable: true),后台 Worker 会按指数退避自动从持久化 Checkpoint 恢复重试(最多 5 次);LLM_INVALID_JSON表示 Chat 模型返回的文本不符合 Memory 要求的 JSON 结构,若当前structuredOutputMode为legacy_json,偶发格式漂移会导致校验失败;LLM_REQUEST_REJECTED表示上游提供方以不可恢复的 4xx 拒绝请求(如模型名称拼写错误、欠费或不支持该能力),不会自动重试。
解决措施:建议将支持 Function Calling 的模型(如
qwen-plus)的structuredOutputMode切换为tool_call;若遇LLM_REQUEST_REJECTED,请前往 模型网关 检查dashscope-prod的模型标识与账户配额,并通过记忆页面的链路追踪入口查看memory.model.call观测节点的gatewayStatus与errorCode。