
知识库
这是什么 / 何时用
Knowledge Bases 提供托管 RAG 管线:上传/导入文档 → 解析与切片 → Embedding → 入向量库 → 检索(vector / fulltext / hybrid,可选 rerank)。2.6.0 的富文档 RAG 支持 PDF(文本层 / 逐页 VLM / MinerU)、Office 文档(DOC/DOCX/PPT/PPTX 直接提取或转 PDF 后解析)、表格(CSV/TSV/XLS/XLSX 结构化提取)、图片资产与可选图片理解;Python Server SDK 15.4.0 补齐了 Knowledge Bases 的完整 surface。
前置
模型与解析器
项目已配置可用的 LLM Gateway embedding 模型(可选 rerank / VLM):创建 KB 时按模型名精确匹配,Gateway 无此模型或 Provider 未激活则创建失败。
documentParser 取值 text / vlm / mineru(默认 vlm;vlm 必须配可用 visionModel;旧值 auto 会被拒绝;MinerU 不可用时不要自动换解析器)。
权限范围
| 权限范围 | 用途 |
|---|---|
| 知识库 | knowledgebases.read(读/检索)、knowledgebases.write(写/摄取) |
| 项目词库 | 词库管理需 lexicons.read(读取词库、词条、引用与预览)与 lexicons.write(创建/更新/删除词库与词条、导入词条) |
知识库词库绑定(GET/PUT /v1/knowledgebases/{knowledgeBaseId}/lexicons)同时校验目标知识库的读写权限与所绑定词库的读取权限;浏览器用用户 Session,不持项目 API Key。
使用骨架
1. 创建知识库
create({ name, embeddingModel, ... }) 创建 KB——创建后 embeddingModel 不可改;探测失败即创建失败(换模型名或先激活 Provider)。
2.9.0 起可选 embeddingDimension(1–65535:对所选模型探测校验,与模型输出维度不符则创建失败)与 tracingEnabled(摄取追踪开关,记录解析 / 分块中间产物供解析评估使用;依赖平台管理员全局开关,开启后需重新摄取才有完整证据)。
2. 摄取文档并等待就绪
摄取文档:createDocument + createIngestion({ documentId, ... })(或批量 createDocumentsBatch);ingestion 状态机 queued → running → ready | failed | cancelled,轮询 getIngestion。createIngestion 返回 HTTP 202 只表示任务已受理,不表示立即可检索;确认 ingestion 为 ready,且 Document 的 status=ready、activeGeneration 与该 ingestion 的 generation 一致后,再按新代检索。
parser 配置(parserId + parserConfig)决定切片方式,常用参数见下节。
3. 配置图片理解(可选)
(可选)图片理解:在 imageUnderstanding 配置 enabled / model / providerRef / prompt / 上限参数——这是解析后的独立步骤,为有信息量的图片生成描述并加入检索文本,但不修改原始 chunk 的 content/span/locator。
4. 配置与绑定词库(可选)
(可选)词库(Lexicon)配置与绑定:通过 /v1/lexicons 创建项目词库(如企业同义词词典 lex_enterprise_synonyms、客服停用词词典 lex_support_stopwords),调用 /v1/lexicons/{lexiconId}/entries 维护 synonym / expansion / stop 三类词条(或经 /v1/lexicons/{lexiconId}/import 批量导入 JSON/CSV/XLSX),使用 /v1/lexicons/{lexiconId}/preview 预览 native-v1 分词与查询改写效果,最后调用 PUT /v1/knowledgebases/{knowledgeBaseId}/lexicons 绑定至目标知识库(如 kb_enterprise_support)并开启 enabled: true。
5. 检索与答案合成
检索:createSearch(单库)与 createMultiSearch(多库),传 query、searchMode(默认 hybrid;参数名是 searchMode,不要用 mode)、limit、similarityThreshold、vectorWeight、rerank / rerankModel。
2.9.0 起可传 answer: true 启用答案合成:用知识库 indexingDefaults 的 chat 模型对合并证据做接地合成(最多 12 行证据、答案 ≤1024 tokens),结果带 answer(状态 / 文本 / 模型 / 延迟)。
2.10.0 起检索可传 documentTag(服务端 2.12.0 支持多标签及按完整段筛选结构化定位值)与 subProductId(AND 语义)收窄切片 / GraphRAG / Wiki 召回;createMultiSearch 另支持 metadataFilter(按库分键,"*" 兜底)与 offset(融合排序后分页)。文档登记(createDocument)/ 更新(updateDocument)可写 documentTag / subProductId;仅创建支持 sectionCode,listDocuments 支持 documentTag / subProductId 过滤;任一过滤值非空时,列表接口忽略 queries(含分页、排序和其他查询),但 status / stage / enabled 仍生效。
6. 核对原文来源
溯源:结果 chunk 带 content、source(原文 URI)与 locator(章节/文本偏移);读原文 getDocumentSource 支持 Range/206,只需 knowledgebases.read。
7. 全量重建
全量重建:createReindex(返回 202,有界批量重摄取入口;不改变 embeddingModel)。
8. 构建增强索引(可选)
(可选)增强索引:updateIndexCapability 配置并启用 GraphRAG / RAPTOR / Wiki → createIndexOperation 异步构建 → 轮询 operation 终态;Wiki 页面 / 版本 / 提案 / 冲突与图谱浏览见 wiki.md。
接入流程图
下图概括“创建知识库 → 摄取文档 → 等待就绪 → 检索 → 核对原文”的完整路径,便于对照前面的 SDK 调用步骤。图中的 Models、Documents、Search 和 View source 是 Console 入口;通过 SDK 接入时,分别使用本文及文档与摄取、检索与原文中的方法。
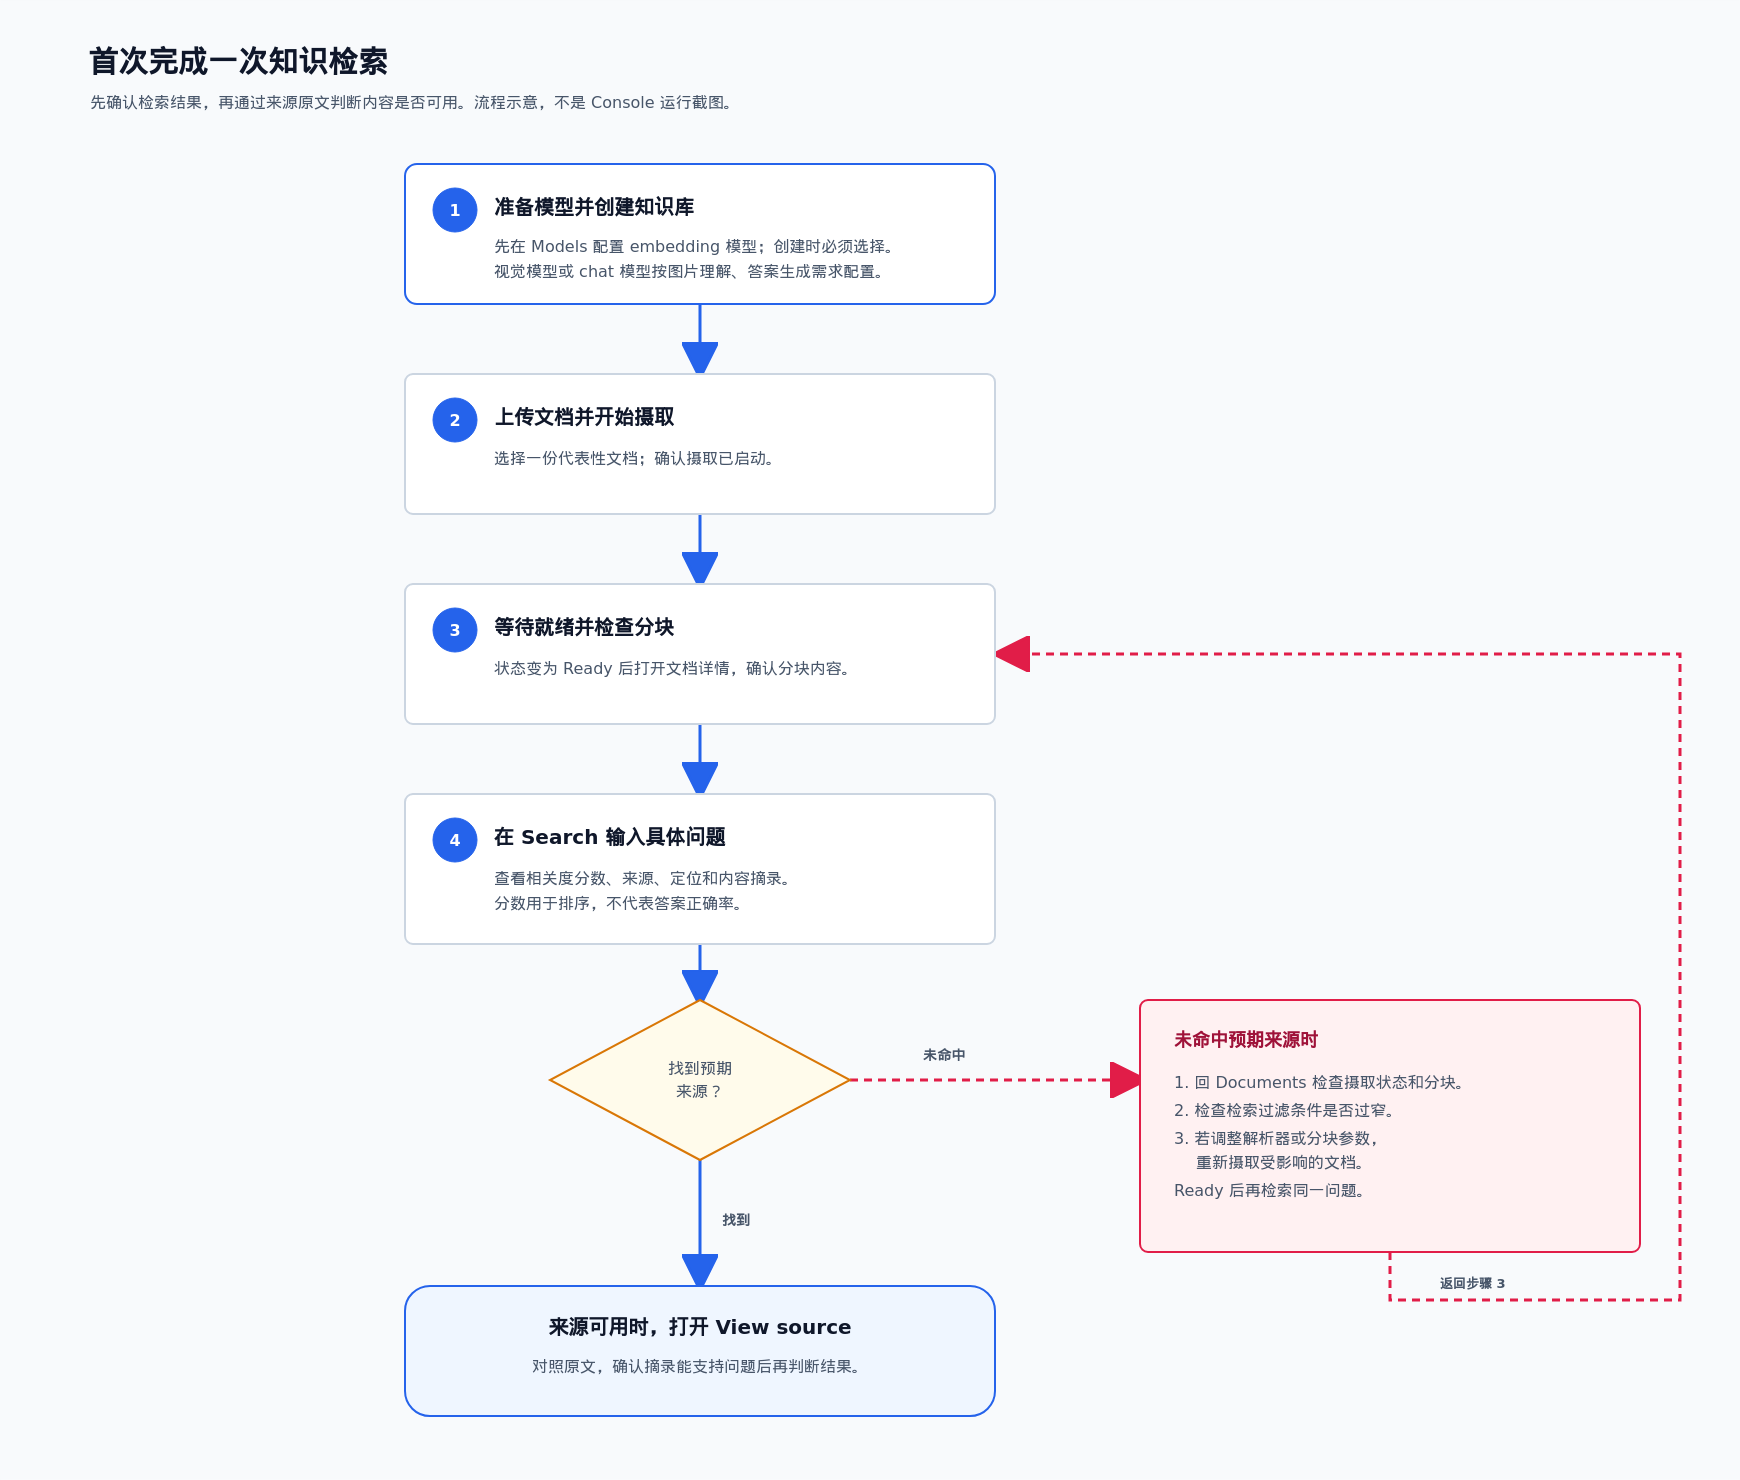
流程示意,不是运行截图。先确认文档就绪,再检索并核对来源;需要查看文字细节时可打开大图。
资源模型与增强能力
资源关系
资源模型:KB(创建时必填 embeddingModel,服务端对 LLM Gateway 做一次 embedding 探测自动得到维度,并自动创建配套的向量库与 Storage 资源)→ Document → generation(每次成功摄取产生一代,检索只返回活跃代)→ ingestion(异步任务)→ chunk(切片,检索的基本单元);数据源(datasource,当前为语雀)可同步文档进同一管线。
增强索引
2.7.0 起在基础 RAG 之上新增增强索引:GraphRAG(实体图谱)、RAPTOR(摘要树)与 LLM Wiki(canonical Wiki 页面、版本、提案与冲突治理),以及配套的索引能力配置与异步构建操作——管理面与各语言调用见 Wiki 与 GraphRAG(索引治理);检索侧经 useKnowledgeGraph / useWiki / allowDegraded 接入增强结果。
项目级词库
2.10.0(对齐 release-2.10.2 基线)新增项目级词库(Lexicon)与知识库绑定:通过 /v1/lexicons 管理同义词(synonym)、关联扩展词(expansion)与停止词(stop)词条,并经 /v1/knowledgebases/{knowledgeBaseId}/lexicons 绑定到知识库。
绑定启用后,单库与跨库检索会在进入向量/全文召回前基于 native-v1 分词策略自动完成同义词归一化与扩展词增补(无需重建文档向量);若在知识索引配置中开启 lexiconEnabled,GraphRAG 图谱构建还会复用所绑定的词库对抽取出的实体与关系端点做确定性标准名归一化。
关键参数与返回
常见问题:知识库检索可以用 mode 吗?
不能。KnowledgeBases.createSearch 和 createMultiSearch 的检索模式字段名是 searchMode;mode 不能替代这个 SDK/API 请求字段。问“为什么要使用 searchMode”时,原因就是接口契约定义的参数名为 searchMode。
parserId:general(默认)/title/smart/regex/faq/sheet(2.7.0 新增,Excel 专用,详见文档与摄取)。常用parserConfig:chunkTokenNum默认 512(摄取时必须 ≥1);overlapPercent默认 10(0–99,执行上限 90);titleLevel默认 2(1–6);minChunkTokens默认 128(不得大于chunkTokenNum);regexPattern默认[.!?]+\s*(PCRE)。imageUnderstanding:prompt≤4000 字符;maxImagesPerDocument默认 20(1–20);maxDescriptionChars默认 800(1–800);maxConcurrency默认 4(1–8)。检索:
limit默认 10(1–100);similarityThreshold0–1;vectorWeight常见 0.7(默认取 KB 的 retrievalDefaults);rerank=true时先扩大召回再经 Gateway rerank,rerankModel未指定时自动选择。显式指定rerankModel或rerankProviderRef的调用异常会返回错误;两者均未指定的自动选择失败可降级并返回reranked: false。Document 级
parserConfig非空时整体替换 KB 默认(非逐字段合并);ingestion 的overrides.parserConfig再做浅合并。词库(Lexicon)参数契约:
tokenizerProfile:固定为native-v1(UTF-8 Unicode 小写归一化;ASCII 字母/数字/下划线连续成词,中文字符逐字成 token,按集合包含匹配,无二阶递归触发)。entryType:synonym(同义词组,terms首个词为标准名,其余为同义词;首次连续原文命中时原位补充全角括号OB(OceanBase))、expansion(扩展词,命中terms首词后在末尾追加命中词:expansions)、stop(停止词,用于智能体工作台拦截;知识库直接检索忽略停止词)。每条词条terms与expansions各最多 100 项,单项 1–256 字符。知识库词库绑定(
PUT /v1/knowledgebases/{knowledgeBaseId}/lexicons):请求体为{ enabled: boolean, bindings: [{ lexiconId: string, priority: number }] }(按priority升序执行,单资源最多 100 个绑定;词库对象本身无enabled字段,启停完全由资源绑定侧的enabled与知识索引侧的lexiconEnabled独立控制)。
错误与边界
ingestion 返回 409:同文档已有进行中任务(单文档单任务并发控制),或 overrides 试图修改 embedding——等任务结束或取消,不要在 overrides 里改 embedding。
改 KB 的 parser 配置不会静默重写历史 chunk;只有新摄取或显式重摄取才会用新解析/图片描述。
词库规则变更实时作用于后续查询改写,无需重建文档向量;但若用于 GraphRAG 图谱构建词库增强(
lexiconEnabled: true),修改词条或更换绑定后必须重新触发 GraphRAG 索引构建才会更新既有图谱实体。仍被知识库或智能体绑定的词库禁止删除(
DELETE /v1/lexicons/{lexiconId}返回冲突错误),须先通过/v1/lexicons/{lexiconId}/references查询引用并解除绑定后再删除。检索空结果常见原因:文档未 ready、阈值过高、generation 未激活。
列表
total不完全套用queries[]过滤,不要当精确命中数用。删除 KB 会异步拆除其绑定的向量库并清理词库绑定;不要手工删除 KB 占用的底层资源。
SDK 类别差异
Server SDK(server-sdk/nodejs.md):全集——KB/Document/Chunk/Ingestion/DataSource/搜索(单库 + 多库)/语雀;2.7.0 起 Node / Python / Go / Java 还覆盖 Knowledge Index 与 Wiki 管理面(见 wiki.md)。Node Server SDK 2.12.0 提供
Lexicons服务;也可通过 REST 访问词库和知识库绑定。客户端 SDK(client-sdk/web.md):仅语雀 OAuth 会话相关方法(授权、列出文档、创建语雀文档、删除凭据);完整 RAG 流程放服务端,Wiki / GraphRAG / 索引治理 / 词库管理也不进浏览器。
Console SDK(console-sdk/nodejs.md):Node Console SDK 2.12.0 提供
Lexicons服务封装(list/create/get/update/delete/listEntries/createEntry/preview/importEntries/exportEntries/listReferences/getKnowledgeBaseBindings/updateKnowledgeBaseBindings);Java Console SDK 有KnowledgeBases服务(2.7.0 起 Java / Python / Go 的 console 包与 Server 面同构,含 Wiki / 索引治理)。Python Server SDK 15.4.0 补齐 Knowledge Bases surface(安装产物核验见 integration.md)。
各语言调用示例
创建知识库示例在本页;摄取与数据源见文档与摄取,检索与溯源见检索与溯源。每个卡片可切换语言(全页同步)。
创建知识库
建库为同步调用,配套 VectorsDB / Storage 资源在 provision 中异步就绪。Web(用户 Session)面无 KB 管理能力(仅语雀 OAuth 相关方法),故本卡不设 Web 页签。
- Node.js(Server)
- Java
- Python
- Go
- REST(curl)
import { KnowledgeBases, ID } from 'agentbase-node-sdk';

const kb = new KnowledgeBases(client);

const base = await kb.create({
    knowledgeBaseId: ID.unique(),        // 自定义或 ID.unique()
    name: '产品手册',
    embeddingModel: 'text-embedding-v3'  // 创建时对 Gateway 探测一次维度,之后不可改
});KnowledgeBases kb = new KnowledgeBases(client); // client 初始化见 server-sdk/java.md
var base = kb.create(ID.unique(), "产品手册", "text-embedding-v3",
null, null, null, null, null, null); // description / embeddingProviderRef / parserId / parserConfig / retrievalDefaults / ingestRoutes
// 创建时对 Gateway 探测一次维度,之后 embeddingModel 不可改from agentbase.id import ID
from agentbase.services.knowledge_bases import KnowledgeBases # 15.4.0 起补齐 KB 调用面
kb = KnowledgeBases(client)
base = kb.create(knowledge_base_id=ID.unique(), name='产品手册',
embedding_model='text-embedding-v3') # 创建时对 Gateway 探测一次维度,之后不可改kb := agentbase.NewKnowledgeBases(cl) // facade 构造器;cl 为已装载 API Key 的 Client
base, err := kb.Create(id.Unique(), "产品手册", "text-embedding-v3") // 创建时对 Gateway 探测一次维度,之后不可改
// 其余可选参数经 With* 选项:WithCreateDescription / WithCreateParserId / WithCreateParserConfig(interface{} 装载)等curl -sS -X POST "$APPBASE_ENDPOINT/knowledgebases" \
-H 'Content-Type: application/json' \
-H "X-Appwrite-Project: $APPBASE_PROJECT_ID" \
-H "X-Appwrite-Key: $APPBASE_API_KEY" \
-d '{"knowledgeBaseId":"kb_product_docs","name":"产品文档库","embeddingModel":"text-embedding-v3"}'
# 201 返回 embeddingDimension 与自动开通的 vectorsdbDatabaseId / vectorsdbCollectionId / bucketId
# provision 异步:这些字段可能短暂为 null,稍后 GET /knowledgebases/{kbId} 确认词库(Lexicon)管理与知识库绑定
通过 /v1/lexicons 创建项目级词库、写入同义词/扩展词/停止词词条并预览 native-v1 查询改写结果,再通过 PUT /v1/knowledgebases/{knowledgeBaseId}/lexicons 将词库绑定到知识库(如 kb_enterprise_support)。Node Server SDK 和 Node Console SDK 的 2.12.0 发布包均提供 Lexicons 服务。以下 REST 示例适用于直接发请求的服务端应用。
使用 Bash,将 APPBASE_ENDPOINT 设置为目标 API 的 HTTPS 地址(含 /v1),并提供同一项目的 APPBASE_PROJECT_ID 和 APPBASE_API_KEY。查询与预览用 lexicons.read,写入词库和绑定用 lexicons.write,读取和更新绑定分别需要目标知识库的读取和更新权限。先定义下面的 Bash 函数,再在同一终端按需单独执行各步骤。函数仅接受 2xx 响应。Python 可参考服务端 HTTP 示例配置关闭自动跳转的客户端。
lexicon_request() (
  set +x
  set -o pipefail
  : "${APPBASE_API_KEY:?Set APPBASE_API_KEY}"
  : "${APPBASE_PROJECT_ID:?Set APPBASE_PROJECT_ID}"
  : "${APPBASE_ENDPOINT:?Set APPBASE_ENDPOINT to the HTTPS API endpoint including /v1}"
  response="$(builtin printf 'X-Appwrite-Key: %s\n' "$APPBASE_API_KEY" |
    curl --disable --header @- --proto '=https' --silent --show-error --write-out '\n%{http_code}' \
      --request "$1" "${APPBASE_ENDPOINT%/}$2" \
      --header 'Content-Type: application/json' \
      --header "X-Appwrite-Project: $APPBASE_PROJECT_ID" "${@:3}")" || exit 1
  status="${response##*$'\n'}"
  case "$status" in
    2[0-9][0-9]) builtin printf '%s\n' "${response%$'\n'*}" ;;
    *) builtin printf 'HTTP %s\n' "$status" >&2; exit 1 ;;
  esac
)
创建词库(POST /v1/lexicons)
lexicon_request POST "/lexicons" \
  --data '{"lexiconId":"lex_enterprise_synonyms","name":"企业核心产品同义词词典","tokenizerProfile":"native-v1"}'
创建同义词词条(POST /v1/lexicons/{lexiconId}/entries)
lexicon_request POST "/lexicons/lex_enterprise_synonyms/entries" \
  --data '{"entryType":"synonym","terms":["OceanBase","OB","分布式数据库OB"]}'
预览查询改写(POST /v1/lexicons/{lexiconId}/preview)
lexicon_request POST "/lexicons/lex_enterprise_synonyms/preview" \
  --data '{"query":"OB 分布式事务怎么排障?"}'
查询知识库当前词库绑定(GET /v1/knowledgebases/{knowledgeBaseId}/lexicons)
lexicon_request GET "/knowledgebases/${APPBASE_KB_ID:?Set APPBASE_KB_ID}/lexicons"绑定词库到知识库并开启检索改写(PUT /v1/knowledgebases/{knowledgeBaseId}/lexicons)
提交完整绑定列表。以下示例仅适用于当前没有词库绑定的知识库。若已有绑定,先把仍需保留的项目合并进请求,再执行更新。
lexicon_request PUT "/knowledgebases/${APPBASE_KB_ID:?Set APPBASE_KB_ID}/lexicons" \
  --data '{"enabled":true,"bindings":[{"lexiconId":"lex_enterprise_synonyms","priority":1}]}'
示例指引
JavaScript(Node 摄取与检索):examples/javascript.md
Java(Server / Console SDK 调用写法):examples/java.md